博客
AI 资讯、算法拆解和上手教程。一共 390 篇,新写的在最上面。
- 2026/11/19AI资讯约 6 分钟读完
1200 个任务、18 天:DaisyRose-27B 把 Terminal-Bench 翻倍,训练成本还降了 57%
RadixArk 发布首个模型 DaisyRose-27B:基于 Qwen3.8-27B,只用 1200 个长程 Agent 任务、18 天、144 张 H200 做强化学习后训练,Terminal-Bench 4.1 从 5.6% 提到 12.0%,训练 GPU 时间省 57%,权重按 Apache 2.0 开源。
- 2026/11/17AI资讯约 7 分钟读完
Hugging Face 把推理路由交给 OpenRouter:开源模型已占七成流量,一个 token 跑遍 80 多家服务商
Hugging Face 把 Inference Providers 的路由交给 OpenRouter:开源模型在 OpenRouter 上的 token 占比已达 71.7%,代码不用改,一个 token 就能按实时价格、速度和可靠性在 80 多家服务商之间自动切换,失败自动重试;但自带服务商 key 不能用了。
- 2026/11/06AI资讯约 5 分钟读完
Thinking Machines 发布 Inkling 2 Small:594B 激活 17B,现仅 Tinker 可用,权重下周以 Apache 2.0 放出
东京时间 11 月 6 日早上,Thinking Machines Lab 发布第二代首款模型 Inkling 2 Small:594B 总参数、17B 激活的稀疏 MoE,支持图像输入。目前仅能通过 Tinker 使用,权重计划下周以 Apache 2.0 放出。官方自测里它在视觉和知识工作上领先、纯编程不是第一,训练细节披露也很详细。
- 2026/11/05AI资讯约 4 分钟读完
百度开源文心 ERNIE-5.5-Flash-Base:280B 仅激活 14B 的预训练终点,附结构与许可证要点
11月5日百度开源ERNIE-5.5-Flash-Base:280B总参/14B激活的稀疏MoE预训练终点,支持1M上下文,附官方自测对比、SGLang/vLLM接入与许可证地域商用门槛。
- 2026/11/05AI资讯约 5 分钟读完
webAI 开源 8B 推理模型 TwIL-8B:数学代码贴近前沿、4-bit 仅 5GB,但知识偏弱且非商用
webAI 开源 8.79B 稠密推理模型 TwIL-8B,基于 IBM Granite 4.2 8B 做全参 SFT 加 GRPO/DAPO 强化学习,厂商自测 MATH-500 98.2、LiveCodeBench 81.6,Q4 量化 4.98 GiB 可本地运行,但知识类基准明显偏弱,且为非商用许可。本文拆解成绩、训练配方和本地部署要点。
- 2026/11/05AI资讯约 5 分钟读完
5 人团队、3200 万美元从零训练:65B 稠密模型 Ripple 开源,Agent 编程追平大它 8 倍的 MoE
Ricursive Intelligence 开源 Ripple-65B Preview:65B 稠密模型、12T token 从零预训练、Apache 2.0。官方自测 Terminal-Bench 2.1 得 80.52,超过多款 500B 以上的美国开放权重 MoE;全部研发成本 3200 万美元。本文拆解训练方法、成绩口径与本地部署要点。
- 2026/11/05AI资讯约 5 分钟读完
Kimi K3.1 Pro 权重开放:2.8T 参数、1M 上下文,编程 Agent 成绩贴近闭源旗舰,附部署与许可证要点
11 月 5 日凌晨,月之暗面开放 Kimi K3.1 Pro 完整权重(约 1.56 TB)。本文拆解 KDA+稀疏注意力的混合 MoE 架构、厂商汇总的基准成绩与短板、修改版 MIT 许可证的两条限制,以及显存与 API 调用的实操要点。
- 2026/11/04AI资讯约 5 分钟读完
腾讯 Hy4 正式版发布:首次能看图、能操作电脑,API 与 preview 同价,权重即将开源
11 月 4 日,腾讯混元发布 Hy4 正式版,首次支持图片输入和 Computer Use,1M 上下文,API 与 preview 同价并已上线 OpenRouter,权重计划开源。本文整理更新要点、厂商自测跑分、价格与接入建议。
- 2026/11/02AI资讯约 5 分钟读完
MiniMax 官方点名社区量化:428B 的 M3.1 Flash 本地怎么跑、要多大内存
11 月 2 日清晨,MiniMax 官方发帖点名社区为 M3.1 Flash 做的量化与部署方案。这个 428B 总参数、激活 23B 的多模态 MoE 模型,2-bit GGUF 约 144 GB。本文整理各方案的内存需求、精度损失和本地部署建议。
- 2026/10/31AI资讯约 5 分钟读完
Nace 开源 27B 决策模型 Drex Max:不生成文字、一次前向给出全部选项概率,24GB Mac 可本地跑
Nace.AI 于 10 月 30 日开源 Drex Max v1 权重:一个 27B 多模态决策模型,输入上下文和带选项的问题,一次前向返回每个选项的概率,不生成文字。本文拆解它的非因果注意力 + 255 路读出头结构、厂商公布的成绩、各平台部署门槛(4-bit 可在 24GB Apple Silicon 上跑文本)、Open RAIL-M 许可证限制,以及适合的分类与路由场景。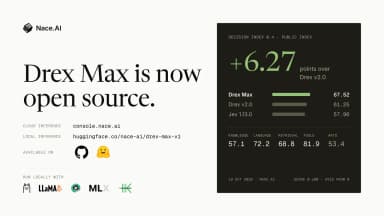
- 2026/10/30AI资讯约 5 分钟读完
Pika 开源 H3 Flex:6 步出 15 秒带声视频,附完整后训练路线和本地部署门槛
Pika 开源视频生成模型 Pika H3 Flex:基于 MiniMax H3 后训练,用 PDMD 蒸馏把采样从 50 步压到 6 步,再用 ReFL+DPO 找回画质,可生成最长 15 秒带立体声的视频,支持最多 12 个参考。本文梳理技术路线、官方评测、硬件门槛与上手建议。