11 月 12 日,Anthropic 在官网发了一篇给 Opus 5.5 的官方使用指南,标题是《把 Claude Opus 5.5 当作日常主力》。11 月 14 日,The Decoder 报道了这篇指南里最扎心的一句提醒:很多用户还在用老办法提示 Opus 5.5,结果是花更多的钱、等更久,质量还未必更好。
Opus 5.5 现在是 Claude Pro、Max、Ultra 和 Team 套餐里的默认模型。模型换代了,提示词的写法也得跟着换代——Anthropic 这次的核心建议可以浓缩成一句话:少写,写准,把怎么做留给模型自己。
一、Opus 5.5 现在是什么位置
Anthropic 在指南里先给了一张选型表,按每百万 token 的输入 / 输出价格排:
| 模型 | 适合干什么 | 价格(输入 / 输出) | 速度 |
|---|---|---|---|
| Haiku 5.5 | 快速查询、高频小任务 | $0.10 / $0.50 | 最快 |
| Sonnet 5.5 | 目标明确、brief 清晰的任务 | $2 / $10 | 快 |
| Opus 5.5 | 大多数知识工作:研究、分析、需要判断力的成品文档 | $4 / $20 | 中等 |
| Fable 5.2 | 最难的开放式技术工作,编码、金融、科学 | $8 / $40 | 中等 |
有两点值得注意。第一,Haiku 5.5 是第一个带 effort 控制的 Haiku 模型,上面那个价格只适用于 100k token 以内的提示,更长的提示按 $0.50 / $2.50 计价。第二,Anthropic 的选型建议是:效果不够,先升 effort 档位,再考虑换更大的模型;如果你总把 Sonnet 推到 Extra High 甚至 Max 档,那单任务成本已经接近 Opus 5.5,不如直接换 Opus 5.5。更强的模型往往用更少的步骤就能把活干完,选型值得按单任务总成本重新算一遍,而不是只看单价。
二、先删掉的三句旧话
指南里列了一份"改掉这些提示习惯"清单,排在前面的几条,都是很多老用户手里的肌肉记忆:
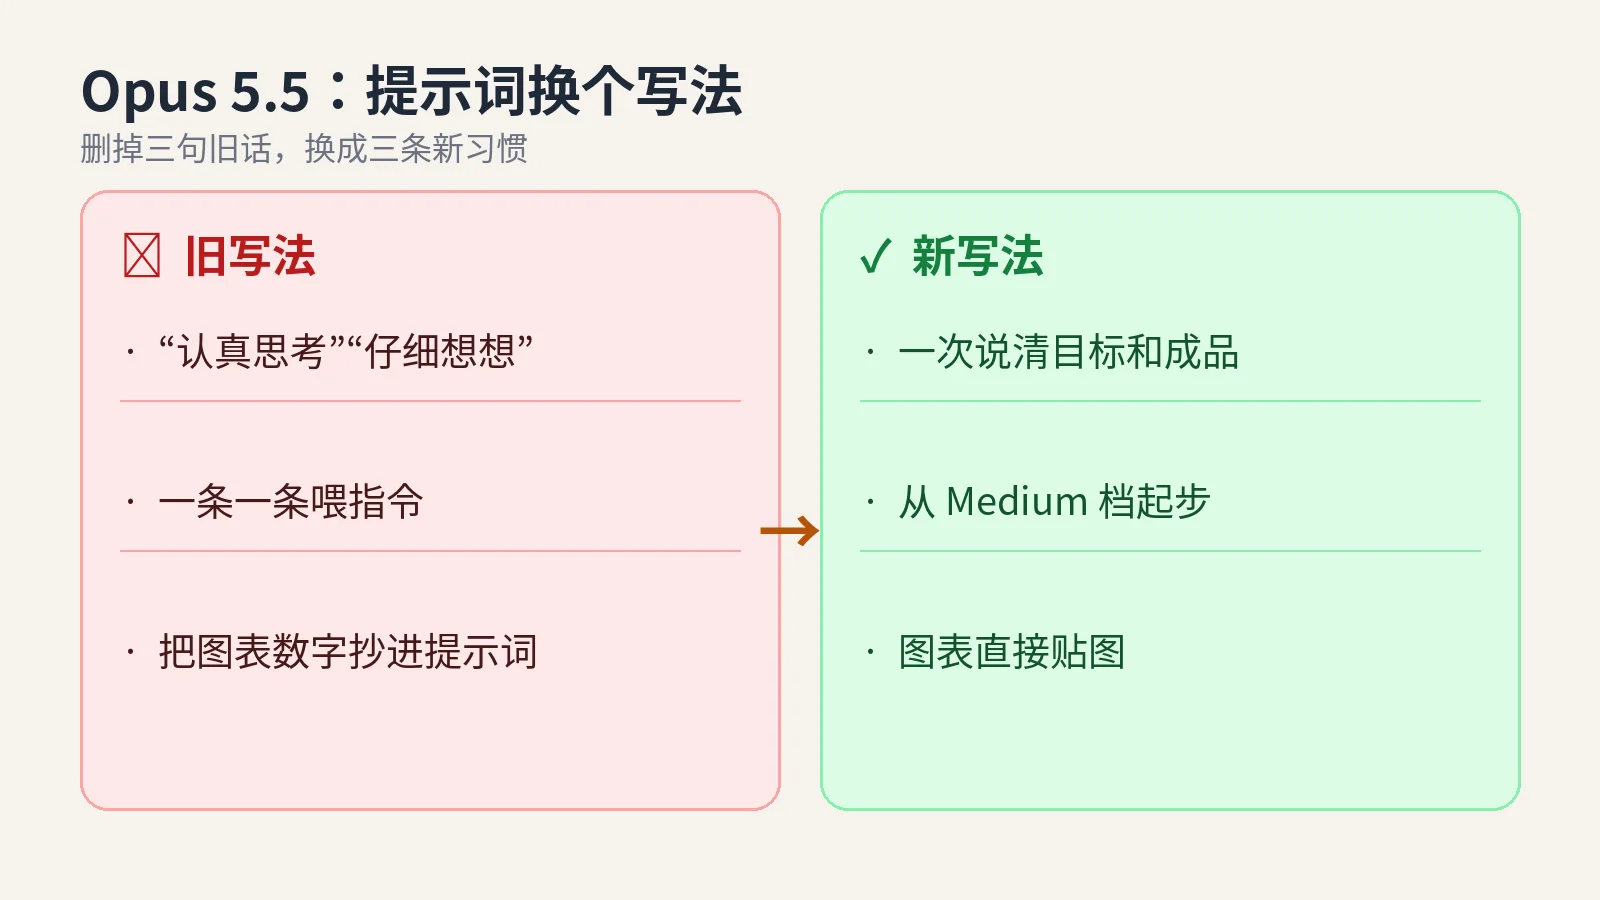
第一句:"认真思考""仔细想想"。 Opus 5.5 的思考默认就是开着的,它会按你的请求和 effort 档位自己决定想多深。Anthropic 的测试结论是:删掉这类话,回复开始得更快,质量没有可测的下降。这类说法来自推理模型刚出现的年代,现在模型自己会按需分配思考量,再写就是纯噪音,还拖慢首字时间。
第二句:一条一条喂指令。 老写法是把任务拆成一步步的指令发过去,等模型每步确认。Anthropic 建议反过来:第一条消息就把目标、成品长什么样、什么时候停下来问你,一次说清。Opus 5.5 扛多段任务的能力比上一代强,一次说清目标,比十次追问更省 token。
第三句:把图表数字抄进提示词。 以前模型读图不稳,很多人养成了先把图表数值手动转录成文字的习惯。Anthropic 说,这个变通办法现在可以扔了:直接把图表、截图或示意图本身贴上去。Opus 5.5 是目前视觉能力最好的 Opus 模型,在内部测试里,它在最低 effort 档读密集图表数值的准确度,都超过了 Opus 5 在最高档的表现。
和这三条配套的,是 effort 档位的默认值:Opus 5.5 默认 Medium。Anthropic 测到,Opus 5.5 开 Medium 就能达到甚至超过 Opus 5 开 High 的水平。档位越高想得越久、花得越多,产出未必更好,所以指南的建议是 Medium 起步,不够再升 High。
三、改成这样写才管用
删掉旧习惯之后,指南给了几条正向建议,都是可以直接抄进工作流的:
接上你的文件和系统。 这是 Anthropic 认为最管用的一步:通过 connectors 把 Claude 连到你的文件和系统上,让它自己去取任务需要的材料,而不是全靠你粘贴。Team 和 Enterprise 套餐里,管理员需要先开启 connector。
点名你不要的风格,而不是笼统地说"别通用"。 做设计类任务时,写"避免通用感"这类泛泛的禁令,模型只会把一个默认风格换成另一个默认风格。管用的写法是具体点名:不要奶油色背景、不要药丸形按钮。
给它你的 house style。 把品牌规范或写作风格指南直接贴进请求里,或者指向你最好的成品——比如 Drive 文件夹里现成的 deck,让它照着学。Anthropic 也坦言,别指望一次到位,头几轮磨合是正常的。
直接要成品。 想要表格或文档就直接要,别先要个提纲再一步步搭。Opus 5.5 经常能一次从请求走到成品。
四、Anthropic 的自测数据怎么说
指南里引用的都是 Anthropic 自己的内部测试数据,先说明这点,再看数字:
在一项研究类测试里,Opus 5.5 只拿到一份网页快照,要据此写公司季报,自动评分逐条核对每个数字和引用,错一条整份报告判失败。18 份报告里,16 份通过。模型写的东西也更清楚:最重要的信息放前面,行话更少,写长的任务时会交代自己做了什么、发现了什么、还需要什么。
另一项是金融分析:虚构的两家 HR 软件公司合并案,建 Excel 财务模型,再做成给高管看的汇报。Opus 5.5 用 63 分钟完成,Opus 5 用了 93 分钟;前者的成本只有后者的一半,模型更完整,汇报也更易读。早期测试者、Factory 公司的 Zimu Li 也说,Opus 5.5 是他们第一个愿意默认开 Medium 档的模型:Medium 档达到了 Opus 5 High 档的效果,输出 token 还少了 20%–25%。
同一周,Anthropic 工程师 Lance Martin 在 AI Engineer NYC 的分享里,从 API 一侧讲了同一件事:写给旧模型的提示词里攒下的核查仪式、啰嗦强调、手工 scratchpad 等习惯,正在让新模型变慢变贵;Claude Code 里有 prompt-audit 一类的工具,可以帮你把这些写法扫出来。在他的演示里,跑完审计后成本又降了 9%,准确率升了 2 个百分点——这是分享现场的演示数据,不是官方基准,供参考。
小杜点评
提示词也是代码,会欠技术债。模型每升一代,都值得把用了半年的 system prompt 和 claude.md 拿出来回归测试一遍:删掉那些当年为"哄"模型多想一步而加的套话,看看质量到底掉不掉——Anthropic 这次的结论是,大概率不掉,速度和账单还会变好。
对算法工程师来说,这篇指南真正值钱的不是"删掉认真思考"这一条,而是背后的选型思路:Medium 起步、不够再加档,和"先上小模型、不够再换大模型"是同一个思路,都是先测便宜的配置,再为效果付费。Sonnet 开到 Max 还不如 Opus 5.5 开 Medium,这笔账很多人还没算过。
最后提醒一句:这篇指南写的是聊天场景里的 Opus 5.5,API 场景的提示词审计是另一套工具链,别把两边的结论混着用。先从你每天用的那个聊天窗口开始改,改完跑一周,再决定要不要动 API 那边的提示词。
参考来源
- Anthropic 官方指南《Using Claude Opus 5.5 as your daily driver for knowledge work》,2026-11-12:https://claude.com/resources/articles/using-claude-opus-5-5-as-your-daily-driver-for-knowledge-work
- The Decoder《Anthropic says outdated prompting habits are slowing down Claude Opus 5.5》,2026-11-14:https://the-decoder.com/anthropic-says-outdated-prompting-habits-are-slowing-down-claude-opus-5-5/
- BetterStack《How to Prompt Claude Opus 5.5: What Changed and What to Remove》:https://betterstack.com/community/guides/ai/claude-opus-55-prompting-guide/
- Sparse Notes《Your Old Prompts Are Making Claude Worse (Lance Martin, Anthropic)》:https://sparsenotes.com/posts/2026/11/unhobbling-the-frontier-lance-martin/