东京时间 11 月 5 日凌晨(美国时间 11 月 4 日),webAI 在 Hugging Face 开放了 TwIL-8B 的权重:一个只有 8.79B 参数的稠密推理模型,基于 IBM 的 Granite 4.2 8B 做全参 SFT 加强化学习,主打数学、代码和指令遵循。按 webAI 自己的模型卡,它的 MATH-500 是 98.2,LiveCodeBench 是 81.6,在代码上达到“前沿模型最好成绩的 93%”,4-bit 量化后只要 4.98 GiB,普通笔记本就能跑。值得关注的不是“8B 追平前沿”这种口号,而是模型卡写得相当坦诚:哪里强、哪里弱、哪些数没测,都摊开了,对想在本地跑推理模型的工程师很有参考价值。
发生了什么
webAI 的 David Stout 在 X 上发帖宣布开源 TwIL-8B(东京时间 11 月 5 日 02:37),webAI 官方账号随后转发并补充了对比数据。帖子里的核心说法有三条:代码达到前沿模型的 93%,指令遵循 92%,竞赛数学 90%。他还提到这只是“当天几项发布中的第一项”,webAI 官方账号之后又转发了第二项 webAI Air(一种模型压缩方法),本文只聊 TwIL-8B。
几个基本信息(均来自 Hugging Face 模型卡):
- 参数与架构:8,791,592,960 参数,Granite 解码器稠密 Transformer,40 层,隐藏维度 4096,32 个注意力头 / 8 个 KV 头;
- 上下文:131,072 token(沿用基座);
- 两个版本:balanced(默认,推理更短、单次回答更省)和 verbose(推理更长,适合难题);
- 许可证:webAI Non-Commercial License 1.0,非商用;基座 Granite 4.2 本身是 Apache 2.0。
成绩怎么看:强在推理,弱在知识
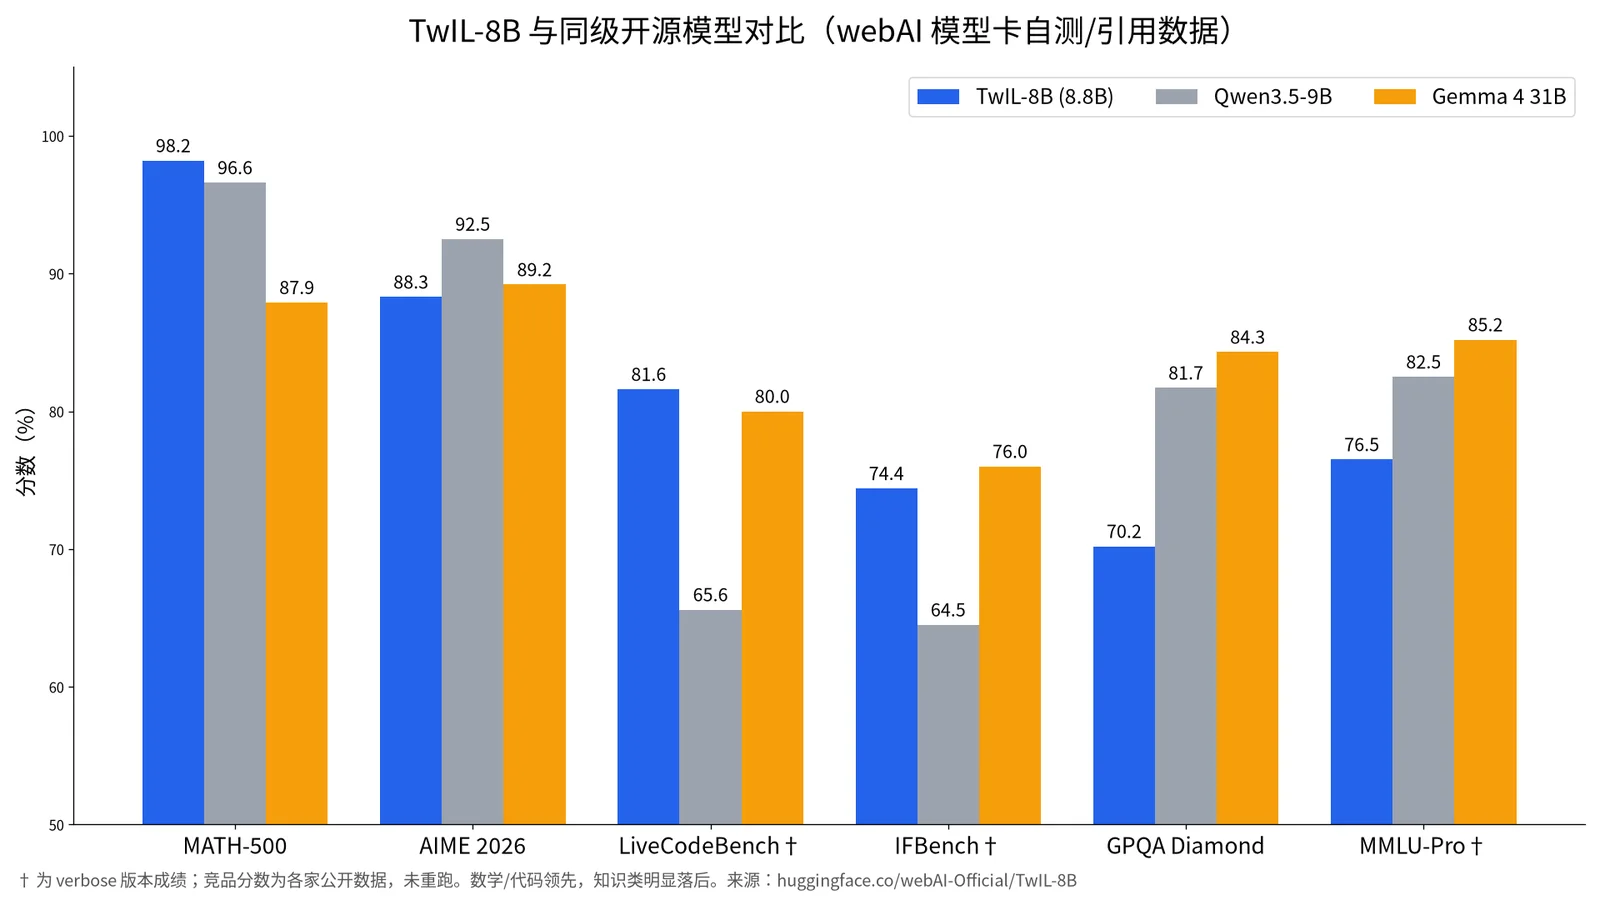
以下全部是 webAI 模型卡给出的数字,TwIL-8B 是自测,竞品是引用各家公开数据、没有重跑:
- 数学:MATH-500 98.2(Qwen3.5-9B 96.6),AIME 2025 88.3;但 AIME 2026 是 88.3,比 Qwen3.5-9B 的 92.5 低 4.2 分。
- 代码:LiveCodeBench 81.6,比 Qwen3.5-9B 高 16 分,略高于 Gemma 4 31B 的 80.0。注意这个分数是在 verbose 版本上测的。
- 指令遵循:IFBench 74.4,比 Qwen3.5-9B 高 9.9 分;IFEval 91.8,与 Qwen3.5-9B 基本持平。
- 知识类:GPQA Diamond 70.2,比 Qwen3.5-9B 低 11.5 分,比 Gemma 4 31B 低 14.1 分;HLE 只有 12.6。
所以“90% 前沿”这个说法要分开看:在 LiveCodeBench、IFBench 上确实接近,但 GPQA Diamond 只到前沿的 75%,HLE 只到 26%。模型卡自己也写了“它不是一个知识模型”。
还有一个细节值得点出:模型卡里对比的“前沿”是 GPT-5.5、Claude Opus 4.8 和 Grok 4.3,因为更新的 GPT-6.1 Sol、Claude Opus 5.5 等已经不再公布 AIME、HMMT、GPQA 这些分数,没法直接比。
怎么做出来的:SFT + RL + 长度惩罚
训练流程分三步:
- 在数学、STEM、指令遵循的推理轨迹上做全参数 SFT;
- 用 GRPO/DAPO 在数学、代码、STEM、指令遵循任务上做强化学习,得到 verbose 版本;
- 再加一轮长度感知的 RL,奖励里偏好更短的推理链,得到 balanced 版本。
第三步是这次最实用的部分。按模型卡,balanced 版在 AIME 2026 上平均每题约 1.95 万输出 token,Qwen3.5-9B 是 3.12 万,少了 38%;HMMT Feb 2026 少 19%。不过和 GPT-5.5 每题约 5 千 token 比,它仍然啰嗦得多。训练数据用 13-gram 匹配对 AIME、HMMT、MATH-500、GPQA 等做了去污染,但模型卡也承认 HMMT Nov 2025 和 HumanEval、MBPP 等代码集不在去污染范围内。
本地跑起来:几条实操建议
最省事的是 llama.cpp 跑官方 Q4KM GGUF(4.98 GiB):
llama-cli -hf webAI-Official/TwIL-8B --hf-file TwIL-8B-Q4_K_M-balanced.gguf -cnv -c 40960 -n 32768
要用 Transformers 的话,from_pretrained("webAI-Official/TwIL-8B") 默认加载 balanced,加 subfolder="verbose" 加载 verbose;bf16 每个版本 16.38 GiB。几点注意:
- 生成长度给足。默认会先输出思考块,竞赛题动辄两三万 token,
max_new_tokens设小了会截断推理、分数大跌。 - 量化有损。模型卡的分数都在 bf16 上测,Q4KM 会有偏差。
- 只是推理模型。没有额外的安全、偏好和工具调用训练,SWE-bench、工具使用、Agent 任务都没评测,别直接拿来当通用助手或编程 Agent 的大脑。
- 非商用许可。公司产品里用之前先看清
LICENSE.md。
一个简单的验证办法:拿你手头付费模型能做对的 20 道数学或算法题,在本地跑一遍 TwIL-8B,数一下通过率,比看榜单靠谱。
小杜点评
从算法工程师的角度,TwIL-8B 最有价值的不是某个分数,而是它示范了一条很清楚的小模型配方:好基座 + 全参 SFT + GRPO/DAPO,再用长度感知 RL 把推理链压短。“同样答对,用更少 token”是本地部署最在意的指标,延迟和显存都跟着降。
但也要冷静看:这是厂商自测,竞品数字来自不同的评测框架,AIME、HMMT 一题就差 3 分左右,几分的差距基本在噪声里;LiveCodeBench 的版本和时间窗也没记录。再加上非商用许可、知识类明显偏弱,我的建议是把它当成本地数学/算法推理的实验对象,或者研究长度惩罚 RL 的参考,而不是生产环境里替换大模型的方案。