博客
AI 资讯、算法拆解和上手教程。一共 390 篇,新写的在最上面。
- 2026/11/05AI资讯约 5 分钟读完
llama.cpp 发 v0.9.0:原生 FP8、NCCL 多机张量并行,还接上 Mistral Large 4 和语音
llama.cpp 于东京时间 11 月 4 日 22:08 发布 v0.9.0:加入 OCP FP8 E4M3、多序列 KV 优化,以及 ggml 0.29.0 的 NCCL 多机张量并行;新支持 Mistral Large 4 与 Chatterbox TTS 等。本文梳理亮点、作者自测加速比与升级注意点。
- 2026/11/05AI资讯约 5 分钟读完
webAI 开源 8B 推理模型 TwIL-8B:数学代码贴近前沿、4-bit 仅 5GB,但知识偏弱且非商用
webAI 开源 8.79B 稠密推理模型 TwIL-8B,基于 IBM Granite 4.2 8B 做全参 SFT 加 GRPO/DAPO 强化学习,厂商自测 MATH-500 98.2、LiveCodeBench 81.6,Q4 量化 4.98 GiB 可本地运行,但知识类基准明显偏弱,且为非商用许可。本文拆解成绩、训练配方和本地部署要点。
- 2026/11/02AI资讯约 5 分钟读完
MiniMax 官方点名社区量化:428B 的 M3.1 Flash 本地怎么跑、要多大内存
11 月 2 日清晨,MiniMax 官方发帖点名社区为 M3.1 Flash 做的量化与部署方案。这个 428B 总参数、激活 23B 的多模态 MoE 模型,2-bit GGUF 约 144 GB。本文整理各方案的内存需求、精度损失和本地部署建议。
- 2026/10/31AI资讯约 5 分钟读完
Nace 开源 27B 决策模型 Drex Max:不生成文字、一次前向给出全部选项概率,24GB Mac 可本地跑
Nace.AI 于 10 月 30 日开源 Drex Max v1 权重:一个 27B 多模态决策模型,输入上下文和带选项的问题,一次前向返回每个选项的概率,不生成文字。本文拆解它的非因果注意力 + 255 路读出头结构、厂商公布的成绩、各平台部署门槛(4-bit 可在 24GB Apple Silicon 上跑文本)、Open RAIL-M 许可证限制,以及适合的分类与路由场景。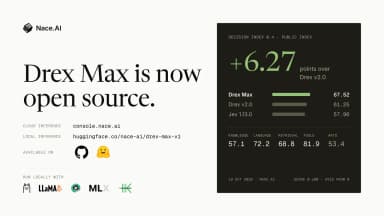
- 2026/10/30AI资讯约 6 分钟读完
Mistral 开源 1 万亿参数 Le Chonk(Large 4):开放权重里的编程与安全强手,附部署门槛
Mistral 放出 Mistral Large 4(Le Chonk)开放权重:约 1T 总参数、49B 激活的多模态 MoE,1M 上下文,主打编程 Agent 与防御型网络安全,许可证可商用。本文梳理架构要点、官方基准、硬件门槛和上手建议。