RadixArk 在 11 月 18 日发布了它的第一个模型 DaisyRose-27B。这不是一次常规的“换个底座再微调”:它基于 Qwen3.8-27B,只用 1200 个精心挑过的长程 Agent 任务、18 天、144 张 H200 做强化学习后训练,就把 Terminal-Bench 4.1 的 pass@1 从 5.6% 提到了 12.0%,翻了一倍还多。更值得算法工程师注意的是另一组数字——同一套训练在它自研的后端上只花了开源方案 43% 的 GPU 时间,模型 FLOPs 利用率(MFU)从 16% 干到了 37%。模型本身开源(Apache 2.0),BF16、FP8、NVFP4 三种精度全放出来了,感兴趣可以直接拉下来跑。
先看成绩:七项全涨,但最难的那项涨得最多
DaisyRose-27B 在 7 个评测上全部超过了底座 Qwen3.8-27B:
- Terminal-Bench 4.1:5.6% → 12.0%(pass@1,涨幅最大)
- Terminal-Bench 2.1:73.0% → 75.5%
- DeepSWE v1.1:42.2% → 46.2%
- SWE Bench Pro v2:91.3% → 94.7%
- HLE(纯文本):33.9% → 34.3%
- IFBench:79.5% → 82.4%
- GPQA Diamond:89.2% → 90.7%
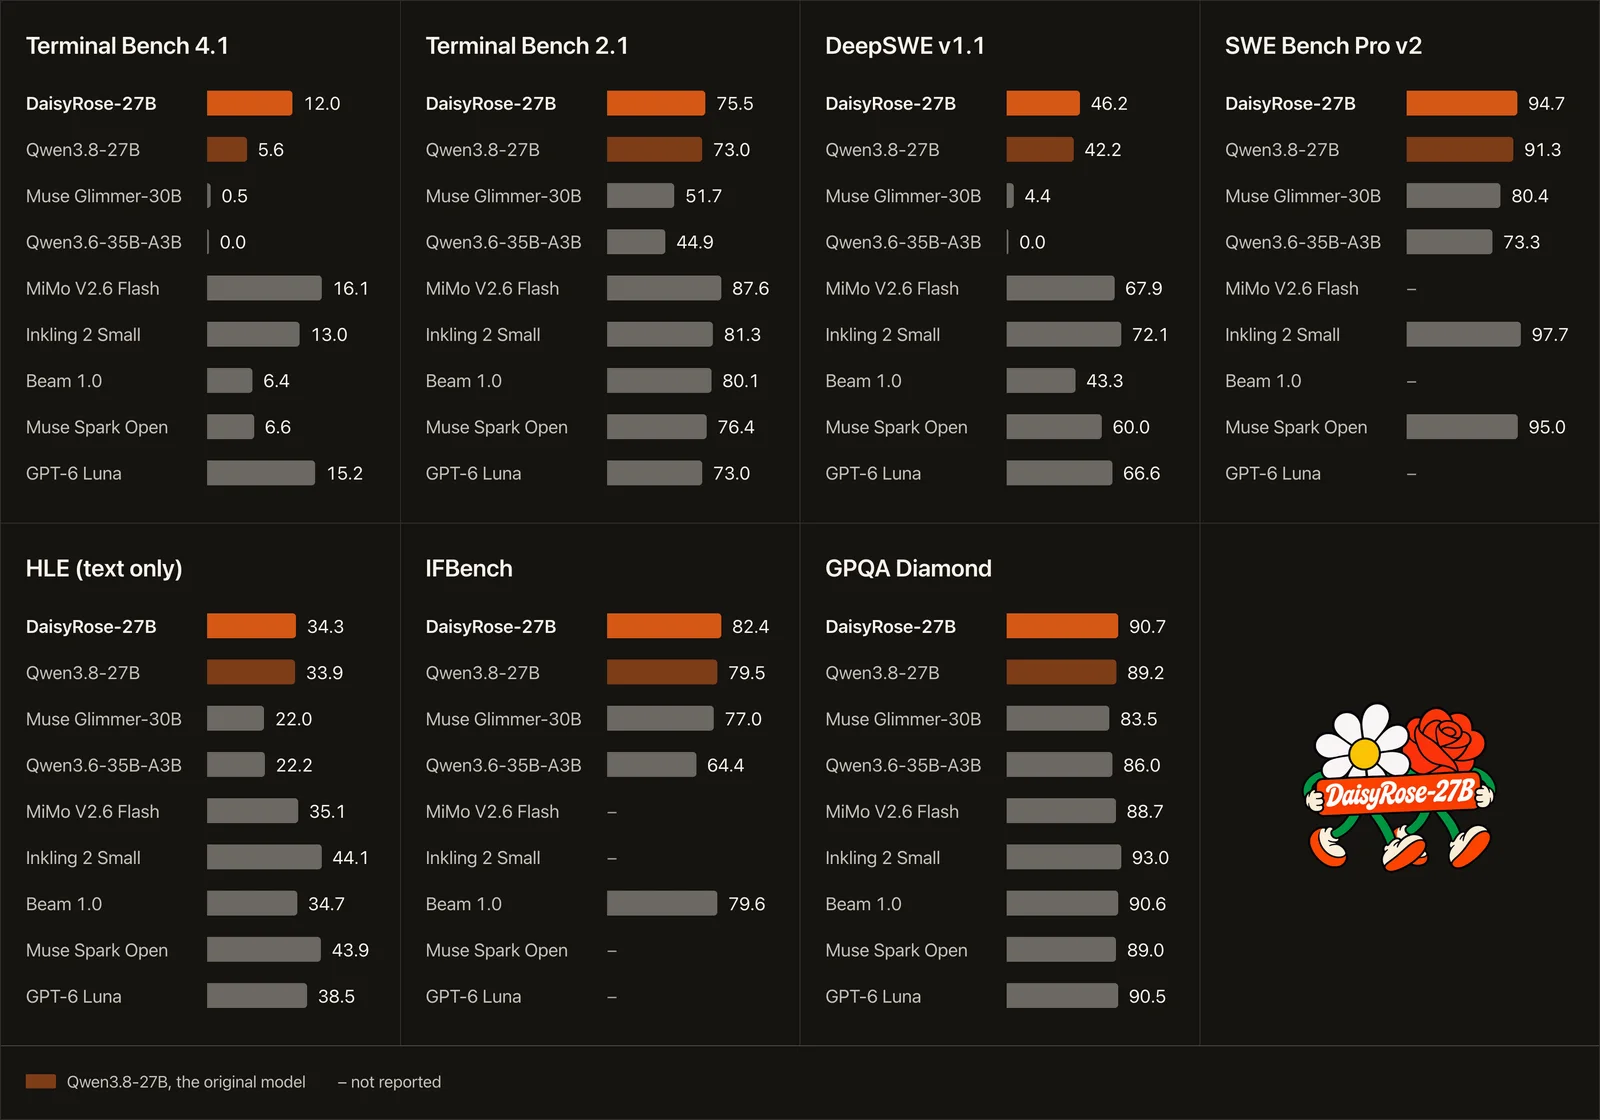
先泼一瓢冷水:这份成绩单不是 SOTA 宣言。官方对比图里,Terminal-Bench 4.1 上 MiMo V2.6 Flash 是 16.1%、GPT-6 Luna 是 15.2%,都比 DaisyRose-27B 的 12.0% 高;HLE 和 GPQA 上它也被 Inkling 2 Small 等模型压着。DaisyRose-27B 真正想证明的不是“我最强”,而是“后训练这件事可以做得便宜得多”——用很少的数据、很短的时间,让一个现成底座在长程 Agent 任务上脱胎换骨。这对没法烧几千张卡的团队来说,比刷榜本身更有参考价值。
另外注意一个细节:官方说明分数取的是 BF16 和 FP8 两次运行里较高的那一个,两者差距不到 1 个点;Terminal-Bench 4.1 是每个任务跑 8 次取平均,用的是内部的 mini-swe-agent 评测框架并开启了摘要机制。厂商自测数据,引用时要留这个心眼。
1200 个任务是怎么挑的:只练底座会错的题
数据是这次发布的第一块招牌。RadixArk 和 Eigent AI 合作,从后者的大任务池里筛出几千个候选,最后只留下约 1200 个,筛选标准有三条,每条都冲着“让训练真正起作用”去:
第一,每个任务都针对底座犯过的错。团队先让 Qwen3.8-27B 把所有任务跑一遍,围绕它暴露的短板重新设计任务,再把难度调到“能学会”的区间——太简单学不到东西,太难则学不会。这个“先诊断、再出题”的做法,是后训练里最容易被省掉、也最影响效果的一步。
第二,每个任务都要走完一串互相依赖的步骤。单次尝试最长 1.5 小时、100 多次工具调用、25.6 万 token 以上的输出,任务横跨机器学习、软件工程、科学等多个领域。训练会话最长可达 100 万 token,靠 harness summarization 把多条轨迹折叠起来处理。这正是 Agent 训练和普通 SFT 最大的不同:要练的不是“答一句话”,而是“把一件长活干完”。
第三,奖励必须发给真正解决问题的人。团队逐条审了每个任务和模型的尝试记录,能靠走捷径蒙过的、本身有设计缺陷的任务,要么修要么直接删掉。奖励函数被“hack”掉,是 RL 后训练里最常见的翻车方式,这一步等于提前堵上了口子。
训练后端:128 张卡跑 Agent,16 张卡学,互不等待
第二块招牌是训练框架 Miles——RadixArk 开源的强化学习框架。这次的训练跑在完全异步的模式下:128 张 H200 跑 Agent 推理做任务,16 张 H200 跑训练器从轨迹里学习,两边谁也不等谁;每学完一步,更新后的模型就发回给那 128 张推理卡。整个发布跑了数周、总计 6.3 万 GPU 小时,速度和效率从头到尾没掉下来。
效率数字值得拆开看:
- MFU 37%,而基于 Megatron 的开源训练器在同类任务上只有 16%。同样一份训练,GPU 时间省了 57%。
- 端到端 2 倍快:算上 Agent 做任务的时间,144 张 H200 上大约每秒 1.68 万 token,开源训练器约 8300 token。
- MoE 模型上收益更大:Qwen3.6-35B-A3B 上是 6.2 倍,约 3000 亿参数的 GLM-5.3-Flash 上超过 10 倍。
需要提醒一句:“训练成本降 57%”是按 GPU 利用率折算出来的,不是直接等于账单打四三折。硬件、显存、任务分布都会影响最终数字,但 MFU 从 16% 到 37% 这个量级的差距,说明异步架构 + 针对 Agent 训练优化的后端确实把卡用得更满了。长会话训练里推理和训练互相拖后腿,是很多团队自己搭 RL 管线时踩过的坑,Miles 把这块做成了开源方案,值得去翻一翻。
沙箱:94.4 万个,用坏了 1% 不到
Agent 训练离不开沙箱:每次尝试都要在一个全新的任务环境副本里跑命令、改文件、再评分。RadixArk 的沙箱服务基于开源项目 AgentENV(他们也向上游贡献了修复),9 月中到 11 月中跑了约 94.4 万个沙箱,峰值同时在线 1566 个,规模从 1 台机器扩到最多 12 台,期间做了 10 次升级,几乎都是在训练进行中热更新的。
可用性数字很实在:九周里沙箱创建成功率 99%,10 月下旬之后超过 99.95%。成本上也有一手——让每个沙箱的内存分配随实际用量动态伸缩、多沙箱共享机器,云基础设施成本比用主流云沙箱厂商低约 80%。对自己搭 Agent 训练管线的团队来说,沙箱的稳定性和成本往往比模型本身更先成为瓶颈,这组数字是很好的参照。
怎么用:开源协议,三种精度,SGLang 就能跑
DaisyRose-27B 保留了 Qwen3.8-27B 的架构、tokenizer、对话模板、图像理解能力和 25.6 万 token 上下文,权重按 Apache 2.0 开源,提供 BF16、FP8、NVFP4 三种精度。官方推荐用 SGLang + DSpark 推测解码来部署,默认会先“思考”再回答:用 OpenAI 兼容接口调用时,推理过程在 reasoning_content 字段里,最终答案在 content 字段里。想自己训 Agent 的话,Miles 框架也是开源的。
小杜点评
这篇发布最值得抄作业的不是模型分数,而是它把“后训练怎么做才划算”这件事讲透了:数据上,1200 个任务胜过几万条凑数的样本,关键在“针对底座的错出题、奖励只发给真解题”;工程上,异步 RL + 高 MFU 后端 + 稳定的沙箱服务,三件套缺一不可,MFU 从 16% 到 37% 就是最直接的回报。
当然也要清醒:Terminal-Bench 4.1 从 5.6% 到 12.0% 是翻倍了,但绝对值仍然不高,离头部模型还有距离;而且这组数字是厂商自测,评测框架、摘要机制都由发布方自己定。建议的做法是把它当作一个性价比很高的开源 Agent 底座和一套可复用的训练方法论,而不是下一个通用 SOTA。如果你正在搭自己的 Agent 训练管线,先读 Miles 和 AgentENV 的代码,再决定要不要照着这套打法走——那比直接下载权重更有价值。
参考来源
- Hugging Face 官方博客:DaisyRose-27B: Pushing the Frontier of Post-Training Efficiency(2026-11-18 19:54 UTC,2026-11-19 04:54 JST)— https://huggingface.co/blog/RadixArk/daisyrose-27b-pushing-the-frontier-of-post-trainin
- RadixArk 官方原文:DaisyRose-27B: Pushing the Frontier of Post-Training Efficiency — https://www.radixark.com/blog/daisyrose-27b
- 封面与评测对比图:RadixArk 官方配图 — images/daisyrose-27b/hero.png