北京时间 11 月 5 日 16:55(官方 X 发帖时间 08:55 UTC),百度官方账号宣布开源 ERNIE-5.5-Flash-Base(文心 5.5 Flash Base)。这是预训练终点的 Base 权重:稀疏 MoE,总参数 280B、每 token 激活 14B,在 33.5T tokens 上从零训完,训练上下文最长 128K,微调与推理支持到 1M。官方明确说它还没做过中训练和后训练,定位是给领域适配、指令微调和强化学习研究当起点;后训练版的 ERNIE 5.5 Flash 会随后推出。对做基座续训的算法工程师来说,这是时隔约 16 个月后,百度再次放出千亿级开源权重。
规格与结构:280B-A14B,HCA + MLA-DSA 混搭
按 Hugging Face 模型卡与官方技术博文:
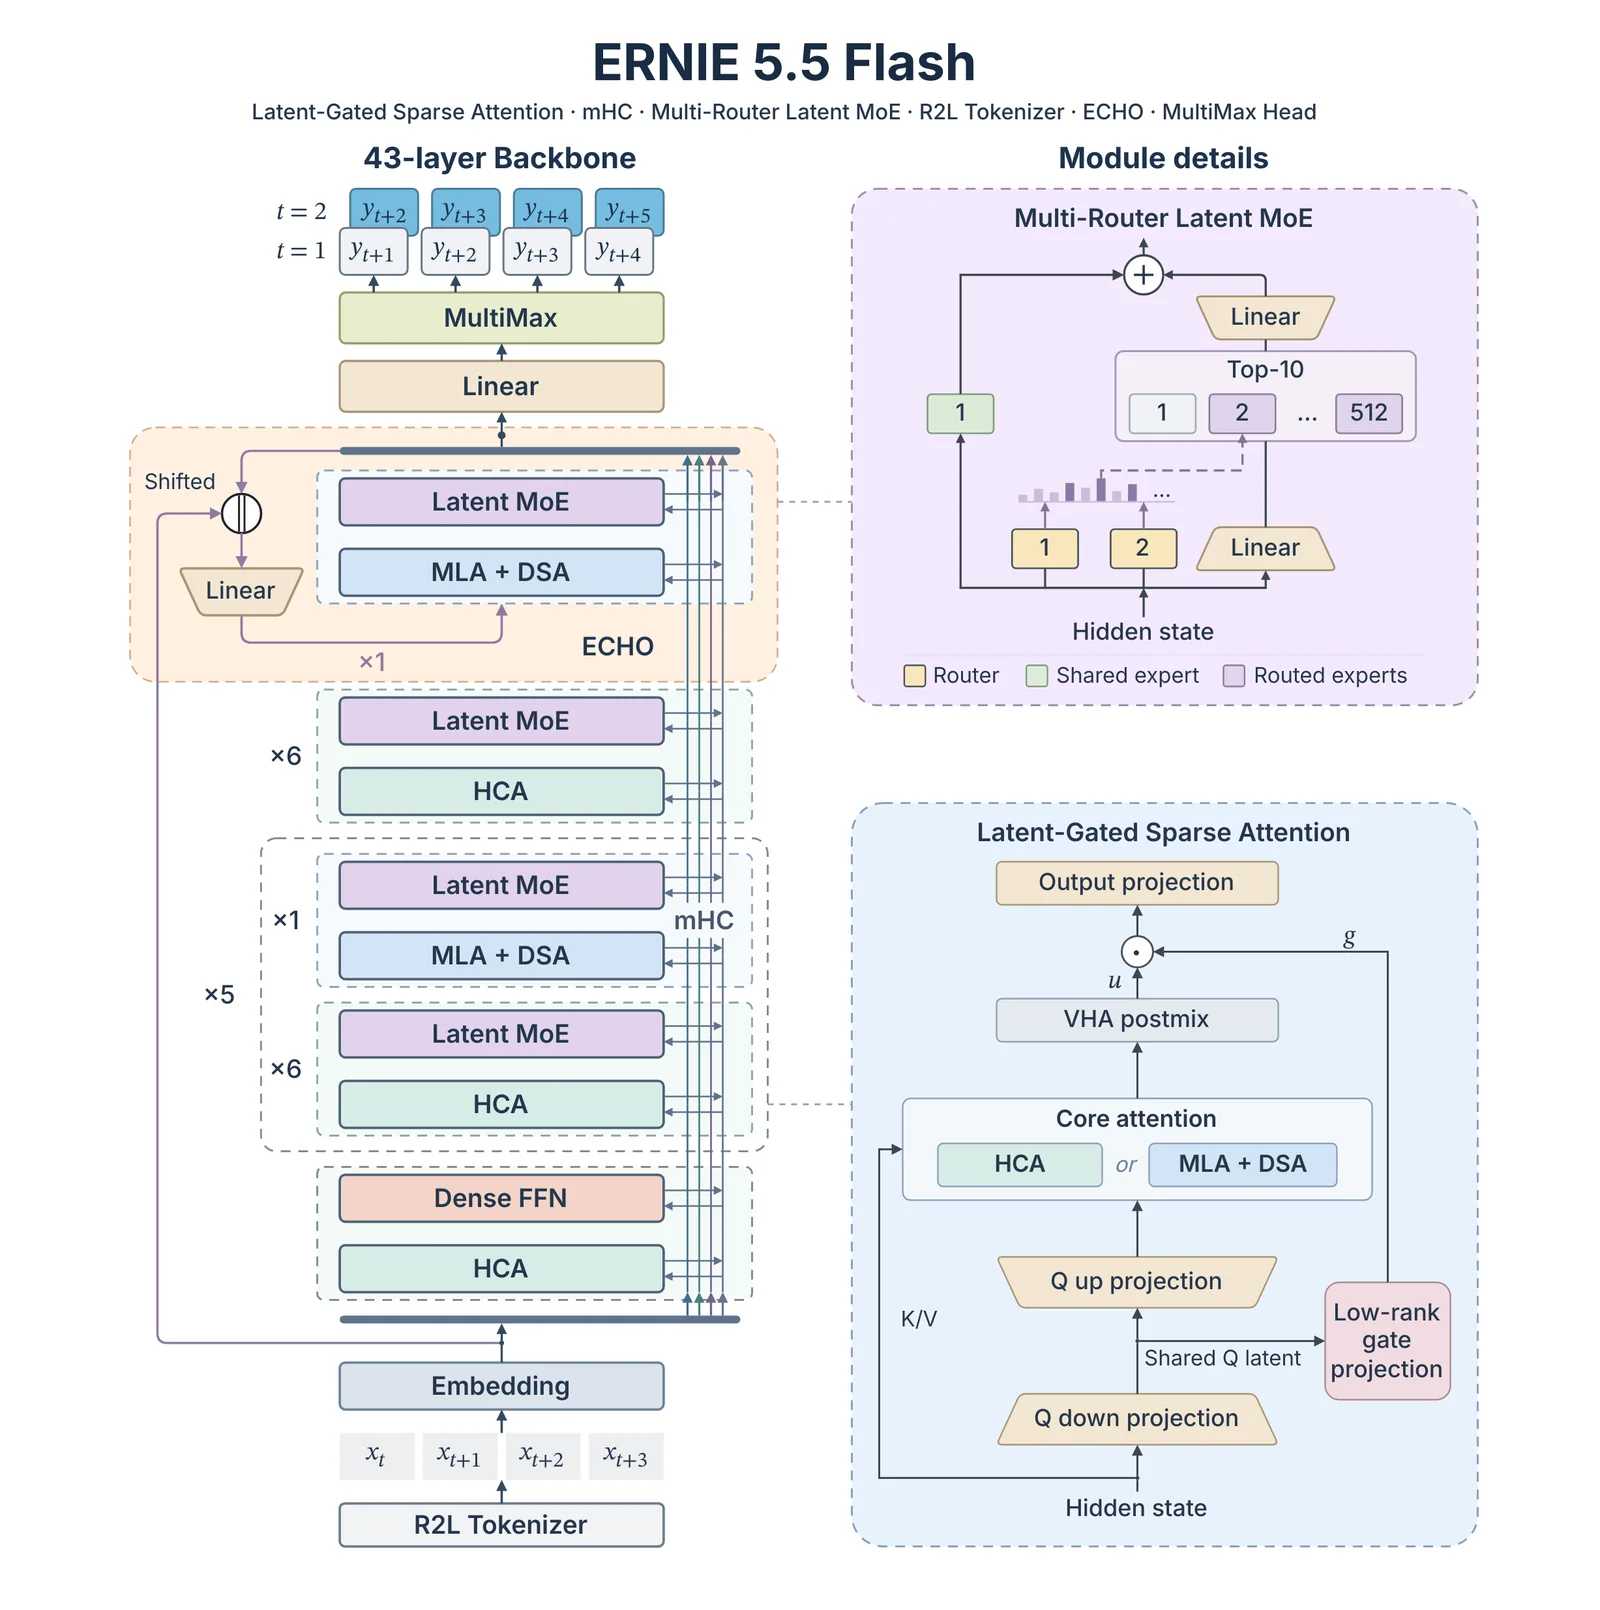
- 规模:280B 总参、每 token 激活 14B;43 层(1 层稠密 FFN + 42 层 Multi-Router Latent MoE);hidden size 4096;词表约 20.1 万。
- 注意力:37 层 Heavily Compressed Attention(HCA,每 128 token 压成 1 个缓存项,head dim 512)+ 6 层 MLA + DSA(token 级稀疏注意力,head dim 256)。大部分层只看压缩历史,少数层保留细粒度检索。
- MoE:每层 512 个路由专家(top-10)+ 1 个共享专家,专家跑在 2048 维潜空间里,再升回 4096,用来砍 dispatch/combine 流量。
- 其它设计:mHC(流形约束超连接,expansion rate 4)、ECHO(复用最后一层做多步预测并兼作投机解码草稿)、MultiMax 输出头、数字右到左分组的 R2L tokenizer。
- 精度与下载:放出 FP8 与 BF16 两套 safetensors,地址在 Hugging Face / ModelScope 的
baidu/ERNIE-5.5-Flash-Base与-BF16。
训练侧用的是 Muon 优化器 + FP8 混合精度,并写了通信合并的分布式 Muon 和面向大 head dim 的 FlashMask-4 注意力算子。预训练数据强调网页、仓库级代码(含 commit / PR / CI 修复等演化数据)和长文检索类合成数据——官方的说法是「后训练很难补的能力,尽量在预训练里堆好」。
跑分怎么读:统一流水线,但仍是厂商自测
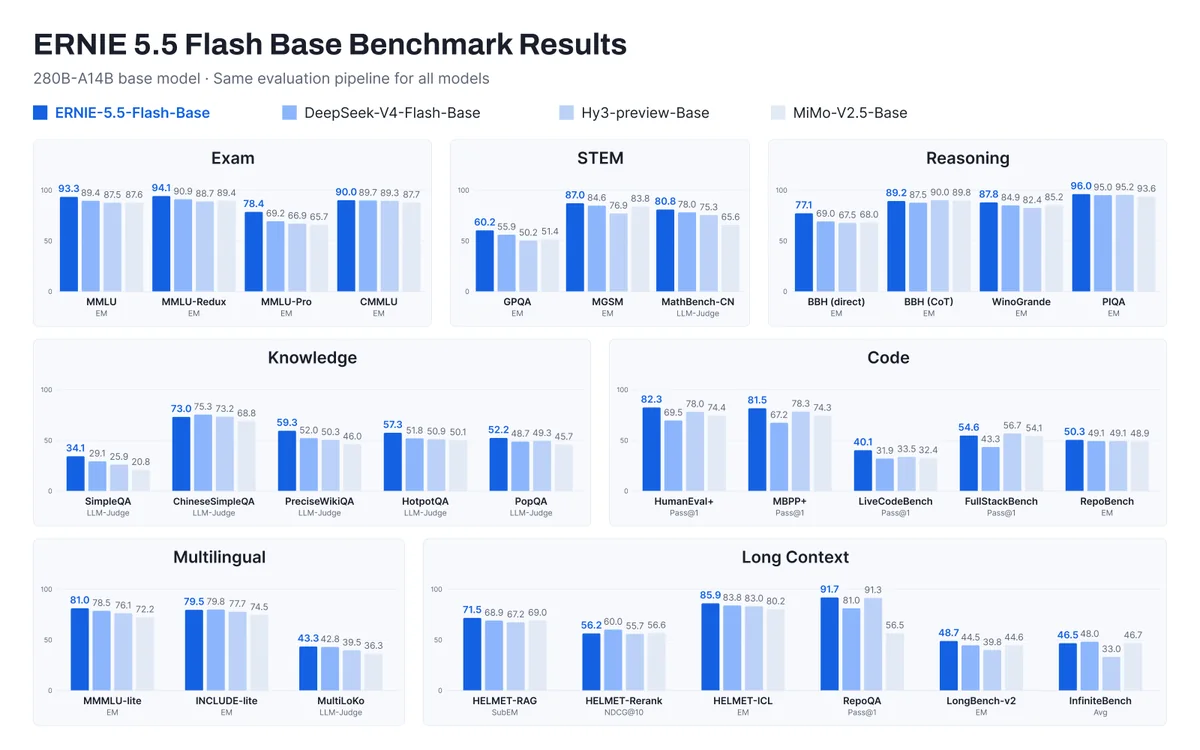
官方用同一套评测框架、同一套 prompt 和 few-shot,把 ERNIE-5.5-Flash-Base 与 DeepSeek-V4-Flash-Base(284B-A13B)、Hy3-preview-Base(295B-A21B)、MiMo-V2.5-Base(310B-A15B)放在一起比。挑几个和工程师相关的数字(均为百度公布的自测):
| 指标 | ERNIE-5.5-Flash-Base | DeepSeek-V4-Flash-Base |
|---|---|---|
| MMLU-Pro | 78.4 | 69.2 |
| HumanEval+ | 82.3 | 69.5 |
| MBPP+ | 81.5 | 67.2 |
| LiveCodeBench | 40.1 | 31.9 |
| RepoQA | 91.7 | 81.0 |
| ChineseSimpleQA | 73.0 | 75.3 |
| InfiniteBench | 46.5 | 48.0 |
代码和考试类领先比较明显;中文事实问答和个别长上下文项上 DeepSeek 略高。这是 Base 模型、不是 chat 模型,直接拿来当聊天机器人会失望——官方推理示例走的是 /v1/completions,不是 chat template。
怎么跑、许可证要注意什么
推理:官方给了 day-0 镜像与插件。SGLang 可用 lmsysorg/sglang:dev-ernie-55-flash;vLLM 需装 vllm==0.32.0 再装 baidu/vLLM-ERNIE 插件。两边都支持把上下文拉到 1,048,576。Transformers 加载时要保持 add_special_tokens=True(需要 BOS)。
许可证是自定义的 ERNIE 5.5 Flash Base Model License Agreement v1.0,不是 Apache。要点:
- Territory:全球,但不含欧盟、英国、韩国;
- 年相关收入 ≤ 5000 万美元可商用,需署名「Powered by ERNIE」并一次性发邮件通知;超过需书面授权;
- 禁止用本模型输出去改进非派生的其他 AI 模型(蒸馏到无关模型会踩线)。
部署前建议把 LICENSE 通读一遍,尤其是跨境和商用门槛。
小杜点评
从算法工程师视角,这条新闻的价值不在「又一个 280B」,而在把预训练终点干净地交出来。今天大家刷榜的多是 instruct / agent 成品;真正做领域续训、做 RL 对比实验时,缺的往往是一个规格清楚、结构文档齐全的 Base。百度这次把 HCA/MLA 混搭、Multi-Router Latent MoE、ECHO 都写进了公开博文,还配了 SGLang/vLLM day-0 支持,工程上比「只有权重、没有菜谱」友好得多。需要泼的冷水也很明确:自测榜要等社区复现;许可证有地域和收入门槛;280B-A14B 对个人显卡不现实,真正接得住的是云厂商和有卡团队。我的建议是:先按官方 cookbook 起一个 completions 服务,用你自己的领域续训小样本摸一下 loss 曲线,再决定要不要等后训练版 Flash。