导语
10 月 29 日,做 AI 视频的 Pika 发布了 Pika H3 Flex,并把权重放上了 Hugging Face、代码放上了 GitHub。它不是从零训练的新底座,而是在 MiniMax 开源的 H3(一个 33B 参数的音视频联合生成 Transformer)上做的后训练:先微调,再把采样从 50 步蒸馏到 6 步,最后用强化学习和偏好优化把画质拉回来。一次生成就能出最长 15 秒、带同步立体声的视频。
为什么值得关注?视频生成这两年一直卡在“又慢又贵”。Pika 官方给的数据是:768p、15 秒带音频的视频,Transformer 去噪约 7 秒、整个推理不到 10 秒,比视频本身还短;API 起步价每秒输出 0.01 美元。更重要的是,权重和推理代码都放出来了,蒸馏、奖励学习这一整套做法写得很清楚,对做生成模型的工程师来说,这是一份能对着抄的后训练流水线。
它是怎么从 50 步做到 6 步的
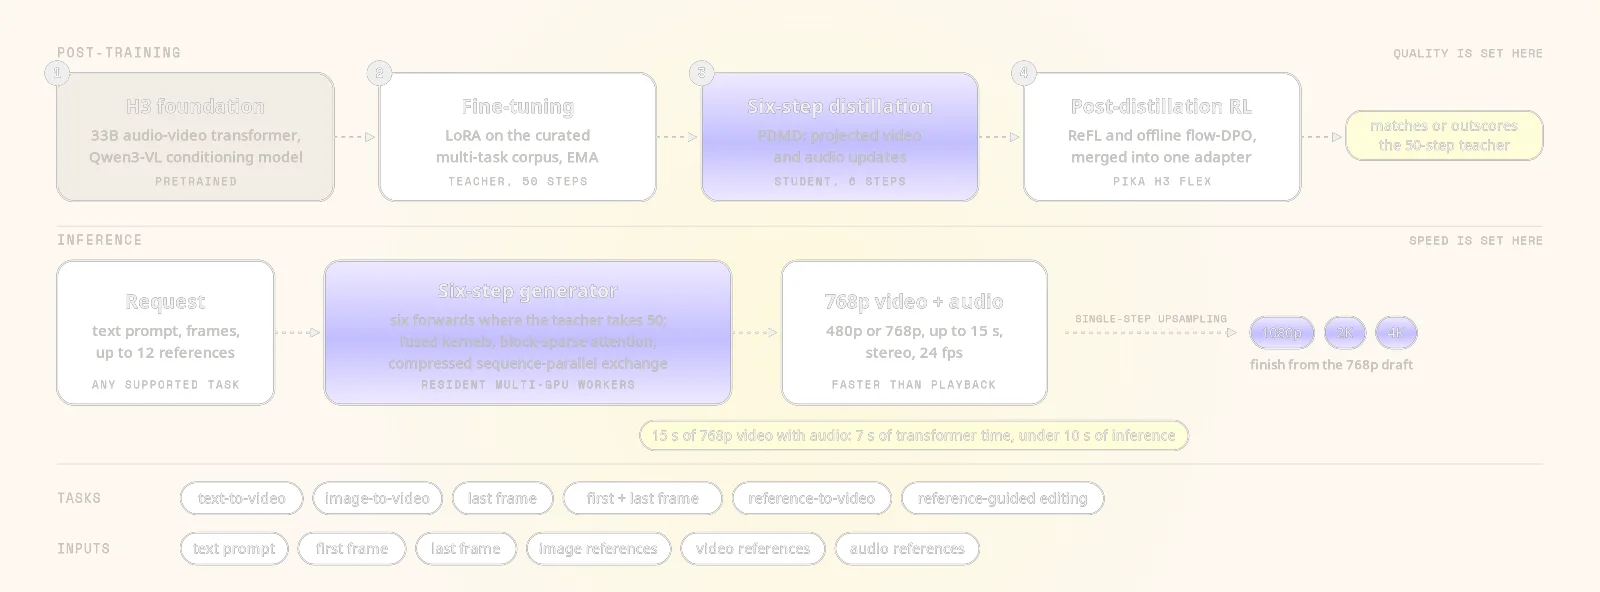
Pika 在技术博客里把后训练拆成三段,思路很典型,值得细看:
- 监督微调(SFT):在 MiniMax H3 的官方版本上,用内部挑选过审美质量的音视频数据集做 LoRA 微调,仍保留 50 步采样。这个版本作为后面蒸馏的“老师”。
- 步数蒸馏:用分布匹配蒸馏(DMD)把步数压下来。官方说标准 DMD 训练不稳定,于是换成了投影版的 PDMD,最终学生模型只需 6 步去噪,老师是 50 步。
- 蒸馏后的奖励学习:在 6 步模型上分别训练两个 LoRA,一个用 ReFL(可微奖励反馈)提画质和清晰度,一个用 DPO(离线偏好)提指令遵循和真实感,最后把两个适配器合并成一个,推理时不增加步数。
推理侧还做了一轮纯工程优化:缓存和时间步相关的 AdaLN 投影、算子融合、FlashAttention-4、块稀疏注意力和压缩通信。官方在 8 张 B300 上测 5 秒 768p 视频,完整推理从 3.409 秒降到 2.129 秒,快了 1.60 倍。
能做什么:5 种生成模式、最多 12 个参考
按模型卡的说明,Pika H3 Flex 有两个任务适配器:FL2VA 负责文本和首尾帧条件,Ref2VA 负责多模态参考。对应 5 种模式:
- 纯文本生成视频和音频(t2va)
- 首帧、尾帧、首尾帧条件生成(i2va / l2va / fl2va)
- 多模态参考生成(ref2va):最多 9 张图、3 段视频、3 段音频,总共 12 个参考文件
本地开源推理原生输出 480p / 768p,24 fps,5~15 秒,支持 21:9 到 9:21 共 11 种画幅,音频是 32 kHz 立体声。如果要 1080p、2K、4K,或者把配音、配乐、音效、拟音、环境声拆成 5 条可单独编辑的音轨,需要走 Pika 的付费 API,这两块不在开源包里(官方说之后会开源超分模型)。
效果和速度:官方数据怎么看
Pika 拿它和官方 MiniMax H3、Fal H3 Max、HeyGen Video(quality)在同一批提示词、768p 下对比:
- 自动指标:5 个画质和音质指标(VT、VA、KVQ、UVQ、AA)全部第一,比如视频技术质量 VT 12.3,MiniMax H3 是 11.7;但音画对齐、文本对齐四家基本持平。
- 人工盲评:在人体结构、复杂构图、音画同步上领先;物理、多场景叙事、光照材质、动作密集类任务上,其他模型仍更受偏好。
- 速度:768p 下平均比 Fal H3 Max 快约 1.8 倍。
这些都是 Pika 自己的评测,对手只有 3 个,也没包含 Seedance 2.5、Gemini Omni 这类闭源强手的画质对比。官方自己也承认物理和多场景一致性还要改进,所以看成“开源阵营里又快又好看的一档”比较稳妥。
想本地跑?先看看硬件门槛
开源归开源,门槛不低:
- 显卡:官方只在 H100 80GB 上验证过,一个请求只用一张卡。480p / 5 秒默认模式就要占约 66~69 GiB 显存;768p / 15 秒在 H100 上会爆显存,得开
--cpu-offload,此时显存约 29~32 GiB,但主机内存要准备近 94 GiB。 - 磁盘:底座组件约 211 GB,加两个适配器约 5.5 GB。
- 环境:Python 3.12,可以用 pip、Conda 或 Docker 安装;也已经接入 ComfyUI(官方给了 T2V、FL2VA、R2V 三个工作流)和 Diffusers。
- 许可:适配器属于 MiniMax H3 的衍生模型,沿用 MiniMax H3 社区许可协议,示例代码是 Apache 2.0。要商用,务必先读许可原文。
社区动作也很快:Hugging Face 上已经有人放出了更少步数的 Turbo LoRA、苹果芯片的 MLX 版本。手上没有 80G 卡的话,先用 ComfyUI 工作流或者 API 试效果更现实。
小杜点评
作为算法工程师,我觉得这次最有价值的不是“开源第一”这个名号,而是 Pika 把一条完整的视频模型后训练路线公开了:SFT 定审美 → PDMD 压步数 → ReFL + DPO 分别训 LoRA 再合并找回质量 → 再叠工程加速。尤其“蒸馏后再做奖励学习,两个 LoRA 合并、推理零额外开销”这一招,做图像或视频生成的团队都可以拿来试。
另一个信号是:开源视频模型开始从“能生成”走到“能迭代”。生成快于播放、按秒计费只要 1 美分,意味着创作者可以像改代码一样反复试提示词和镜头调度。但也要清醒:本地跑要 80G 显卡起步,4K 和分轨音频还要走付费 API,评测也都是自家做的。我的建议是,做内容的朋友先从 ComfyUI 或 API 上手;做模型的朋友,重点读它的技术博客和蒸馏细节,比追榜单更有收获。