10 月 30 日晚(东京时间 22:41),Nace.AI 在 X 上宣布开源 Drex Max v1 的权重。这不是又一个聊天模型:它是一个 27B 参数的多模态"决策模型",你给它一段上下文和几个带选项的问题,它一次前向就把每个选项的概率全部算出来,一个 token 都不生成。官方说 4-bit 版本能在 24GB 内存的 M4/M5 Mac 上完全本地跑。对每天在业务里用大模型做分类、路由、审核的工程师来说,这类"只打分不写字"的模型,可能比再多一个聊天模型更实用。
背景:什么是"决策模型"
我们平时让 LLM 做工单分类,一般是写个 prompt:"请从 billing / technical / other 里选一个,只输出标签"。然后祈祷它别多说话、别编一个不存在的标签,再想办法从 logprobs 里抠一个置信度出来。
Nace.AI 的思路是把这件事做成一个专门的模型。按模型卡的描述,你把上下文作为 state 传进去,再附上一个或多个"有类型的问题",模型直接返回每个选项的概率。目前支持三种问题:
choice:多选一,比如工单该派给哪个团队;noul:是/否,比如这单要不要退款;score:打分,比如紧急程度 0/1/2,返回期望分数和每一档的概率。
模型卡给的示例里,一条"同一订单被扣了两次款"的工单,billing 的概率是 0.9988,是否退款的概率是 0.9974,紧急程度则给出 1.65 分、置信度 0.48。最后这个低置信度反而是亮点:模型在告诉你"这条我没那么确定",你可以据此转人工。
需要说明的是,Drex Max 并不是 10 月 30 日才出现的。根据 Nace.AI 的 GitHub 仓库,Drex Max 在 10 月 14 日就已上线云端 API;这次新的是权重开放,可以下载到本地跑了。
模型要点:27B 骨干 + 255 路读出头
模型卡里的结构信息比较具体:
- 骨干:稠密 27B 参数,64 层。其中 48 层是 Gated DeltaNet 线性注意力,保持从左到右的因果顺序;每隔四层有一层全注意力,共 16 层,这些层被改成非因果,每个 token 都能看到整段输入。
- 读出头:
readout.safetensors里的 255 路分类头,把最后的隐状态映射成最多 255 个选项的概率。 - 多模态:图片走原生视觉塔,对同一请求里的所有问题可见。
- 上下文:模型窗口 262,144 token,但默认每次请求只开 16,384,需要用
DREX_MAX_CONTEXT或--max-length手动调大。
有一点要特别注意:官方说明非因果注意力是由自带的加载器施加的,用普通的因果聊天方式加载这套权重,复现不了它的分数。所以别想着直接扔进 vLLM 当聊天模型用。
成绩:以下均为厂商公布数据
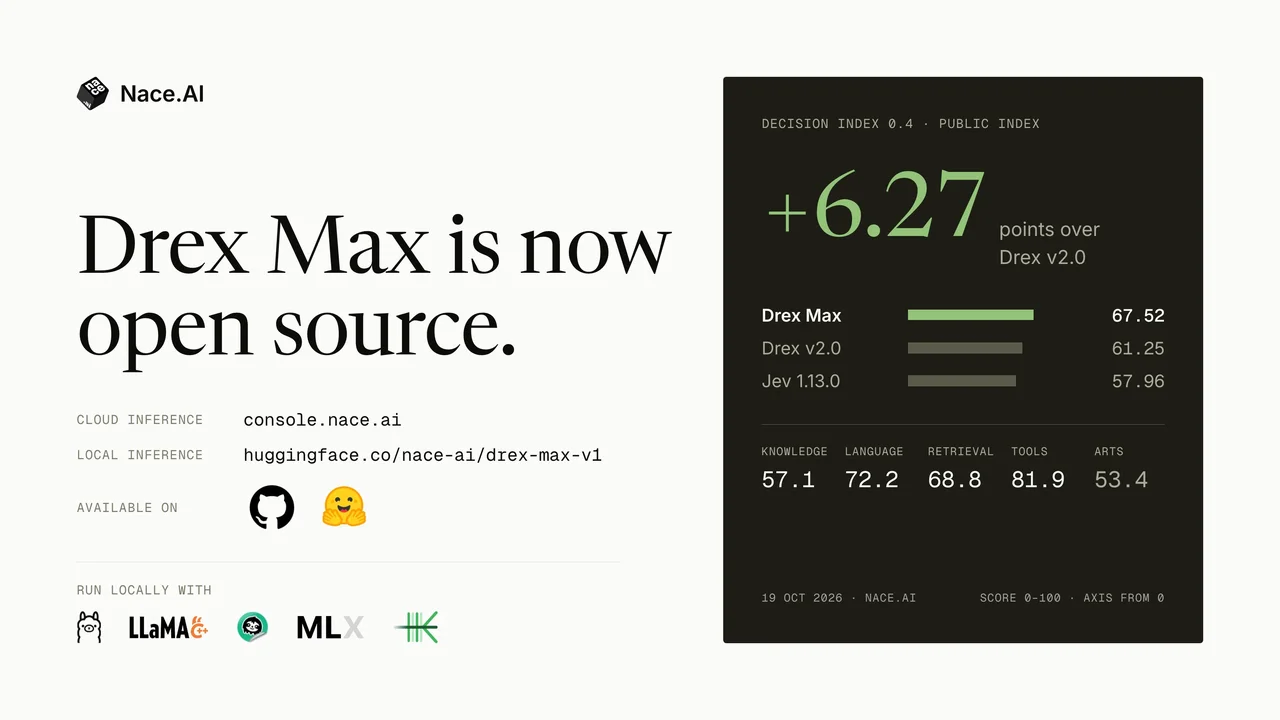
- Decision Index 0.4(公开文本部分,37 个基准的平均):Drex Max 67.52,比自家 35B 的 Drex v2.0(61.25)高 6.27 分,Jev 1.13.0 为 57.96。这套指数由 Nace.AI 发布,属于自测口径。
- 公开视觉指数:73.92,其中 InfographicVQA 97.3、KIE(CORD+FUNSD)92.4、Mind2Web 84.2,但 Hateful Memes 审核只有 40.6,R-Bench-M 38.6,弱项也很明显。
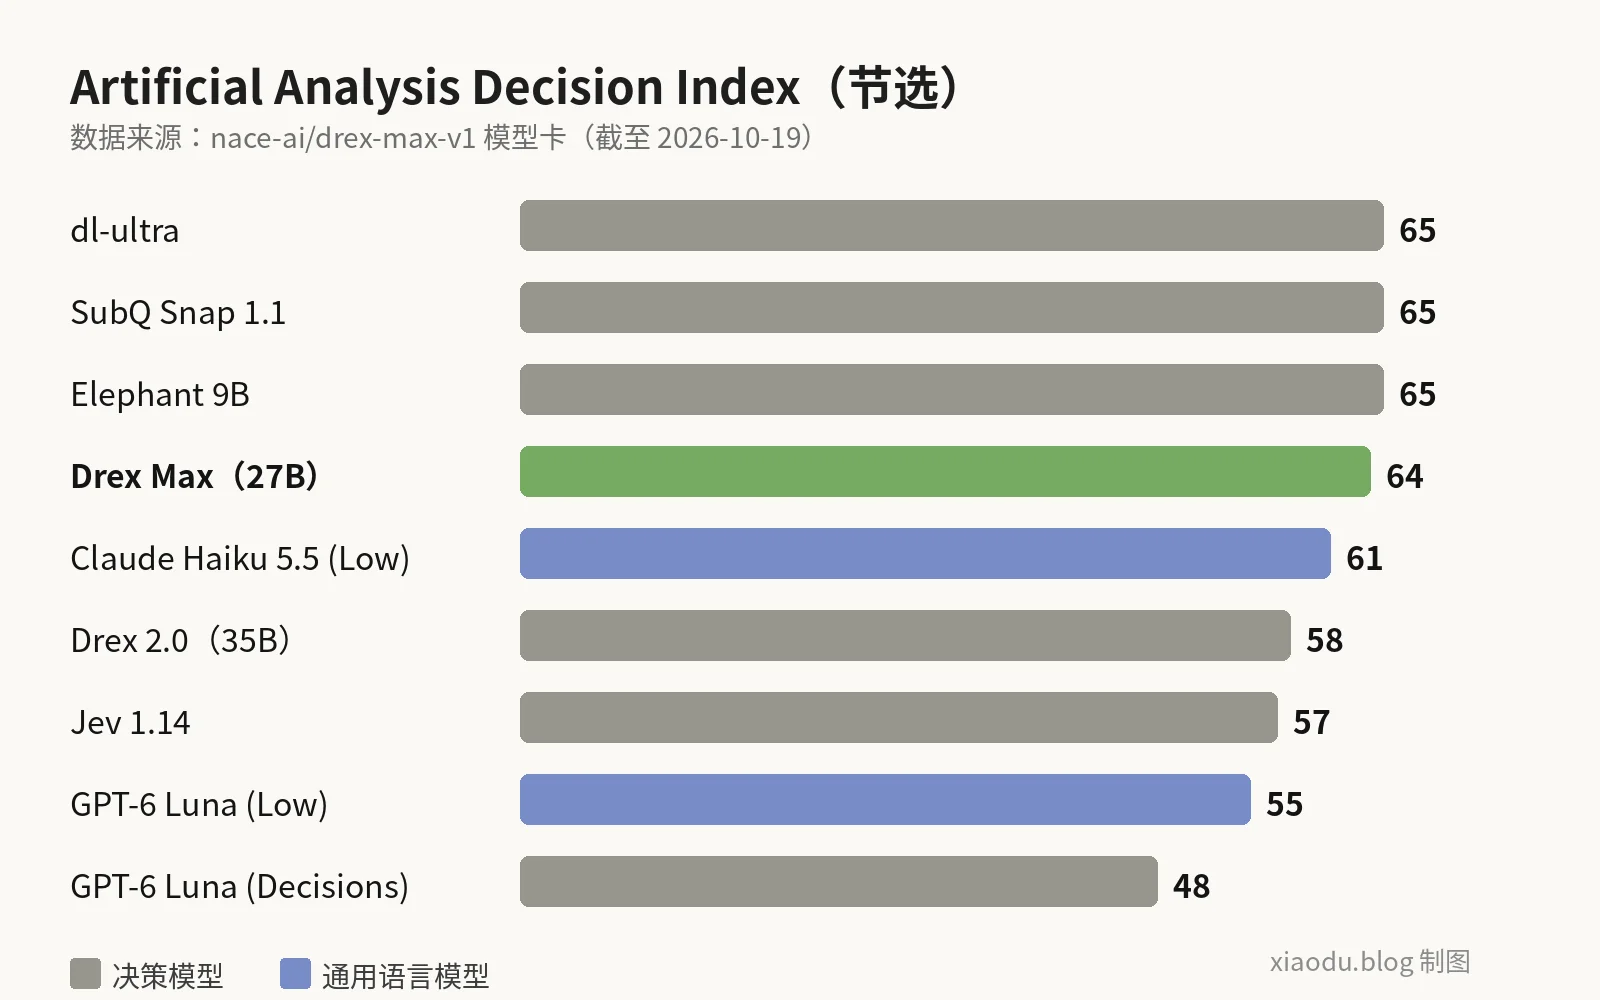
- Artificial Analysis Decision Index:64 分,18 个模型里排第 4,比并列第一的 65 分低 1 分,高于 Claude Haiku 5.5(Low)的 61 和 GPT-6 Luna(Low)的 55(见上图,数据引自模型卡)。
成绩截至 10 月 19 日。决策类基准目前还很小众,建议把这些数字当作"值得一试"的信号,而不是选型结论。
部署门槛:先看你手上的机器
按模型卡和官方测试硬件整理:
| 运行方式 | 显存/内存 | 说明 |
|---|---|---|
| Python + NVIDIA GPU,bf16 | 约 49GB(H100 实测加载 48.6 GiB) | 唯一支持图片输入的路径 |
| Python + NVIDIA GPU,8-bit | 约 26GB(L40S 实测 25.9 GiB) | 与 bf16 概率差在 0.03 以内 |
| llama.cpp / Ollama,Q8_0 GGUF | 需要 48GB | 用官方 fork 的 drex-max-v1 分支,仅文本 |
| Kapitsa / MLX,affine Q4 | 24GB 以上 Apple Silicon | 仅文本 |
官方在 48GB 的 M5 Pro 上测试,Q8_0 GGUF 的输出与 H100 上 bf16 的结果相差在 0.02 以内。Python 路径需要 Python 3.12 以上。
对开发者的意义与上手建议
- 适合的场景:工单路由、内容审核、意图识别、合规检查、截图/票据判断这类"答案在有限选项里"的任务。它天然给出校准过的概率,方便设阈值做人机分流。
- 先跑官方示例:
hf download nace-ai/drex-max-v1,再用仓库里的examples/request.json跑通,确认你的问题能否改写成 choice / noul / score 三种格式。 - 一定要在自己的数据上评测:拿现有业务里已标注的几百条样本,和你正在用的 LLM + prompt 方案对比准确率、校准度和延迟。
- 看清许可证:权重采用 Nace.AI Open RAIL-M。个人、研究,以及过去 12 个月营收和累计融资都低于 100 万美元的组织可以免费商用;超过任一门槛,或做与 Nace 竞争的决策模型、文档智能产品,需要另签商业许可。所以它是"开放权重",不是 Apache 那种意义上的开源,公司内用之前先过一下法务。
小杜点评
从算法工程师的角度,Drex Max 最有意思的地方不在分数,而在思路:把 LLM 当作特征提取器,最后接一个分类头,再把部分注意力层改成双向。这其实很像当年 BERT 加分类头的做法,只是骨干换成了带线性注意力的 27B 大模型,加上了长上下文和视觉。生成式模型做分类的老问题,比如输出格式不稳定、置信度难拿、要多 token 解码,在这个范式里都被绕开了。
不过我也有两点保留。第一,所有成绩都来自厂商或其引用的榜单,决策类基准还没有被社区充分检验;第二,许可证对中大型公司不友好,Mac 上目前也只能跑文本。我的建议是:如果你在做分类、路由类的 Agent 组件,周末花半天在自己的标注数据上测一测,值得;但别因为一张榜单就替换掉已经稳定的方案。