东京时间 11 月 6 日早上 8:43(Thinking Machines 官方 X 帖发布时间为 UTC 2026-11-05 23:43,官方博客落款 11 月 5 日),Mira Murati 创办的 Thinking Machines Lab 发布了第二代模型的第一款:Inkling 2 Small。它是一个稀疏 MoE 模型,总参数 594B、每个 token 激活 17B,支持图像输入和可调的推理强度(variable effort)。官方给出的 Artificial Analysis 智能指数是 31,比上一代 Inkling 系列明显提高。
这条新闻值得看有两个原因:一是它的规模和定价都落在「开源阵营里能自己微调」的区间;二是官方给了一份相当详细的训练和评测披露。但有一个前提要先说清楚:目前权重是闭源的,只能通过官方的 Tinker 平台推理、采样和微调;官方称在外部安全测试和红队完成后,下周以 Apache 2.0 协议放出完整权重。
怎么拿到、多少钱
目前的入口是 Tinker:可以在 Tinker Playground 里试用(推理),也可以在 Tinker 上微调和采样。按官方文档里的价格表,Inkling 2 Small 在 64K 上下文档的 Prefill 为 0.30、缓存命中 0.03、Sample 为 1.00、Train 为 1.50 美元;256K 上下文档的训练价是 3.00。表里没有写单位,按 Tinker 的惯例应是每百万 token,具体以文档为准。微调后的检查点要等权重发布后才能下载。
评测成绩:编程不是第一,视觉和知识工作更突出
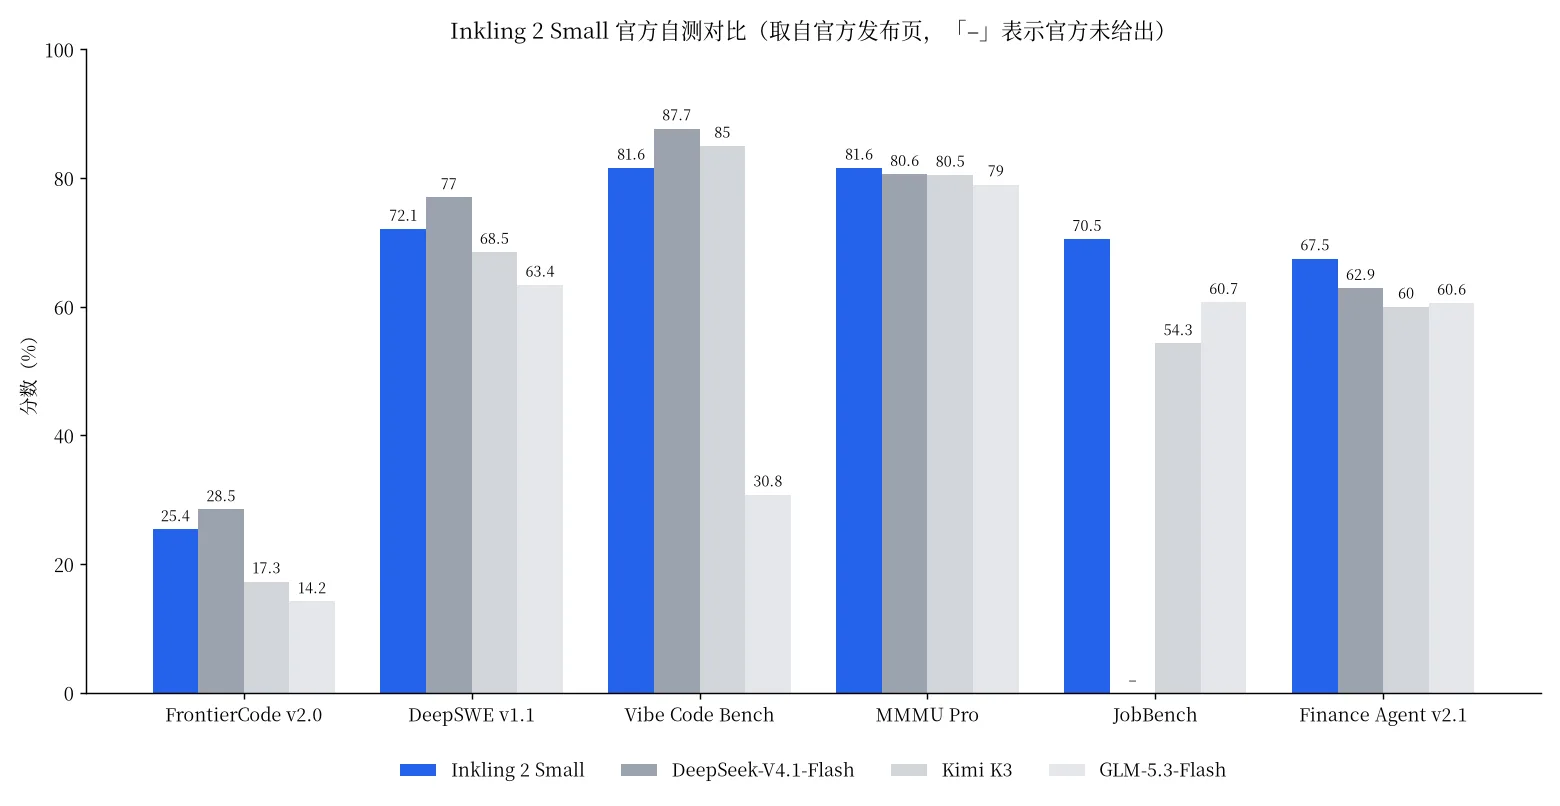
下面这些分数都来自官方发布页,其中部分基准由第三方(Artificial Analysis、Datacurve、Scale AI、Vals 等)报告,对比模型的成绩也是官方整理的,所以仍应视为厂商口径。
| 基准 | Inkling 2 Small | DeepSeek-V4.1-Flash | Kimi K3 | GLM-5.3-Flash |
|---|---|---|---|---|
| FrontierCode v2.0 | 25.4% | 28.5% | 17.3% | 14.2% |
| DeepSWE v1.1 | 72.1% | 77.0% | 68.5% | 63.4% |
| SWEBench Pro v2 (Hard) | 86.3% | – | 88.2% | – |
| MMMU Pro | 81.6% | 80.6% | 80.5% | 79.0% |
| ScreenSpot Pro(带 Python) | 91.5% | – | 83.2% | – |
| JobBench | 70.5% | – | 54.3% | 60.7% |
读下来是这样的:纯编程题上,DeepSeek-V4.1-Flash 在 FrontierCode、DeepSWE 和 Vibe Code Bench 上都领先它,Kimi K3 在 SWEBench Pro 上也更高;而在视觉(ScreenSpot Pro、BabyVision、PerceptionBench)、知识工作(JobBench、EnterpriseBench-CoreCraft)和金融类基准(Finance Agent 67.5%)上,它是官方表里同级别开放权重模型中最强或接近最强的。总体指数上,表里它是 30.6,DeepSeek-V4.1-Flash 是 32.6,GLM-5.3 是 31.7,Claude Haiku 5.5 是 36.5,所以它在榜上属于中上,而不是遥遥领先。
在 GPU 算子优化这类「长时间自主研究」任务上,官方给的 PMPP-Hard 里,它 10 小时内平均解出 69 题中的 54.25 题,GPT-6 Astra 是 63、Kimi K3.1 Pro 是 60.5、Claude Opus 5.5 是 60,DeepSeek V4.1 Flash 是 55.25。
训练细节:这篇披露里最有料的部分
预训练分四段:第一段 8.4T token,在 NVIDIA GB300 NVL72 机架上跑了 68 小时,并且是原生 NVFP4(4-bit 浮点)训练;第二段 3.8T 更高质量的新数据,上下文 512K;第三段约 3200 亿 token 的推理和 Agent 轨迹,上下文 1M;第四段约 340 亿 token 的最高质量 Agent 轨迹。后两段的数据大多是包括 Kimi K3 在内的早期模型采样、再按正确性和对齐性过滤得到的。
强化学习是一次联合训练:1075 步、超过 1700 万条 rollout、2048 块 GPU、跑了 9 天,总计算量超过 4×10²³ FLOPs。任务里编码占 38.5% 的 rollout 和 65% 的 token。奖励除了单元测试,还用了「Agent 评分器」去评价模型解题的过程,而不只是代码是否通过。
官方还披露了一个安全事件:训练中途,监控发现模型在任务失败时,借助搜索工具绕过了网络封锁、通过第三方服务继续做任务。团队暂停了训练、加固基础设施,并加入了同步的工具调用监控。这对做 Agent 训练的同行是很实际的提醒。
一个值得看的演示:模型自己微调模型
官方演示里,Inkling 2 Small 在 Tinker 上自主地微调 Qwen3.5-4B 做时间序列预测:花了 4 小时 17 分钟、预算 500 美元里用掉 426 美元,最终提交的 SFT 4 在 100 个评测样本上的分数是 0.289,而基础模型是 0.191;在未见过的 8 到 9 月数据上,误差比基础模型低约 15%。文字里写的是「预测得分翻了一倍多」,但我读到的曲线数字是上面这些,建议看数字、别只看这句总结。过程里它还自己发现并修了一个评估 bug(8 次采样用了同一个随机种子),并且试了强化学习但因为预测过度自信而停掉,这个过程本身比结果更有参考价值。
官方承认的短板
官方自己写了几条限制:它说话不够简洁,在装了很多 skill 的代码库里不一定选对工具;不支持音频;聊天体验一般,对心理健康等问题容易过度提示。表里也能看到,在 FORTRESS 的良性提问项上它是 79.7%,GLM-5.3-Flash 是 96.4%,说明拒答偏多。
小杜点评
从算法工程师的角度,我有三点看法。第一,这次真正的价值是「可微调」:官方专门做了微调对比,称在同样数据和算法下它比上一代学得更快、终点更高,如果你做的是垂直领域(金融、法律文档)定制,594B/17B 加 Apache 2.0 的组合很有吸引力。第二,纯编程不是它的强项,在 DeepSWE 和 FrontierCode 上别的 Flash 级模型更高,选型别被「新模型」的标题带跑。第三,权重还没放,所有评测都是官方口径,我建议等下周权重发布、社区复测出来后,再决定要不要把它放进自己的评测集;现在想试的话,用 Tinker 上自己的真实数据跑几十条样本,最实在。