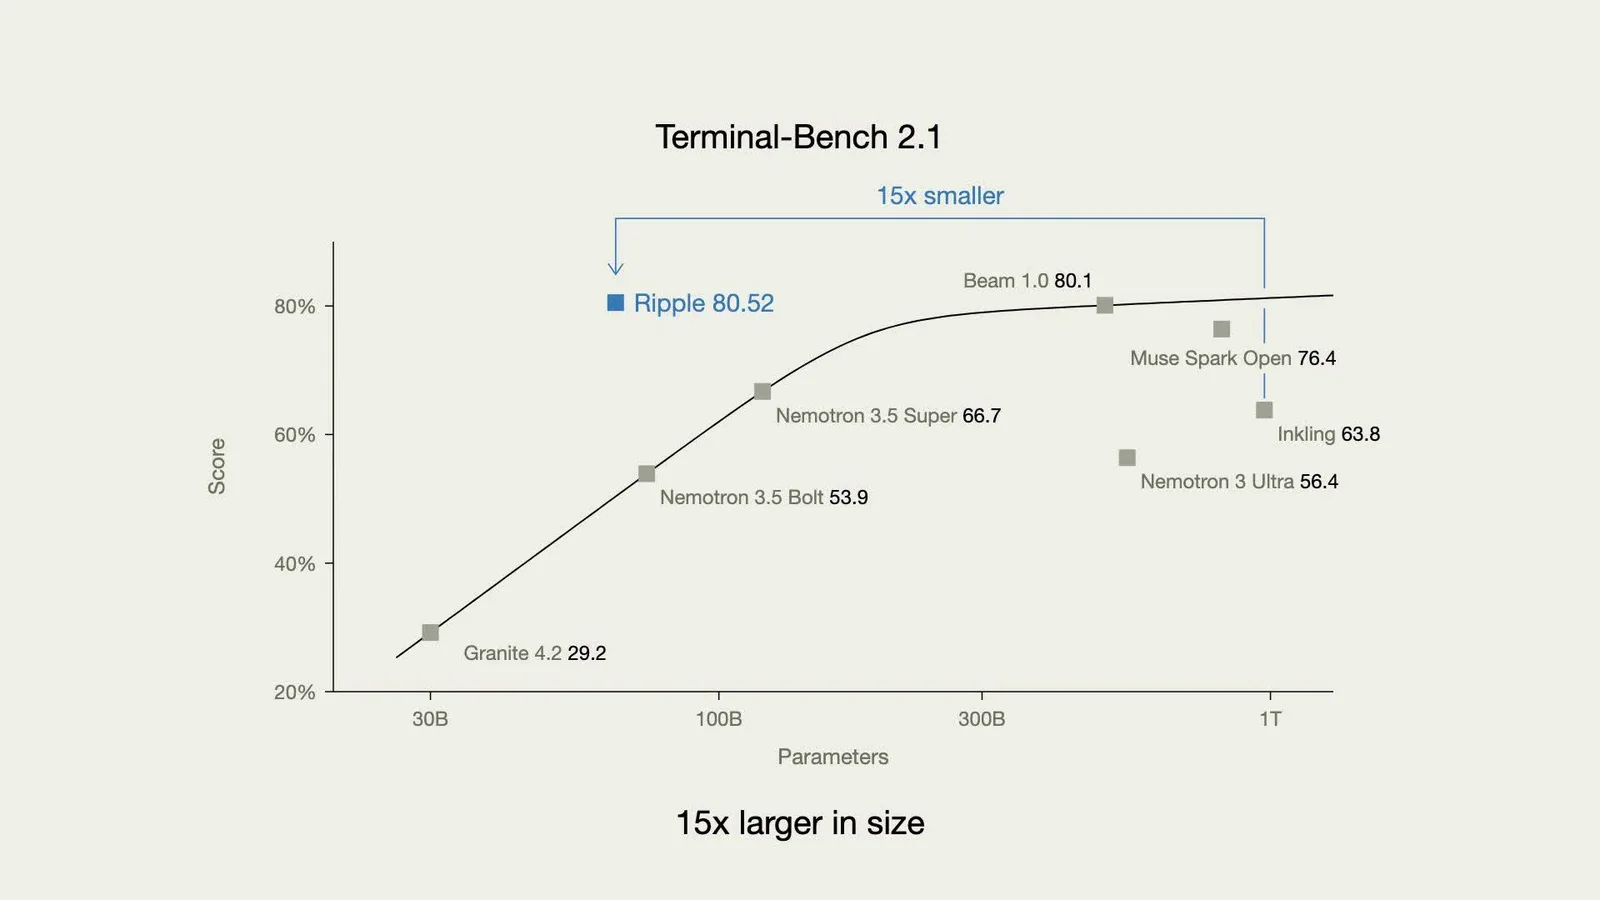
东京时间 11 月 5 日凌晨 3:24(美国时间 11 月 4 日),美国创业公司 Ricursive Intelligence 发布并开源了 Ripple-65B Preview:一个从零预训练的 650 亿参数 Dense(稠密) 模型,12T token 预训练、支持最长 1M 上下文,Apache 2.0 许可,权重直接放在 Hugging Face 上不设门槛。官方自测在 Terminal-Bench 2.1 上拿到 80.52,超过 Reflection Beam 501B、Meta Muse Spark Open 816B 等大它好几倍的美国开放权重 MoE 模型。更值得算法工程师关注的是两件事:官方称全部研发成本只有 3200 万美元,而且模型小到能塞进一台 DGX Spark 本地跑。
发布了什么
按官方博客和 Hugging Face 模型卡,这次 Preview 一共放出三个权重:
- Ripple-65B Preview(BF16 指令版):主力版本。第三方 OrcaRouter 统计为 16 个 safetensors 分片、约 129.6 GB。
- Ripple-65B Preview NVFP4:实验性 4-bit 版本,只量化 MLP、注意力保留 BF16,约 57.2 GB(同样据 OrcaRouter 统计)。
- Ripple-65B Base Preview(BF16 基座):纯预训练检查点,没有做中期训练,也没混合成问答数据,适合想自己做后训练的团队。
调用渠道方面,官方列出 Hugging Face、Together AI、GMI Cloud、OpenRouter,Fireworks 随后上线。Ricursive 的主业是 AI 芯片设计,这个模型是它内部芯片设计平台所用专有模型的通用版本,完整技术报告官方说"即将发布"。
成绩怎么看:厂商自测,口径要分清
下面这些分数都来自官方模型卡,属于厂商自测。模型卡里 Terminal-Bench 2.1 给了两套口径:
| 模型 | 总参/激活 | TB2.1(各家自报) | TB2.1(Terminus 2 统一口径) |
|---|---|---|---|
| Ripple-65B Preview | 65B / 65B | 80.5 | 80.5 |
| Reflection Beam | 501B / 23B | 80.1 | 70.8 |
| Muse Spark Open | 816B / 42B | 76.4 | 78.7 |
| Inkling | 975B / 41B | 63.8 | 56.2 |
| Nemotron 3 Ultra | 550B / 55B | 56.4 | 55.1 |
官方在 X 上补充说明,Ripple 的 TB2.1 用的是官方 Terminus 2 harness、128K 序列长度,而其他家自报分数通常用的是自家 harness 和更长序列;模型卡也坦言换成统一口径后,除 Muse Spark Open 外其他模型的分数普遍下降。所以"统一口径"那一列更有参考价值,Ripple 在这一列依然第一。
但它不是全面领先。同一张表里,SWE-bench Verified 76.5 低于 Beam 的 81.6;MCP Atlas 71.67 明显低于 Muse Spark Open 的 89.2;DeepSWE 1.1 是 44.3 对 60.0;SciCode 39.4 是表中最低。数学方面 AIME 2025 98.3、HMMT Feb 2026 90.5,都在第一梯队。
3200 万美元是怎么省出来的
官方把低成本归结为几个工程选择,这部分对做训练的同学最有借鉴价值:
1. 选 Dense 而不是 MoE。 官方说这样能大幅降低预训练和后训练的基础设施复杂度:不需要定制 kernel、不做量化、只用简单的分片,整个训练过程 MFU 保持在 40% 左右,团队规模从 1 人扩到 5 人。
2. "瘦而深"的结构。 d_model 只有 5120,但有 80 层;多配注意力头,同时提高滑动窗口注意力(SWA)与全局层的比例、缩小 SWA 窗口来抵消开销;再加上 FFN 激活裁剪、sigmoid 门控注意力、全局层不用位置编码(NoPE)、value residual,归一化从 post-norm 换成 pre+post norm。
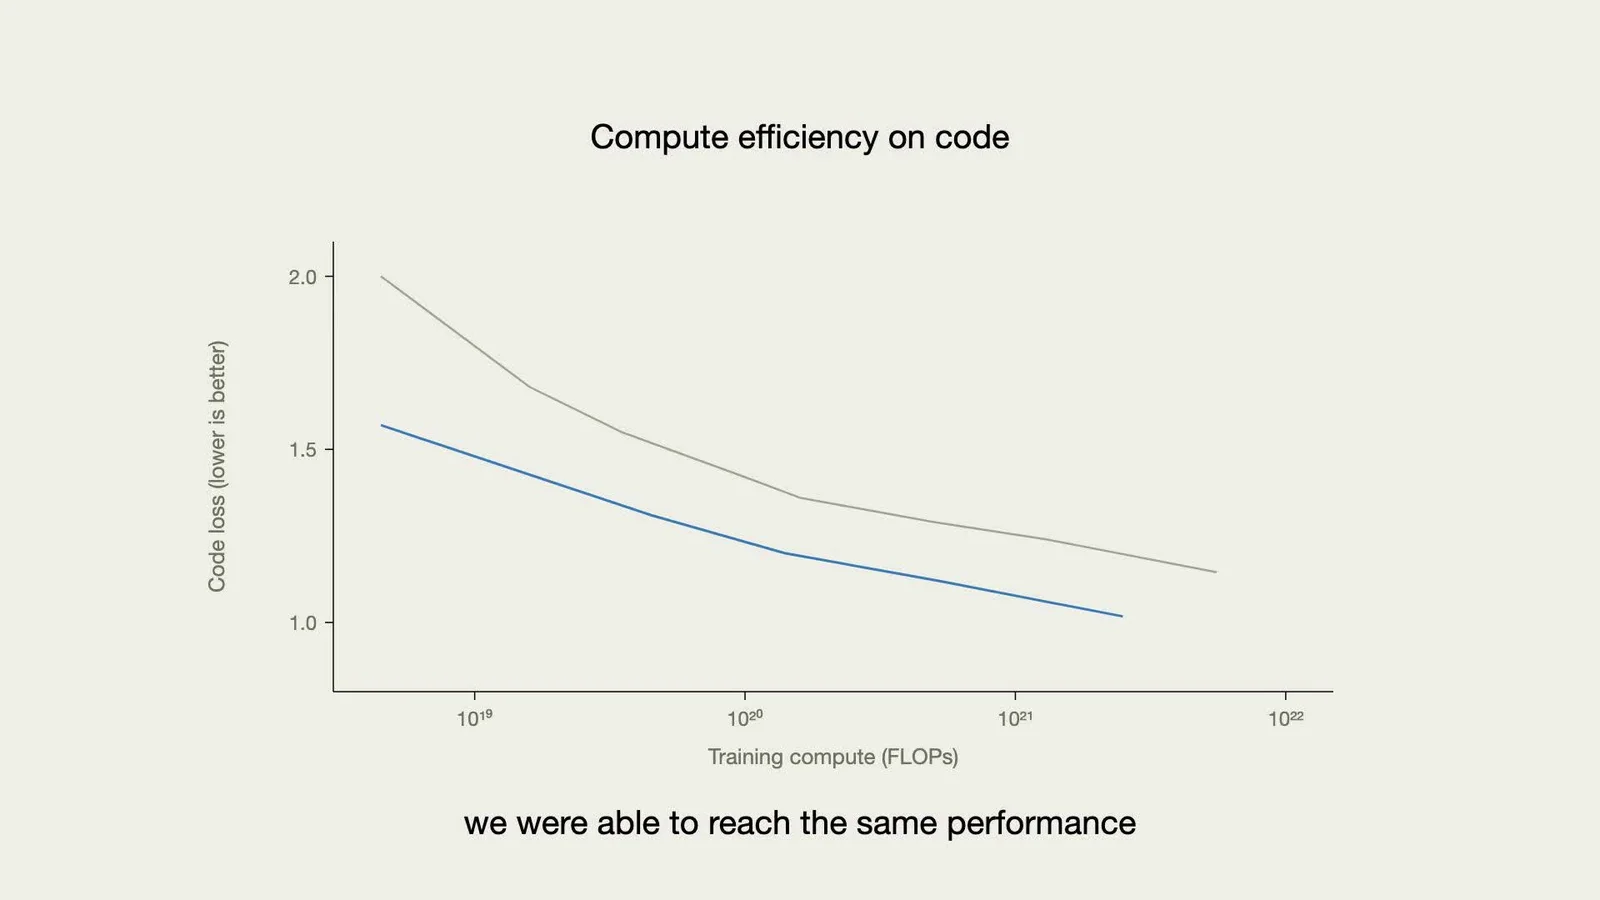
3. 小模型阶梯(model ladder)先验证。 起点是 AI2 的 Olmo 3 阶梯,每个改动先在小规模上验证。比如 2-stream mHC 在小规模有效、到 4B 就不涨了,于是被弃用。官方称最终阶梯在 4B 规模上把代码方向的计算效率提高到 Olmo 3 的 16 倍,完整训练时最高达 55 倍。
4. RL 讲究效率。 不买后训练数据,全部自建合成数据管线;RL 用了截断重要性采样、分数中心化和线性长度惩罚,并随模型变强不断加难任务。官方称只用 140 万次 rollout 就到了 TB2.1 80.5,比 Beam 少约 70 倍。
训练流程也写得很清楚:12T token 预训练(8K 序列)→ 200B 中期训练(64K)→ 6.5B 长上下文(2M)→ 183B SFT(128K)→ 13.5B 长上下文 SFT → 700 步 RL(128K)。
需要说明的是,"3200 万美元"是官方口径的全部研发成本(包括阶梯实验、数据配比、评测、调试、合成数据和最终训练),"约为上一代开放权重 SOTA 的十分之一"是官方按公开信息做的估算。
对开发者意味着什么
- 本地能跑。 65B 稠密模型 BF16 权重约 130 GB,NVFP4 版约 57 GB。官方在 X 上回复说 NVFP4 在 DGX Spark 上平均约 40 tok/s;数据中心上 2×B200、batch=8 未量化可达 250 tok/s(模型卡数据)。
- Apache 2.0。 没有月活或营收门槛,商用、微调、蒸馏都比较省心。
- 上下文别只看 1M。 模型卡写"最高支持 1M",但第三方 OrcaRouter 指出首个商用接口只开放了 16,384 token。用 API 之前先确认服务商实际给的上下文长度。
- 中文要实测。 官方说预训练语料"以英文和代码为主、纯文本",基座模型的 C-Eval 是 69.6,在同表几款基座里最低。中文场景和多模态场景都不是它的强项。
上手建议: 想快速试,先走 OpenRouter 或 Together AI 跑一下自己的 Agent 任务;想本地部署,优先看 NVFP4 版和官方提供的 Colab;想做领域后训练,Base 版是个干净的起点。
小杜点评
这次发布最有意思的不是"又一个榜单第一",而是它在反潮流:大家都在堆 MoE、动辄几千亿到上万亿参数,Ripple 用一个 65B 稠密模型、5 个人的团队、不写定制 kernel,就在 Agent 编程上追平了大它 7~15 倍的模型。从算法工程师的角度看,最值钱的是那套 model ladder 方法论,每个结构改动都先在小规模上验证、到 4B 不涨就砍掉,这比任何单一技巧都更可复制。
当然,Preview 还是 Preview。表格里的数大多是自测,它在 MCP 工具调用、科学编程和中文上都有明显短板,1M 上下文目前也没在商用接口上兑现。我的建议是:把它当成"本地可跑的英文编程 Agent 底座"来评估,用自己的任务集测一轮,别只看 TB2.1 一个数。等技术报告出来,阶梯实验的细节值得认真读一遍。