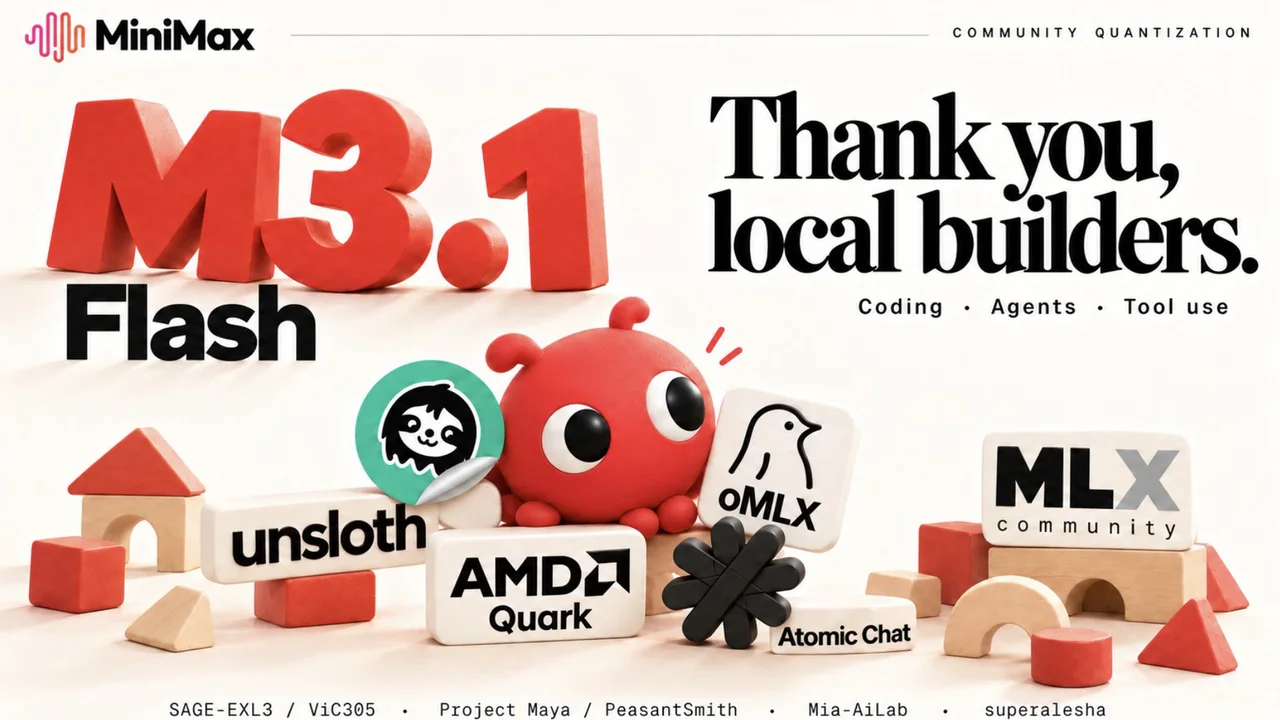
北京时间 11 月 2 日清晨 5:49,MiniMax 官方账号发了一条「感谢本地开发者」的长帖,把社区为 MiniMax M3.1 Flash 做的量化、内核和部署方案逐一点名:Unsloth 的 2-bit 动态 GGUF(143.9 GB)、单台 DGX Spark 的方案、4 张 RTX 3090 加系统内存的跑法、Apple Silicon 上的 MLX 量化、AMD Instinct 的 MXFP4 版本等。M3.1 Flash 是一个 428B 总参数、每 token 激活 23B 的多模态 MoE 模型,权重在 10 月下旬放出。官方这条帖子的意义在于:它等于给出了一份「这个模型在哪些硬件上能本地跑、要付出多少精度」的官方认可清单。对想在自己机器上跑大模型的工程师来说,这比又一张榜单更实用。
先认识一下 M3.1 Flash
根据 Hugging Face 上的官方模型卡,M3.1 Flash 的关键参数是:
- 规模:约 428B 总参数,每 token 激活 23B,原生支持文本、图片、视频输入,输出文本;
- 上下文:最长 100 万 token;
- 相比 M3 的三处改动:全模型改用 MiniMax 稀疏注意力(前 3 层原本的全注意力也换掉了);对路由专家和注意力做了量化感知训练(QAT);用 DSpark 推测解码替代了之前类似 EAGLE 的 MTP,并随权重附带 draft head;
- 许可证:minimax-community 自定义许可,商用前要自己读一遍条款。
官方表格里的成绩(厂商自测):DeepSWE v1.1 为 73.7%,OSWorld 2.0 为 61.7,Terminal Bench 4.0 为 38.1,CyberGym 为 82.2。同一张表里,DeepSeek V4.1 Flash-1017 在 DeepSWE(77.0)和 Terminal Bench(42.3)上更高,所以它不是全面领先,强项更偏 Agent 自动化和工具调用(Automation-Bench 62.8,BankerToolBench 76.2)。模型卡也特意写了一句:这些结果针对官方权重,第三方量化可能不同。这句话正是下面要讨论的重点。
官方点名的几条本地路线
MiniMax 的帖子里提到的社区工作,按硬件大致可以分成几类:
- 通用 CPU+GPU 混合(llama.cpp 生态):Unsloth 发布了从 1-bit 到 8-bit 的动态 GGUF,并配了详细的精度测试;Atomic Chat 也提供了面向桌面的 GGUF。
- 大内存 PC + 专家缓存:PeasantSmith 的 Project Maya 把最常用的专家放在 GPU 上,其余从内存计算;superalesha 在 4 张 RTX 3090 上结合量化权重、专家缓存和系统内存跑通了自定义推理。
- DGX Spark:ViC305 做了 SAGE-EXL3 量化,给出了逐 token 的保真度测量和单台 DGX Spark 的部署方案;Mia-AiLab 做了 EXL3-EAQ 量化。
- Apple Silicon:jundotkim 和 mlx-community 做了 oQ 量化,并通过 oMLX 支持 DSpark 解码。
- AMD 数据中心卡:AMD 官方把路由专家从 NVFP4 转成 OCP MXFP4,面向 MI350/MI355,用 vLLM 或 SGLang 4 卡张量并行部署。AMD 模型卡里 GSM8K(4-shot)从原始权重的 97.2% 到 96.9%,恢复率 99.69%(AMD 自测)。
到底要多大内存:看数字说话
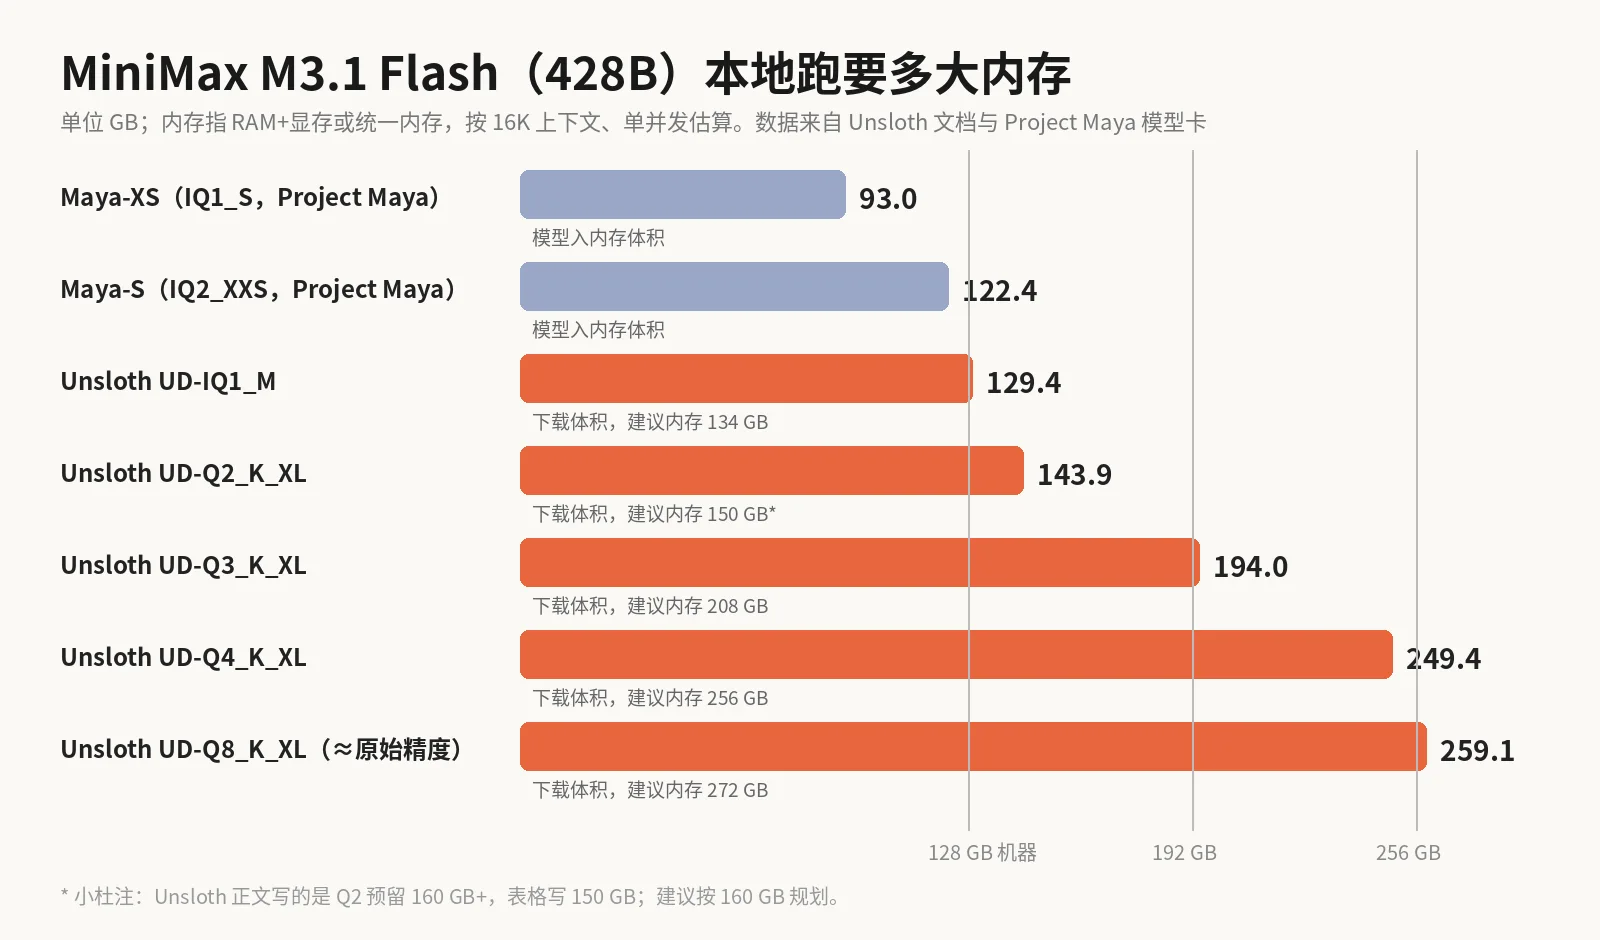
上图把几个有公开数据的方案放在一起。需要注意,MoE 虽然每 token 只激活 23B,但全部权重仍然要放进内存(RAM+显存,或 Mac 的统一内存),只是可以把一部分专家卸载到 CPU。
Unsloth 文档给出的规划值(16K 上下文、单并发):
| 量化 | 下载体积 | 建议 RAM+显存 |
|---|---|---|
| UD-IQ1_M(1-bit) | 129.4 GB | 134 GB |
| UD-Q2KXL(2-bit) | 143.9 GB | 150 GB(正文另写 160 GB+) |
| UD-Q3KXL(3-bit) | 194.0 GB | 208 GB |
| UD-Q4KXL(4-bit) | 249.4 GB | 256 GB |
| UD-Q8KXL(无损转换) | 259.1 GB | 272 GB |
精度方面,Unsloth 用「与原始模型 top-1 token 一致率」来衡量(Unsloth 自测):Q2 在通用聊天上是 88.5%、数学 95.7%;Q4 升到 97.3% 和 99.0%。Q8 只比 Q4 大 9.7 GB,原因是 MiniMax 本身就用 NVFP4 存 MoE 层,Q8 基本是原格式直转。
如果你只有一台 128 GB 的机器,Project Maya 给了一个更激进的选择:Maya-XS 在内存里只占 93.0 GB,代价是各类任务平均 top-1 一致率降到 82.6%;Maya-S 占 122.4 GB,平均 87.6%(作者自测)。值得注意的是它分项差异很大:Maya-S 在代码上 93.7%,聊天只有 76.4%。也就是说,低比特量化对代码和工具调用的伤害,比对闲聊小,这对拿它做编程 Agent 的人是好消息。
实操建议
- 先定任务,再定比特数。主要跑编程和工具调用,2-bit 到 3-bit 可以先试;要做多语言或长文写作,尽量上 Q4。
- 按 160 GB 规划 Q2。Unsloth 文档里表格写 150 GB、正文写 160 GB+,两者都只按 16K 上下文估算;开长上下文、加视觉投影器(mmproj-BF16 约 1.74 GB)或 DSpark,都要再留余量。
- 注意 llama.cpp 版本。文档要求用带 MiniMax-M3.1 支持的构建(PR #31192),旧版 llama.cpp 加载不了。
- DSpark 值得开。Unsloth 在模型卡里测到,
--spec-draft-n-max 1时代码和数学约提速 1.5 倍,闲聊收益小;draft 文件约 2.1 GB。 - 量化后自己测一遍。模型卡里的分数来自官方权重,你实际用的量化版要拿自己的任务回归一下,特别是工具调用的格式稳定性。
小杜点评
这条帖子本身没有新模型、新分数,但我觉得比很多发布会更有信息量。一是它说明 QAT 这条路开始见效:M3.1 Flash 训练时就把专家和注意力量化过,所以社区做低比特版本时损失更可控,Unsloth 的 Q4 和 Q8 只差 9.7 GB,就是这个原因。二是「top-1 一致率按任务拆开看」这件事很重要,Maya 的数据显示代码能保住九成以上、聊天掉得最多,这和我们平时只看一个平均 PPL 得到的结论很不一样。三是厂商主动给社区量化背书,说明开源权重的竞争已经从「谁分数高」延伸到「谁更好部署」。实际落地时,我的建议还是那句话:别只看下载体积,按内存规划、按任务选量化、用自己的测试集回归,再决定上不上生产。