北京时间 11 月 5 日凌晨 1 点,月之暗面(Moonshot AI)在官方 X 账号发了一句话:「Releasing the model weights of Kimi K3.1 Pro」,同时 Hugging Face 上的 moonshotai/Kimi-K3.1-Pro 仓库正式开放下载。这兑现了 10 月 24 日发布模型时「11 月 4 日前放出完整权重」的承诺。K3.1 Pro 总参数 2.8T、每个 token 激活 104B,支持 100 万 token 上下文和图文输入,按官方模型卡的数据,它在 Terminal-Bench 4.0 等多项编程和 Agent 基准上已经和 Claude Opus 5.5、GPT-6 Astra 这一档闭源旗舰站在一起。对做模型和 Agent 的工程师来说,这是目前能拿到手的最大、也最接近闭源前沿的开放权重之一,值得认真看一下它的结构、成绩和许可证边界。
先看清时间线:这次发的是权重
K3.1 Pro 不是今天才有的模型。官方技术博客的日期是 10 月 24 日,当时上线的是 Kimi.ai、Kimi Work、Kimi Code 和 API 服务,同时还发了一个速度快 2~3 倍的 Kimi K3.1 Pro Highspeed(官方说法)。这次的新闻点是完整权重开放:仓库里是 96 个 safetensors 分片,加上配置、处理器和自定义建模代码,合计约 1.56 TB(按 Hugging Face API 列出的文件大小统计)。同一天,vLLM 官方博客也发文宣布首日支持。
架构要点:线性注意力 + 稀疏注意力的混合 MoE
模型卡给的结构信息比较完整,几个值得算法同学注意的点:
- MoE 规模:896 个专家,每个 token 选 16 个,另有 2 个共享专家;93 层里只有第 1 层是稠密层。
- 混合注意力:69 层 KDA(Kimi Delta Attention,一种线性注意力)+ 24 层 Gated DSA(门控版 DeepSeek 稀疏注意力)。官方说明,和 K3 相比,原来的全注意力 Gated MLA 层被换成了 Gated DSA,目的是让长上下文更高效;DSA 索引器每次取 top-2048 个 token。
- 原生低精度:权重 MXFP4、激活 MXFP8,而且是量化感知训练(QAT)得到的,不是训练完再压。这也是 2.8T 参数能压到 1.5 TB 级别的原因。
- 多模态:视觉编码器 MoonViT-V2,401M 参数,支持文本和图像输入。
- 上下文:1,048,576 token。
从结构上看,K3.1 Pro 是 post-training 的升级:官方称它在 K3 基础上用了大得多的后训练算力,在数百个下游领域做联合强化学习。
成绩怎么读(均为厂商汇总)
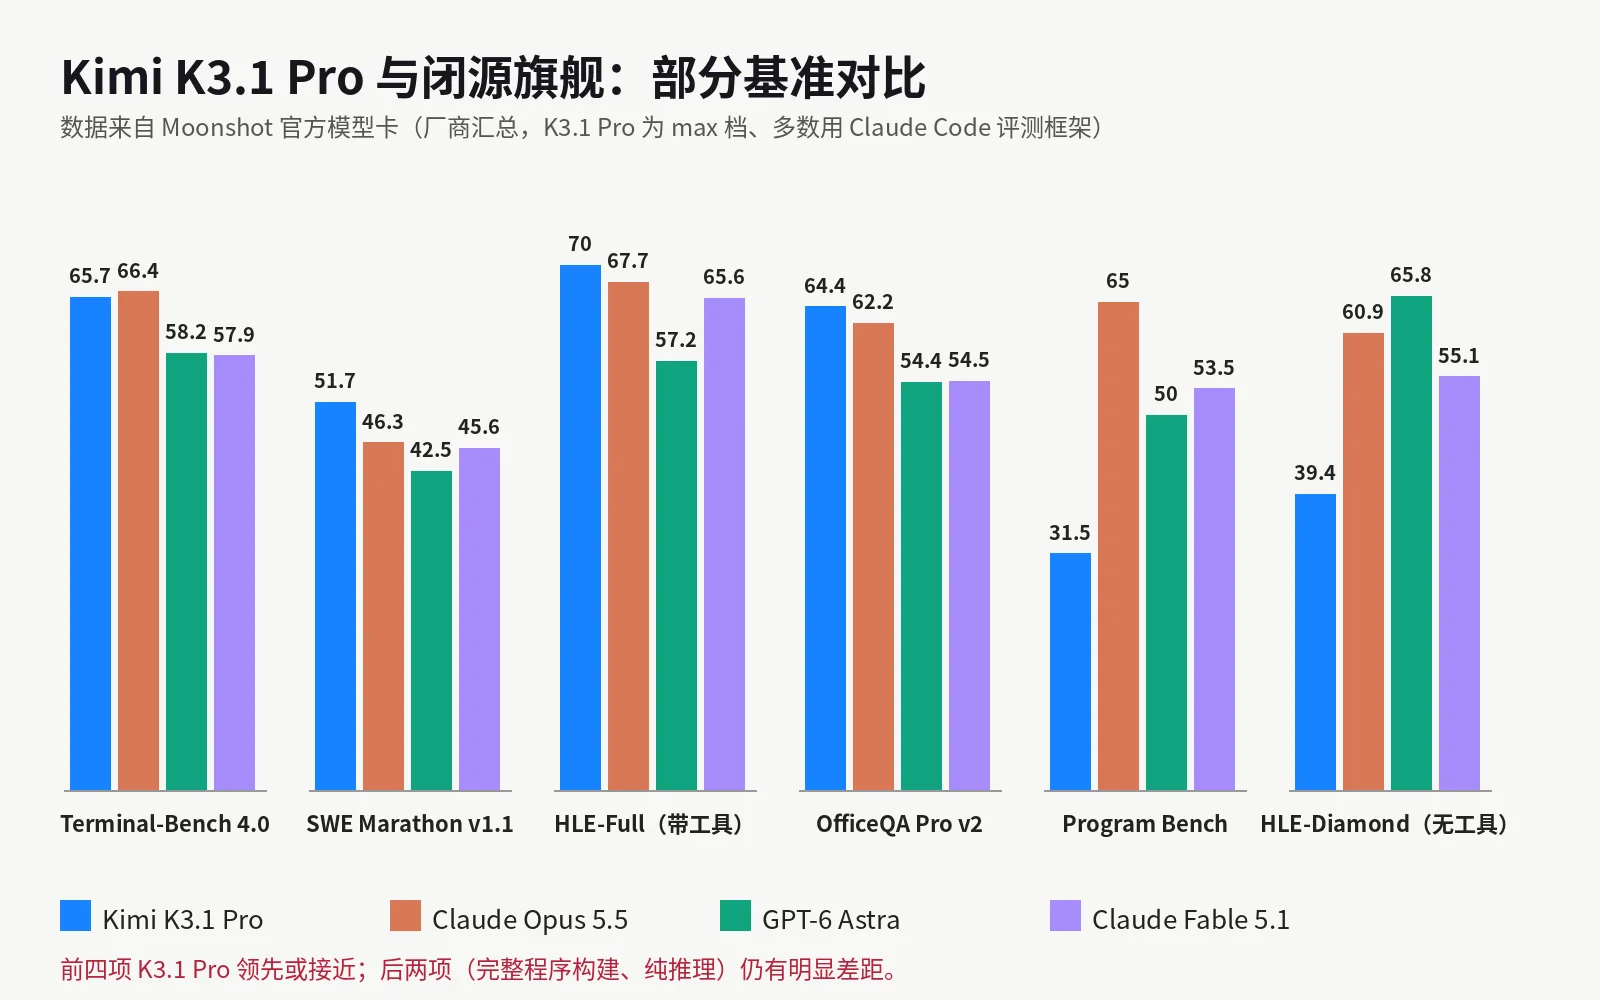
模型卡里的对比表很长,挑几项有代表性的(K3.1 Pro 用 max 推理档,编程类大多在 Claude Code 评测框架下跑):
- Terminal-Bench 4.0:65.7,Claude Opus 5.5 是 66.4,GPT-6 Astra 是 58.2;
- SWE Marathon v1.1:51.7,表中最高(Opus 5.5 为 46.3);
- HLE-Full(带工具):70.0,表中最高;
- OfficeQA Pro v2:64.4,表中最高;
- OSWorld V2.1:79.6,略低于 Opus 5.5 的 81.8。
短板也写得很清楚:Program Bench 只有 31.5(Opus 5.5 为 65.0),HLE-Diamond(无工具) 39.4,明显落后于 GPT-6 Astra 的 65.8;网络安全的 ExploitGym 也只有 20.7。需要提醒的是,这些数字一部分是 Moonshot 自己跑的,一部分是从别家报告和排行榜引用的,评测框架也不完全一样,还有几项是内部基准。看趋势可以,别当严格的同条件对比。
许可证:大多数团队可以放心用,但有两条线
许可证是「修改版 MIT」,允许使用、修改、分发、微调和商用,额外条件有两条:
- 如果你(含关联公司)做的是「模型即服务」(让第三方通过 API 等方式自由控制输入、参数或训练数据),并且连续 12 个月总收入超过 2000 万美元,商用前需要和 Moonshot 另签协议;
- 产品月活超过 1 亿或月收入超过 2000 万美元,需要在界面上醒目展示「Kimi K3.1-Pro」。
纯内部使用、或通过官方产品和认证推理伙伴使用,不受这两条限制。对绝大多数公司和个人开发者来说,基本等同于宽松许可。
对开发者的实操建议
- 先算显存。1.56 TB 的权重,8 张 80 GB 的 H100(合计 640 GB)连权重都放不下;社区讨论里普遍认为至少要 8 卡 B300 这种级别的单节点。个人和小团队更现实的路径是用 API 或第三方托管。
- 推理引擎选官方推荐的三个:vLLM、SGLang、TokenSpeed,模型卡都给了 recipe。vLLM 首日支持里专门做了 KDA 混合架构的稀疏注意力、FP8/NVFP4 latent 加 MXFP4 index key 的打包 KV 缓存、按 token 分片的 prefill 和解码上下文并行。
- API 调用注意思考内容回传。官方 API 是
kimi-k3.1-pro,兼容 OpenAI 和 Anthropic 格式;推理强度用顶层字段reasoning_effort(low、high、max,默认max)。多轮对话和工具调用时,必须把助手消息原样传回,包括reasoning_content和tool_calls,只传content会丢上下文。 - 评测用自己的任务。如果你在选 Agent 的底座模型,建议在自己的代码库和工具链上跑一轮,重点看长链路任务和完整程序构建,这正是它和闭源模型差距最大的地方。
小杜点评
站在算法工程师的角度,这次开源最有价值的地方有三个。第一,它把「线性注意力为主、少量稀疏注意力兜底」的混合方案推到了 3T 级别并公开了完整配置,69:24 的层配比、top-2048 的稀疏索引,都是可以直接拿来研究和借鉴的工程选择。第二,MXFP4 量化感知训练的权重本身就是一个信号:前沿模型的发布形态正在从「BF16 训练、社区再量化」变成「原生低精度交付」,推理侧的软硬件都得跟上。第三,许可证对中小团队很友好,做私有化部署、领域微调的空间很大。保留意见也很明确:成绩基本是厂商汇总,Program Bench 和无工具推理的短板说明它离全面追平闭源还有距离;而 1.5 TB 的体量意味着「开放权重」对大多数人来说更像是「可以选择任何托管商」,而不是「能在自己机器上跑」。我的建议是:做 Agent 和长上下文应用的团队可以把它列进候选名单,用自己的任务实测;想研究架构的同学,config.json 和建模代码值得逐行读一遍。