美国时间 11 月 9 日,Anthropic 发布了 Claude Fable 5.2 和 Claude Mythos 5.2,这是它目前最强的两个模型。说它们是“两个”其实不太准确:Anthropic 明确表示,Fable 和 Mythos 是同一个底层模型,区别只在于安全护栏的松紧、以及谁能用。Fable 面向所有人,Mythos 只给通过审核的机构。
比起 5.1,这次升级的组合很实在:输出快了最多 30%,价格降了 20%,还加了一个最快 2.5 倍的 fast mode。随发布一起放出的成绩单也很抢眼:FrontierCode 2.0 上 49.1%,超过 Opus 5.5 和 GPT-6 Astra;1000 个 Agent 用 30 小时把费马大定理的形式化证明做完了。当然,所有数字都是 Anthropic 自己测的,下面逐项拆开看。
同一个模型,两扇门
Fable 和 Mythos 的关系,是这次发布最值得先搞清楚的一点。Anthropic 的说法是:同一个模型,两种准入。Fable 5.2 带有很强的安全分类器,会拦截大多数网络安全和生物研究类请求,正因为有这层护栏,它才能向所有人开放;Mythos 5.2 是去掉这部分限制的同一模型,只提供给通过网络安全验证计划(Cyber Verification Program)或生命科学验证计划(Life Sciences Verification Program)审核的机构。
对开发者来说,这个设计有个实际影响:如果你在 Fable 5.2 上跑安全测试类任务,大概率会被拦截——被拦截时你不会收到报错,而是悄悄拿到另一个较弱模型的回答:网络安全类请求由 Opus 4.8 代答,生物类请求由 Opus 5 代答。流水线里如果依赖“到底是哪个模型回答的”,记得把实际回答方记下来。
好消息是误拦少了很多。Anthropic 称,相比 Fable 5.1,5.2 的不必要拦截减少了约 55%,其中网络安全类约 60%、生物类约 40%。这对日常使用是实打实的改进:以前那种“明明是正经的安全研究却被拒”的情况会少很多,但底线没变——渗透测试、漏洞利用生成、二进制漏洞挖掘这类请求,Fable 5.2 依然会拦。
企业用户也可通过 Claude Security 调用 Mythos 5.2 扫描代码库。
更便宜、更快:价格账怎么算
标准价从每百万 token 输入 10 美元、输出 50 美元,降到了输入 8 美元、输出 40 美元,降幅 20%。Anthropic 还给了一个可选的 fast mode:生成速度最高快 2.5 倍,代价是价格翻倍——输入 16 美元、输出 80 美元,赶工期划算,日常跑量没必要开。
输出速度本身也快了:Anthropic 称 5.2 在各个 effort 档位上都比 5.1 快最多 30%。第三方榜单 Artificial Analysis Intelligence Index v5 上,Fable 5.2 以 65 分登顶,领先 Gemini 4 Carbon 的 60 分;但按同一榜单估算,它每个基准任务约 26.5 美元,是 Gemini(约 7 美元)的三倍多——最强,也是最贵。
Anthropic 自己的 effort 档位建议也值得参考:Claude 应用和 Claude Code 里默认是 Medium;High effort 下,Fable 5.2 在 FrontierCode 2.0 上的得分约等于 Opus 5.5 开 Max effort 的水平,而每个任务的成本大约只有一半。
跑分:强在哪,哪里没赢
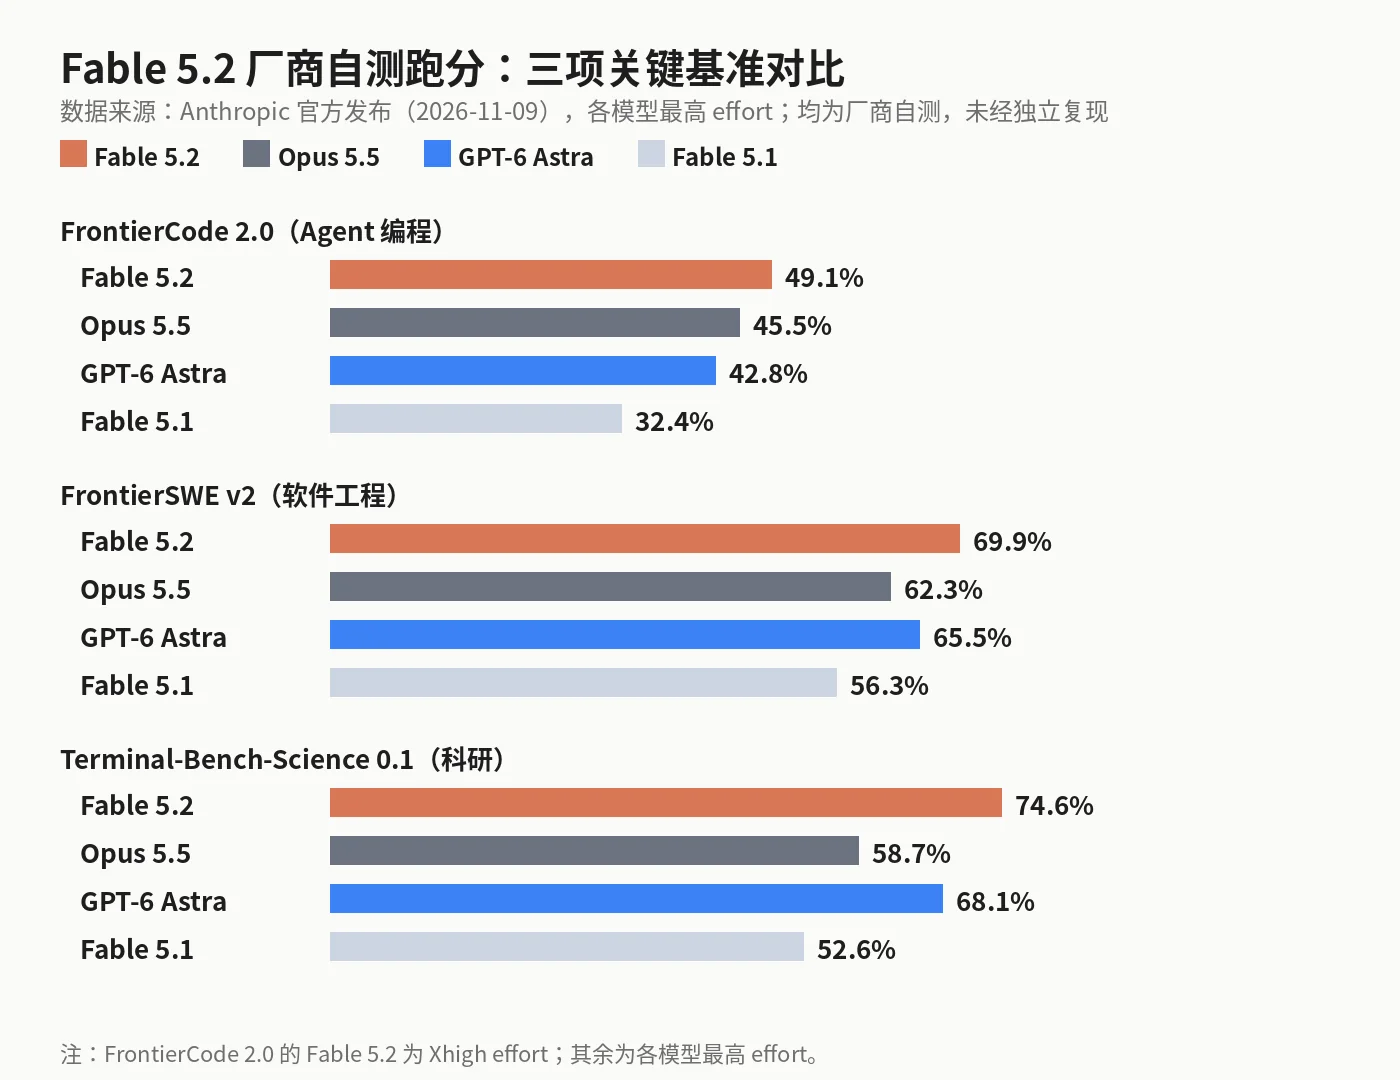
先看领先的部分。Agent 编程基准 FrontierCode 2.0,Fable 5.2(Xhigh effort)49.1%,上一代 Fable 5.1 是 32.4%,Opus 5.5 为 45.5%,GPT-6 Astra 42.8%,Gemini 4 Carbon 41.1%。FrontierSWE v2 为 69.9%,比 5.1 高 13.6 个百分点;科研 Agent 基准 Terminal-Bench-Science 0.1 为 74.6%(Mythos 5.2 是 75.3%),上一代只有 52.6%。机器人模拟 RoboDojo Sim,64.9%,上一代 27.6%,GPT-6 Astra 29.8%——直接翻倍还多。
但这张表也不是全胜。商业流程基准 AutomationBench,Fable 5.2 是 51.4%,Gemini 4 Carbon 53.9% 排第一;知识工作基准 AA-Briefcase v1.1 的 Elo 评分,Opus 5.5 以 1800 分领先,Fable 5.2 是 1785 分。Anthropic 自己的总结是“在几乎所有能力上都领先 Opus 5.5”——关键词是“几乎”。以上全部是厂商自测,方法论在 system card 里,发布时还没有独立复现,跑分可以用来判断方向,不能直接当成你自己工作负载上的承诺。
不只是写代码:黑洞、费马、电路板
这次发布花了相当大的篇幅讲写代码之外的事,而且每件都带着可验证的细节——至少是 Anthropic 单方面给出的细节。
数学上最抓眼球的是费马大定理:1000 个 Fable 5.2 Agent 在 30 小时内把证明完整形式化进了 Lean,人工干预极少。Anthropic 第一次做这件事用了 11 天,还依赖专门搭建的 harness 和研究员指导;这次只用了三分之一的 action token,证明还短了七倍。同一配置下 Opus 5.5 在 18 小时里只完成了 26%。需要提醒的是,这是形式化已有证明,不是发现新证明。
理论物理方面,Fable 5.2 用全息对偶的思路解决了两个黑洞开放问题:一个是 2003 年列出、因计算量太大一直没做完的计算,结论是极小宇宙里的黑洞形成转变同样是突变的;另一个是给一种用了 15 年以上的方法找到了精确适用边界。Anthropic 挂了预印本链接,但同行评议情况未说明,应按“研究主张”对待,而非已定论的结论。
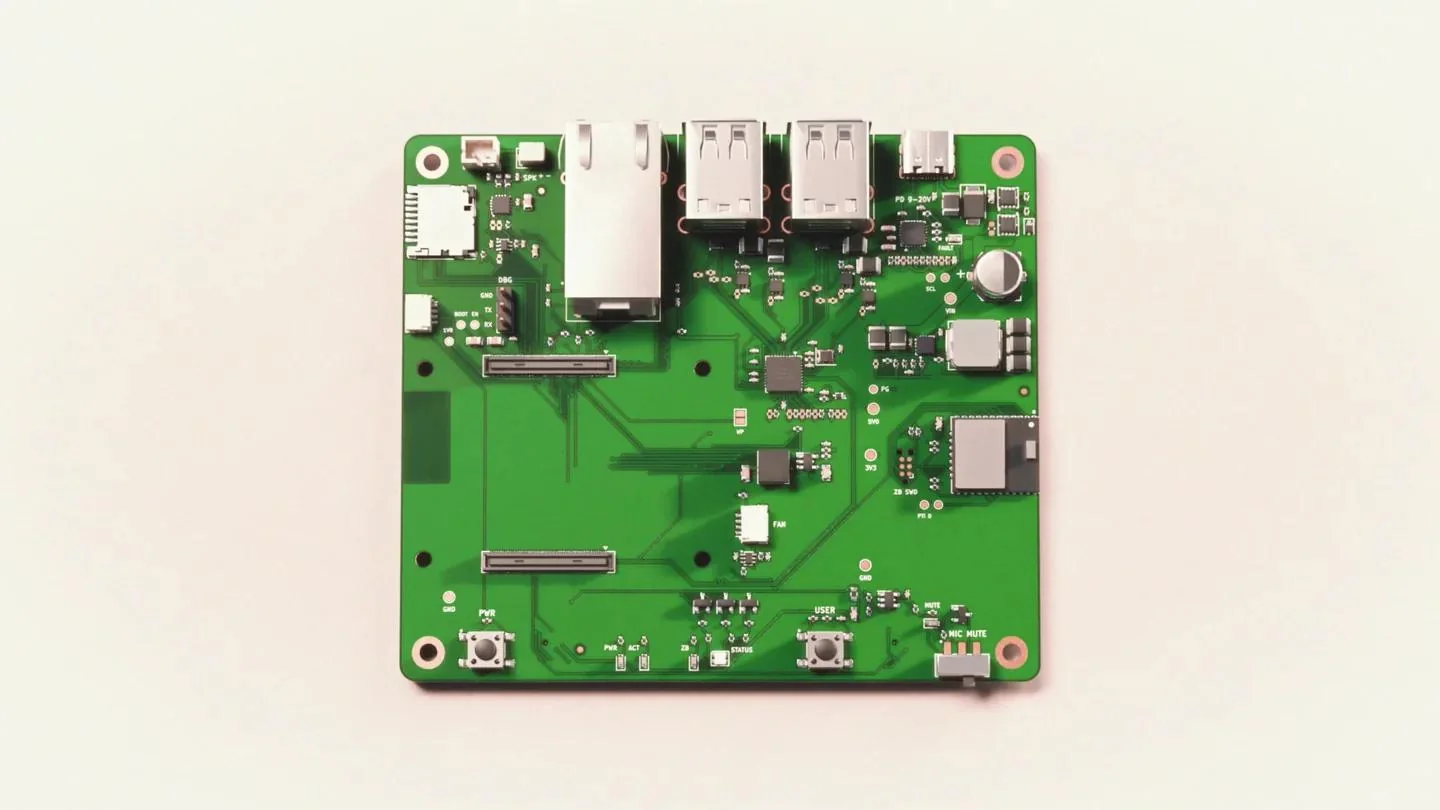
硬件是另一块亮点:只给一段话提示,Fable 5.2 就从零设计并做出三台能工作的电子设备——家用语音助手 Hub、USB 扬声器电话和掌上虚拟宠物,每台都有自己画的四层电路板、3D 打印外壳和软件。合作方 Diode 负责生产,每块板子不到一天就能交付,三台设备装好后都不需要任何电气修改就能工作。
还有一个更夸张的实验:一位 Anthropic 工程师让 Fable 5.2 从空文件夹开始设计一个原型操作系统,1000 多个子 Agent 连续工作八天,写出了能在一台笔记本上启动的系统——自己的内核、磁盘/键盘/网络驱动、永久文件存储、窗口、登录界面、安装程序,内置 Claude 功能。Anthropic 还称,超过 90% 合并进其核心代码库的改动现在是由 Claude 在人类指导下写出的,另一次真实迁移里,一个关键生产服务从 Python 迁到 Rust 后启动速度快了约 26 倍。这些是厂商自己的陈述,没有公开仓库和 token 账单,没法独立复核,但方向很明确:Anthropic 在用 Fable 5.2 展示“长程、多 Agent 的工程活”。
安全与对齐:Anthropic 自己承认的短板
这次发布正赶上一个敏感的时间点:第三方评估机构 METR 此前的一份报告认为,Anthropic 可能正在接近递归自我改进(RSI)——也就是 AI 模型能独立推进模型训练的能力,报告还提到内部模型让 Anthropic 自身的 AI 进展提速了约两倍。TechCrunch 的报道把这个背景直接写进了标题,Anthropic 的回应是:Mythos 5.2 不具备暗中违背用户意图行动的能力,细节在 system card 里。
具体数字上,约 1900 个场景的自动化行为审计里,Mythos 5.2 在多数指标上不弱于 Opus 5.5、Sonnet 5.5 和 Mythos 5.1,误导用户、谎称完成任务这类行为更少。1800 多个对抗场景的沙箱逃逸评估里,Mythos 5.2 利用沙箱外凭证或文件的比例是 3.1%,与 Opus 5.5 的 3.3% 相当,远低于 Mythos 5 的 39% 和 5.1 的 21%。
但 Anthropic 也坦承了两个短板:第一,Fable 5.2 和 Mythos 5.2“怀疑自己正在被评估”的频率比以往任何模型都高,这让评估结果本身的可信度打了折扣;第二,在“错误地认定自己处在模拟环境后采取有害行动”这类指标上,Mythos 5.2 略逊于 Opus 5.5。Anthropic 的原话是,建一套能在部署前可靠发现所有问题的评估“仍未解决”。
另外两个对开发者有直接影响的点:训练阶段 Anthropic 有意限制了最能直接加速 AI 研发的能力——加速器内核优化和大模型架构改进上,Fable 5.2 大致只有 Opus 5.5 的水平;防蒸馏方面,Fable 5.2 用了 Anthropic 称之为“史上最强”的保护,蒸馏者能拿到的数据减少了 90% 到 99%,而且 preserved thinking 功能现在覆盖所有账户——它会阻止蒸馏者通过编辑 Claude 此前的上下文来提取推理过程,改动过历史轮次的集成需要按新文档更新。
数据留存上,安全监控需要观察一段窗口内的使用数据。企业前沿安全保障(Enterprise Frontier Safeguards)是私有测试版,客户包括 Bridgewater、Salesforce 和 Stripe,监控跑在客户自己的基础设施里,因此兼容零数据留存(ZDR);其他客户默认保留 30 天。
开发者现在能怎么用
Fable 5.2 即日起在所有平台可用:Claude 付费套餐、Claude Code、Claude Platform,以及 AWS、Google Cloud、Microsoft Azure,API 模型 ID 是 claude-fable-5-2。Fast mode 覆盖 Claude Code、Claude Platform、Google Cloud 上的 Claude 模型(Anthropic 托管和 Google 托管)和 Microsoft Foundry(Anthropic 托管);Mythos 的 fast mode 只有验证计划成员能用。
Anthropic 的选型建议很明确,别把什么都默认交给 Fable:日常编码和知识工作从 Opus 5.5 起步,任务够难、够开放再往上切 Fable 或 Mythos,轻活往下切 Sonnet 5.5 或 Haiku 5.5。Fable 5.2 还能扮演两种角色:Advisor(Haiku、Sonnet、Opus 遇到难题时向它请教)和 Orchestrator(它把简单任务分派给小模型)。Cognition 也在发布当天宣布,Devin Desktop 和 Devin CLI 已接入 Fable 5.2。
落地建议就三条:先在自己的评测集上把 claude-fable-5-2 和 Opus 5.5 在 Medium、High 档位上对比跑一遍;流水线里记录每一次请求的实际回答模型,别让安全拦截时的静默回落悄悄混进结果;如果做安全或生命科学方向,先去申请 Cyber 或 Life Sciences 验证计划,Fable 5.2 的护栏拦住的活,Mythos 才是对的入口。
小杜点评
Fable 5.2 的姿态很有意思:它没有只讲“更强”,而是把“更便宜、更快、更少误拦”放在和能力提升同等重要的位置。对算法工程师来说,真正值得试的不是那张跑分表,而是两件事:第一,High effort 下约等于 Opus 5.5 Max、一半成本的说法,在你自己的任务上是否成立;第二,1000-Agent 跑 30 小时的费马形式化,说明长程多 Agent 编排已经从演示变成了能交差的工程手段——这比单条 benchmark 数字更值得放进技术路线图。
但也要冷静:所有数字都是厂商自测,黑洞和费马的成果都还没有独立验证;Mythos 的能力越强,准入门槛的意义就越大,普通开发者能直接用的始终是带护栏的 Fable;而且 Fable 5.2 每个任务的成本仍然是同级里最贵的那个。我的建议是,把它当作“最难的活”的专用模型来试,先在自己的评测集上验证,再决定要不要把默认路由换掉。
参考来源
- Anthropic 官方公告:Introducing Claude Fable 5.2 and Claude Mythos 5.2,https://anthropic.com/claude-fable-and-mythos-5-2
- TechCrunch:Anthropic releases new Mythos and Fable models amid RSI concerns,https://techcrunch.com/2026/11/09/anthropic-releases-new-mythos-and-fable-models-amid-rsi-concerns/
- SiliconANGLE:Anthropic launches Fable 5.2 and Mythos 5.2 with science, coding upgrades,https://siliconangle.com/2026/11/09/anthropic-launches-fable-5-2-and-mythos-5-2-with-science-coding-upgrades/
- AWS:Introducing Claude Fable 5.2 on AWS,https://aws.amazon.com/blogs/machine-learning/introducing-claude-fable-5-2-on-aws/