博客
AI 资讯、算法拆解和上手教程。一共 390 篇,新写的在最上面。
- 2026/11/14AI资讯约 5 分钟读完
llama.cpp 终于 1.0 了:本地 AI 有了稳定的 API
llama.cpp 与 ggml 双双发布 1.0.0:版本号从此是兼容性承诺,公开 C API 再变就升大版本;1.0 本身还是一次清理,删了 35 个废弃函数,顺手带来 FP8 KV 缓存与 MoE 专家内存缓存。
- 2026/11/02AI资讯约 5 分钟读完
开源 AI 游戏测试员来了:Aura Autopilot 自动试玩 Unity/Godot/Unreal 找 bug,自测 7 题全过
美国时间 2026-10-30,Ramen 开源 Aura Autopilot(Apache-2.0),能自动试玩 Unity、Godot、Unreal 游戏找 bug,也能被 Claude Code / Codex 调用。厂商自测 7 个任务首次全过、平均 262 秒,Claude Code 为 5/7、437 秒。本文拆解它的工作原理、评测口径和上手方法。
- 2026/11/01AI资讯约 5 分钟读完
5 个 27B 小模型组队写代码:Memdoor 复现 GVS5H,LiveCodeBench Hard 前 10 题均分 9.8
2026-11-01,开源 Agent 工具 Memdoor 公开 team-solve 工作流:5 个 Qwen3.8-27B 分任规划、构思、求解、经理与修复,在 LiveCodeBench Hard 前 10 题 5 轮均分 9.8,与 GVS5H 原版 9.6 持平、高于 Fable 5 单次调用的 8.0。本文拆解分工、成本、失败案例和上手步骤。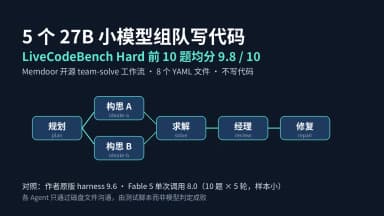
- 2026/11/01AI资讯约 5 分钟读完
在 Qwen3.5-4B 的权重里跑另一个模型:QwenPU 把向量单元"编译"进 LLM,逐 token 精确
开发者 Divyansh Agrawal 于 2026-10-31 发布 QwenPU:把 RISC-V CPU 和 64 通道向量单元编译进 Qwen3.5-4B 权重(零训练),让 Karpathy 的 stories260K 在前向传播里写故事,318 万步全部精确;每故事 token 约 16 秒、权重 26.7 GB。本文拆解原理、关键数字和上手方式。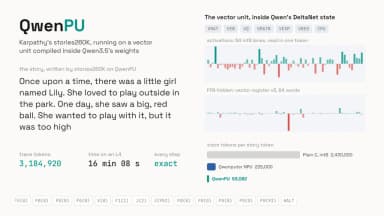
- 2026/11/01AI资讯约 4 分钟读完
微软开源 Mage-VL-Cowork:4B 混合 GUI/终端 Agent,OSWorld 厂商分 66%
微软 Mage 团队约 2026-10-30 开源 Mage-VL-Cowork(Apache-2.0):约 4B 参数,GUI 截图与 bash/Python 同一策略;厂商报告 OSWorld-Verified 50-step 平均 66.0%,五阶段训练后 Online Hybrid RL 相对 Hybrid SFT +10.16 pp。本文梳理架构、分数口径、安全边界与上手建议。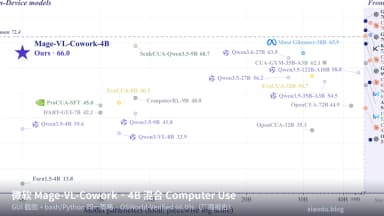
- 2026/11/01AI资讯约 5 分钟读完
36 种 Transformer 变体同算力公平比:NextTransformer 开源,混合架构和残差改造跑赢 Dense 基线
NextTransformer(MIT)10 月 31 日开源:36 种注意力、稀疏、线性、循环、残差和混合结构,用同一数据、同样 49.152B tokens、对齐到 ±1% 的训练算力对比,公开 31 组结果。mHC、AttnRes 和 GDN 混合架构在 CORE 与 BPB 上都优于 Dense 基线。本文解读协议、榜单与上手门槛。
- 2026/11/01AI资讯约 6 分钟读完
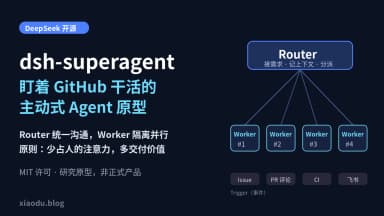
DeepSeek 开源 dsh-superagent:一个只在需要时才说话的 GitHub 编程 Agent,附架构拆解与上手门槛
DeepSeek Harness 团队 10 月 31 日发布 Super-agent 设计长文并开源 dsh-superagent-prototype(MIT):常驻 Router 统一沟通、隔离 Worker 并行干活,只响应白名单请求,主动工作默认只记录不执行。本文拆解架构、注意力优先的设计原则、官方自测数据和上手门槛。