同样的训练预算,到底该把算力花在哪种 Transformer 结构上?这个问题大家都想知道,但各家论文的数据、tokenizer、训练步数和评测都不一样,结果几乎没法横向比。GitHub 组织 Interactive-Active-AI 刚开源的 NextTransformer(MIT 许可)想把这件事做成一个"公平擂台":36 种注意力、稀疏、线性、循环(looped)、残差和混合结构,用同一套数据、同一个 tokenizer、同样 49.152B tokens、对齐到 ±1% 的训练算力来训,并公开了 31 组已跑完的结果。项目 README 标注开源日期为 2026 年 10 月 31 日,仓库首个公开提交在北京时间 11 月 1 日 00:18;11 月 1 日 13:14(北京时间),X 用户 Yue Su(简介为港大 MMLab 在读博士)发帖宣布开源。
对做模型结构研究、或者在选型时纠结"要不要上线性注意力 / 混合架构"的工程师来说,这是一份难得的同口径对照表。
它到底在比什么
NextTransformer 自己的定位是三件事:一个框架、一个基准、一个自动化架构研究平台。核心问题写在 README 第一句:训练预算固定时,语言模型应该怎样花它的计算量?
按官方公布的协议,所有模型遵守同一套规则:
- 数据:固定版本的 ClimbMix,同一个 32,768 词表的 tokenizer,2,048 上下文,全局样本顺序一致
- 预算:49.152B 输入 token,共 46,875 次更新,每次 1,048,576 token,seed 42
- 算力:每个输入 token 4.672 GFLOPs(含前向、反向、辅助计算和优化器开销),准入时误差 ±1%,整个训练过程审计误差 ±2%
- 评测:189 个点的验证 BPB、6 个检查点上的完整 CORE-22,外加一次独立的最终 BPB
- 基线:每层都是完整因果注意力的 Dense 模型,同预算训练
有个细节值得注意:参数量、显存和速度是"结果"而不是"控制变量"。也就是说,比的是同样算力下谁学得更好,而不是同样参数量下谁更强。这和很多论文"同参数量对比"的口径不一样,看结果时要记住这一点。
排行榜里能看到什么
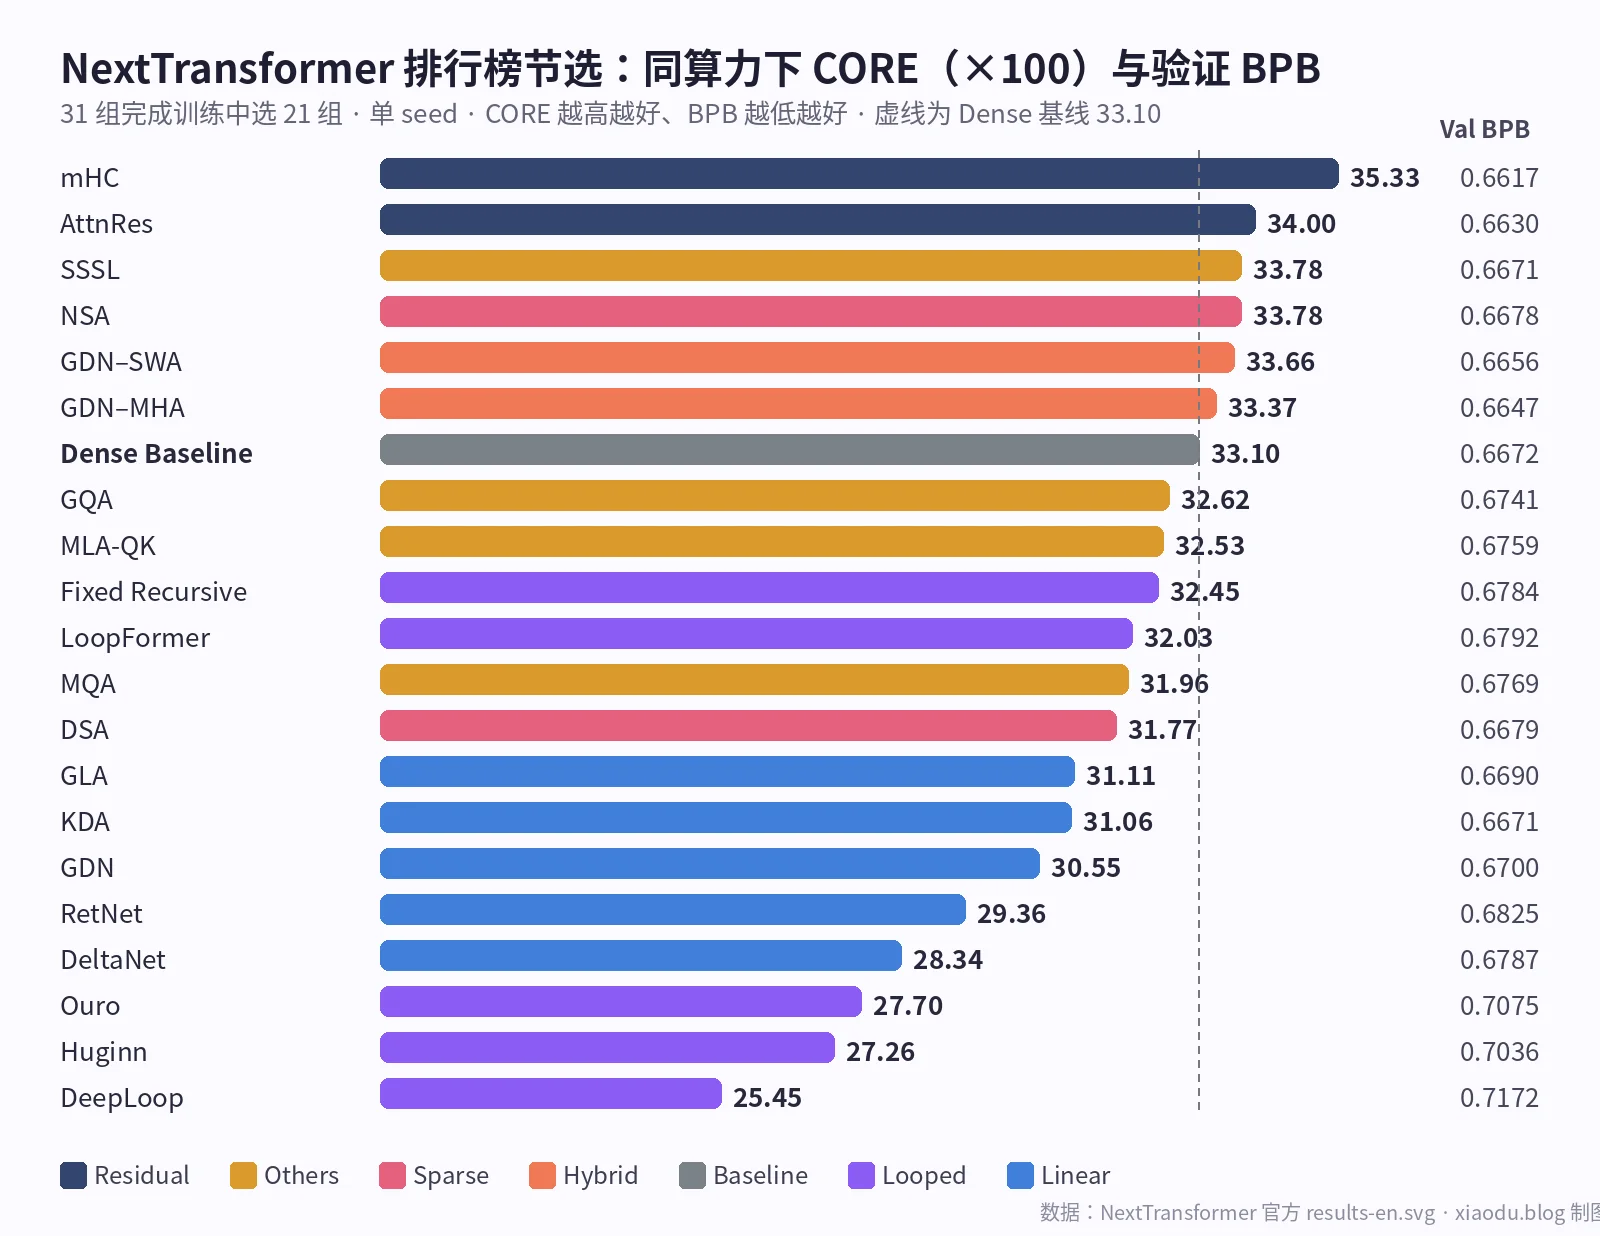
官方给出的是第 46,875 次更新(训练结束)时的 CORE 分数(×100,越高越好)和验证 BPB(越低越好)。Dense 基线是 CORE 33.10、BPB 0.6672。几个看点:
- 残差流改造排在最前:mHC 以 35.33(比基线 +2.23)排第一,AttnRes 34.00(+0.90)第二,两者 BPB 也都低于基线(0.6617、0.6630)。
- 混合架构稳稳过线:GDN–SWA 33.66、GDN–MHA 33.37,BPB 分别为 0.6656、0.6647,CORE 和 BPB 两项都优于 Dense。纯 GDN 则只有 30.55,说明"线性注意力 + 少量标准/滑窗注意力"的组合比纯线性更划算。
- 稀疏注意力分化明显:NSA 33.78 略超基线,但 MoBA 31.04、DSA 31.77、QSA 29.82 都在基线以下。
- 循环结构在这个预算下吃亏:LoopFormer 32.03、Ouro 27.70、Huginn 27.26、DeepLoop 25.45。原因不难理解:协议对齐的是每 token 的训练 FLOPs,循环结构把算力花在重复计算上,同样预算下能"看"的有效容量就少了。这不代表循环结构没价值,而是说在这个口径下它不占便宜。
- GQA、MQA、MLA-QK 都略低于全注意力(32.62、31.96、32.53)。它们本来就是为推理效率设计的,训练质量小幅让步符合预期。
官方也写得很清楚:这是单 seed 结果。几个排名相邻、差距在 0.3 分以内的模型(比如 SSSL 和 NSA 都是 33.78),换个 seed 顺序可能会变,别把小数点后的差距当定论。
对开发者意味着什么
第一,给结构选型提供了同口径参考。 以前想比 GDN、KDA、NSA、MoBA,得自己读一堆论文再对齐实验设置,现在至少有一份数据、预算、评测都一致的对照,可以直接打开 Observatory 页面 看每个模型完整的学习曲线和 22 个 CORE 子任务分数。
第二,复现门槛在"小团队可承受"的范围里。 官方说法是:约 1.4B 参数的模型、49B token 预训练,在单台 8 卡节点上 2~4 天跑完,同一套配方可以扩到多节点(支持 accelerate 和 Slurm)。数据要准备约 600 GB 的 ClimbMix。
第三,加自己的结构不用改主干代码。 写一个 nexttransformer/methods/<name>/ 插件目录(method.json 加几个 hook),用 python -m nexttransformer.protocol.calibrate 校准到共享预算,提 PR 准入后再正式训练提交结果。
第四,Agent 也能参赛。 项目设计了一个 Arena:把架构研究任务交给任意 LLM,它提出的结构按同一协议训练、上同一张榜,并公开"是怎么找到的"。官方计划在 2026 年 11 月 14 日前推出 Arena v2(带 MCP 工具、计量算力和研究轨迹),11 月内放出 400B token 和更大模型的训练配方,之后还计划把检查点和 tokenizer 传到 Hugging Face。这些都是路线图,还没上线。
实操建议
- 先看榜再动手:想换结构的,先在 Observatory 里看目标结构的学习曲线形状,而不是只看最终分。有的结构前期领先、后期被追上。
- 环境要求:Linux + NVIDIA GPU,Python 3.10~3.13,PyTorch 2.9.1,用 uv 装依赖;线性注意力相关内核单独装(
requirements/linear.txt)。 - 小步验证:官方 quick start 里有 smoke test,先用它确认环境和数据管线,再上完整的 49B 训练,避免白烧几天算力。
- 注意口径:如果你的业务更关心推理成本(KV cache、长上下文吞吐),这份榜单只回答了一半问题,推理侧还要自己测。
小杜点评
这个项目最有价值的不是谁拿了第一,而是把"公平对比"这件事工程化了:固定数据顺序、把算力审计到 ±1%、每个结果都有可回放的文件记录。做过结构实验的人都知道,很多论文里的提升放到统一设置下就消失了,这类基准能帮大家省掉不少"复现不出来"的冤枉功夫。
几个保留意见:一是规模只有约 1.4B / 49B token,结构在小规模上的排序到更大规模时未必成立,官方也在准备 400B 配方;二是单 seed,相邻名次的差距不够有说服力;三是项目刚开源,GitHub 星标还很少,社区能不能持续提交新结构和结果,决定了它能不能真正成为"擂台"。如果你手上有 8 卡资源又在做结构改进,把方法接进来跑一遍,比在论文里自说自话更有说服力。