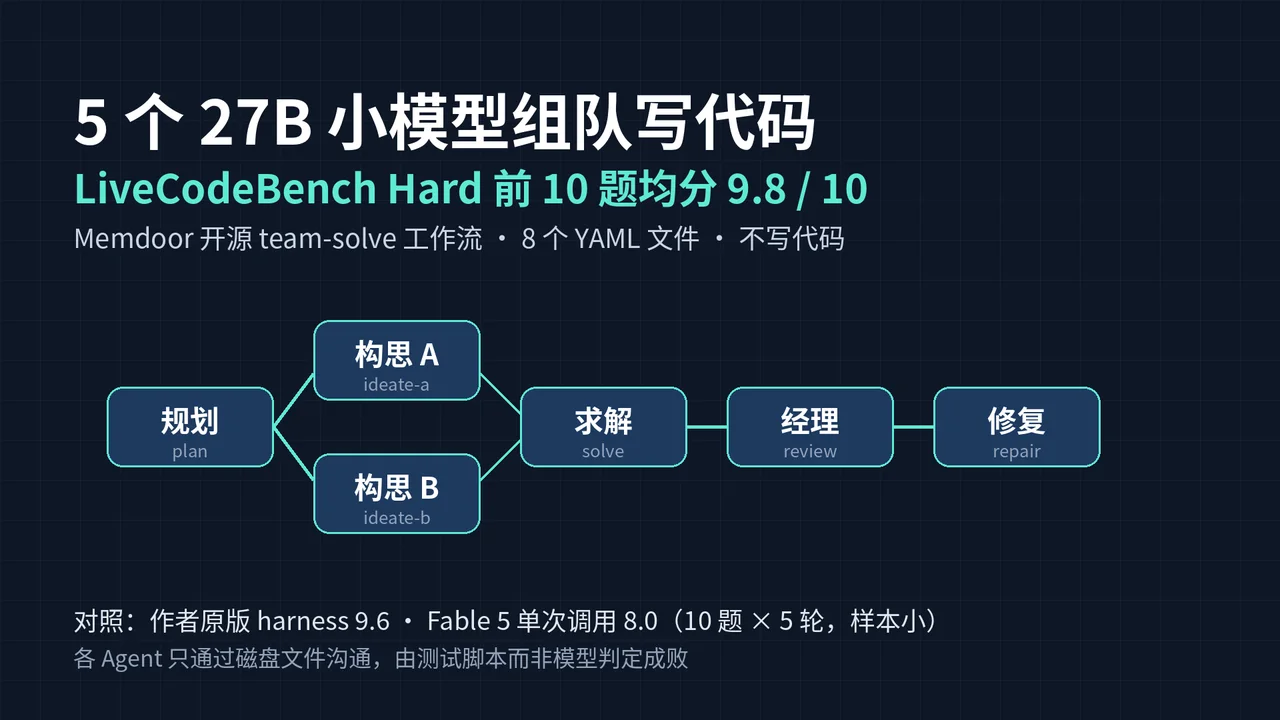
东京时间 11 月 1 日 07:46(北京时间 06:46),开源 Agent 工具 Memdoor 的作者在 Hacker News 发帖,标题是「Memdoor:5 个 Qwen3.8-27B 组队,在 LiveCodeBench Hard 上胜过 Fable 5」,帖子当天冲到 250 多分、100 多条评论。内容本身不是新模型,而是一个叫 team-solve 的工作流:把论文 GVS5H 里的多智能体解题方法,写成 8 个 YAML 文件,让 5 个 27B 开源模型分别当规划者、构思者、求解者和经理,在 LiveCodeBench Hard 前 10 题上跑 5 轮,平均解出 9.8 / 10。它值得聊,不是因为「小模型打赢了前沿模型」这个标题,而是因为作者把 50 次运行的每一次请求、回复、程序和花费都公开了,同时老老实实写清了这个结果不能说明什么。
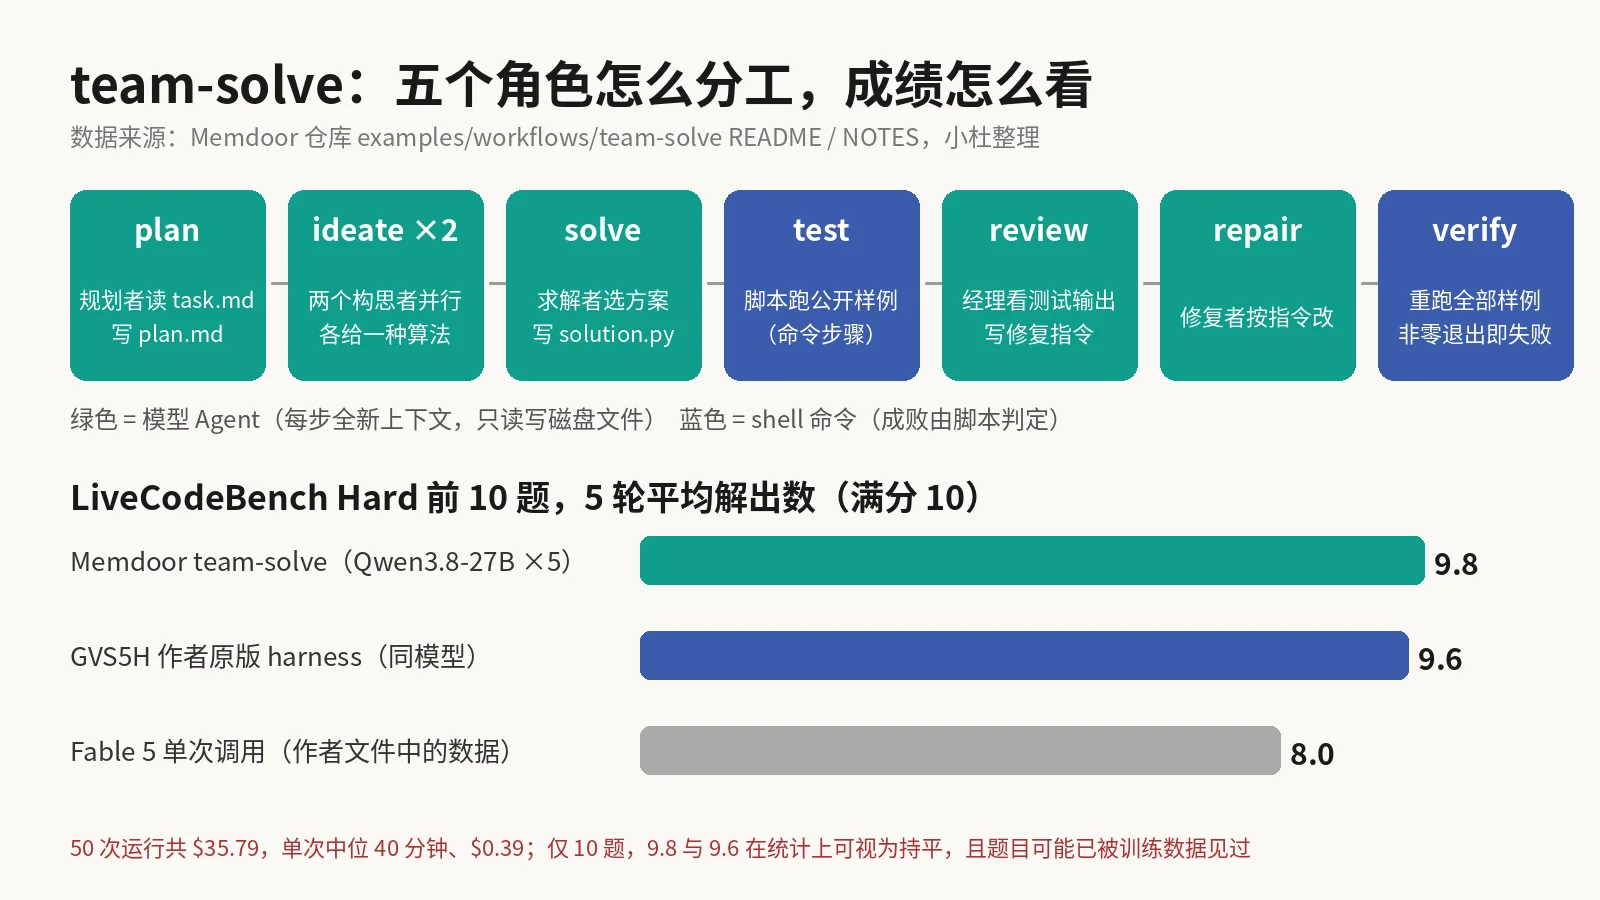
先看清楚成绩:谁和谁比
team-solve 的 README 给了一张逐轮表格,口径是:GVS5H 作者列表里 LiveCodeBench Hard 的前 10 道题,每题跑 5 轮,用作者修正过的评测脚本在全部隐藏测试上打分。
| 轮次 | Memdoor team-solve | GVS5H 作者原版 harness | Fable 5 单次调用 |
|---|---|---|---|
| 1 | 10 | 9 | 7 |
| 2 | 10 | 10 | 8 |
| 3 | 10 | 10 | 10 |
| 4 | 10 | 9 | 8 |
| 5 | 9 | 10 | 7 |
| 平均 | 9.8 | 9.6 | 8.0 |
这里有三点要看仔细:
- 主角其实是「复现」。Memdoor 用同一个 Qwen3.8-27B、作者的原版提示词、同样的循环和 128K 回复上限,重建了 GVS5H 的 harness。作者自己写明:样本只有 10 题,9.8 和 9.6「是同一个数」,结论是与原作持平,不是超越。
- Fable 5 那一列不是在这个框架里跑的,而是 GVS5H 作者文件里「每题一次调用」的结果。所以「5 个小模型打赢 Fable 5」更准确的说法是:一套多轮、多角色、有测试反馈的流程,打赢了一次性作答。
- 数据污染无法排除。这些题来自 2025 年春季的比赛,模型训练时可能见过,README 明确说这一点对每一列都成立。
五个角色怎么分工
流程是一个 DAG:
plan ──┬── ideate-a ──┬── solve ── test ── review ── repair ── verify
       └── ideate-b ──┘
- plan:规划者读题目
task.md,写出plan.md; - ideate-a / ideate-b:两个构思者并行,一个给「最直接、可证明」的算法,另一个必须给出来自不同技术路线的方案;
- solve:求解者在两份方案里选一个,写出
solution.py; - test:一段 shell 命令跑公开样例,把结果写进日志(这一步不会让流程失败);
- review → repair:经理读测试输出写修复指令,再由一个全新的修复者执行;
- verify:最后重跑所有样例,任何不一致就以非零退出码判失败。
关键设计有两条:每个 Agent 都从全新上下文开始,提示词里写着「读文件,不要依赖聊天记录」,彼此只通过磁盘上的文件沟通;成败由脚本判定,不由模型判定。按 README 的说法,GVS5H 论文把收益主要归功于这种「账本式」的纪律。整套流程没有一行代码、也不指定模型,换成你本地的模型同样能跑。
成本、耗时和翻车记录
NOTES 里的账算得很细:50 次运行解出 49 次,总花费 $35.79(1530 万输出 token);单次运行中位数 40 分钟、$0.39,最长的一次跑了 4 小时。模型是通过 OpenRouter 调用的,没有在本地跑。
丢掉的那一题也写得很坦白:第 5 轮的 abc399_e,第一轮写出的程序其实是对的,但经理「编」了一个预期答案错误的反例,团队就把正确程序改坏了,而公开样例恰好没覆盖到这个情况。另外还有两次,正确程序被后续轮次覆盖,最后才找回来,这两次也是 50 次里最贵的($3.44 和 $4.24)。作者给的修法很工程化:用小输入上的暴力解去核对经理给的反例,并且始终保留最后一个通过样例的版本。
想自己试试怎么做
README 给的步骤很短:
curl -fsSL https://memdoor.ai/install.sh | bash
memdoor connect openrouter        # 也可以 anthropic / openai / gemini
# 不想用 key:memdoor connect local(Ollama、llama.cpp、vLLM、LM Studio)
git clone --depth 1 https://github.com/guregodevo/memdoor
mkdir -p ~/.memdoor/workflows
cp -r memdoor/examples/workflows/team-solve ~/.memdoor/workflows/
mkdir my-problem && cd my-problem
cp -r ../memdoor/examples/workflows/team-solve/sample/* .
memdoor workflow run team-solve --wait   # 所有样例通过时退出码为 0
几个实操提醒:
- 换成自己的题目,只需替换
task.md,并在tests/下放成对的N.in/N.out;程序固定是从 stdin 读入的solution.py,需要 Python 3 和 bash。 - 用 Ollama 跑本地模型时,README 特别提醒要把上下文窗口调到 32K,默认的 4K 不够。
- 想改某个角色的行为,直接改
steps/里对应的提示词即可;Memdoor 本身是 Apache-2.0 许可的单文件 Go 程序。
小杜点评
这条新闻最有价值的地方不是 9.8 这个分数,而是「把 harness 当成可以复现、可以 diff 的工件」:作者写了一个测试,让自己的工作流和原论文代码面对同一个脚本化模型,逐字节比对每一次请求,一个字符不同就会报错。做算法的同学都知道,多 Agent 论文最难复现的往往不是模型,而是提示词、温度、截断和重试这些细节,这里把它们全摊开了。
我的看法有三点。第一,「小模型组队 > 大模型单发」本质上是用测试反馈和多轮推理换算力,中位 40 分钟、平均每题约 30 万输出 token(1530 万 ÷ 50 次)的流程和一次调用不在同一个预算档,选型时要按「每道题的总成本和延迟」比,而不是只看分数。第二,10 题 × 5 轮的样本只能说明方法可用,离「稳定超越」还差得远,别被标题带节奏。第三,「经理编出错误反例把对的程序改坏」这种失败模式在真实的代码 Agent 里非常常见,作者给的「暴力解校验 + 保留最后一个通过版本」值得直接抄进你自己的 Agent 流程里。