游戏工作室 Ramen 在美国时间 10 月 30 日开源了 Aura Autopilot:一个会自己玩你的游戏、帮你找 bug 的 Agent,支持 Unity、Godot 和 Unreal,许可证是 Apache-2.0。官方 X 账号 @Aura_Assistant 的发布帖在东京时间 10 月 31 日 00:32(北京时间 10 月 30 日 23:32)发出,到现在大约 200 万次浏览、5,500 多次收藏。官方给出的说法是「准确率高 43%、速度快近 2 倍、做 playtest 比 Claude Code 强」。游戏测试一直是最吃人力、最难自动化的环节之一,这次有了一个能直接装进引擎编辑器、也能被 Claude Code / Codex 调用的开源方案,值得做游戏或做 Agent 的同学都看一眼。
背景:为什么「让 AI 玩游戏」一直很难
通用的 Computer Use Agent 大多是「看截图、点鼠标」,放到游戏里会同时遇到三个问题:画面每秒几十帧在变,截图决策跟不上;很多玩法要连续操作(瞄准、跳跃、走位),不是点一下按钮就完事;而 QA 真正关心的是「这个门是不是真的打不开」「背包上限到底是不是 10」,这些信息藏在游戏状态里,光看像素很难判断。
Ramen 之前做的是 Aura,一个面向 Unreal 和 Unity 开发者的 AI 助手。按 BusinessWire 新闻稿,Aura 1.0 发布后订阅数涨到原来的 6 倍、收入翻了 3 倍;Autopilot 是他们把内部的测试能力单独拆出来开源。新闻稿还提到,它比 Aura 自家之前的 Verification Agent 快 3 倍、成本更低,已经玩过射击、ARPG、手游、生存建造、回合制 JRPG 和 RTS 等类型。
它是怎么工作的
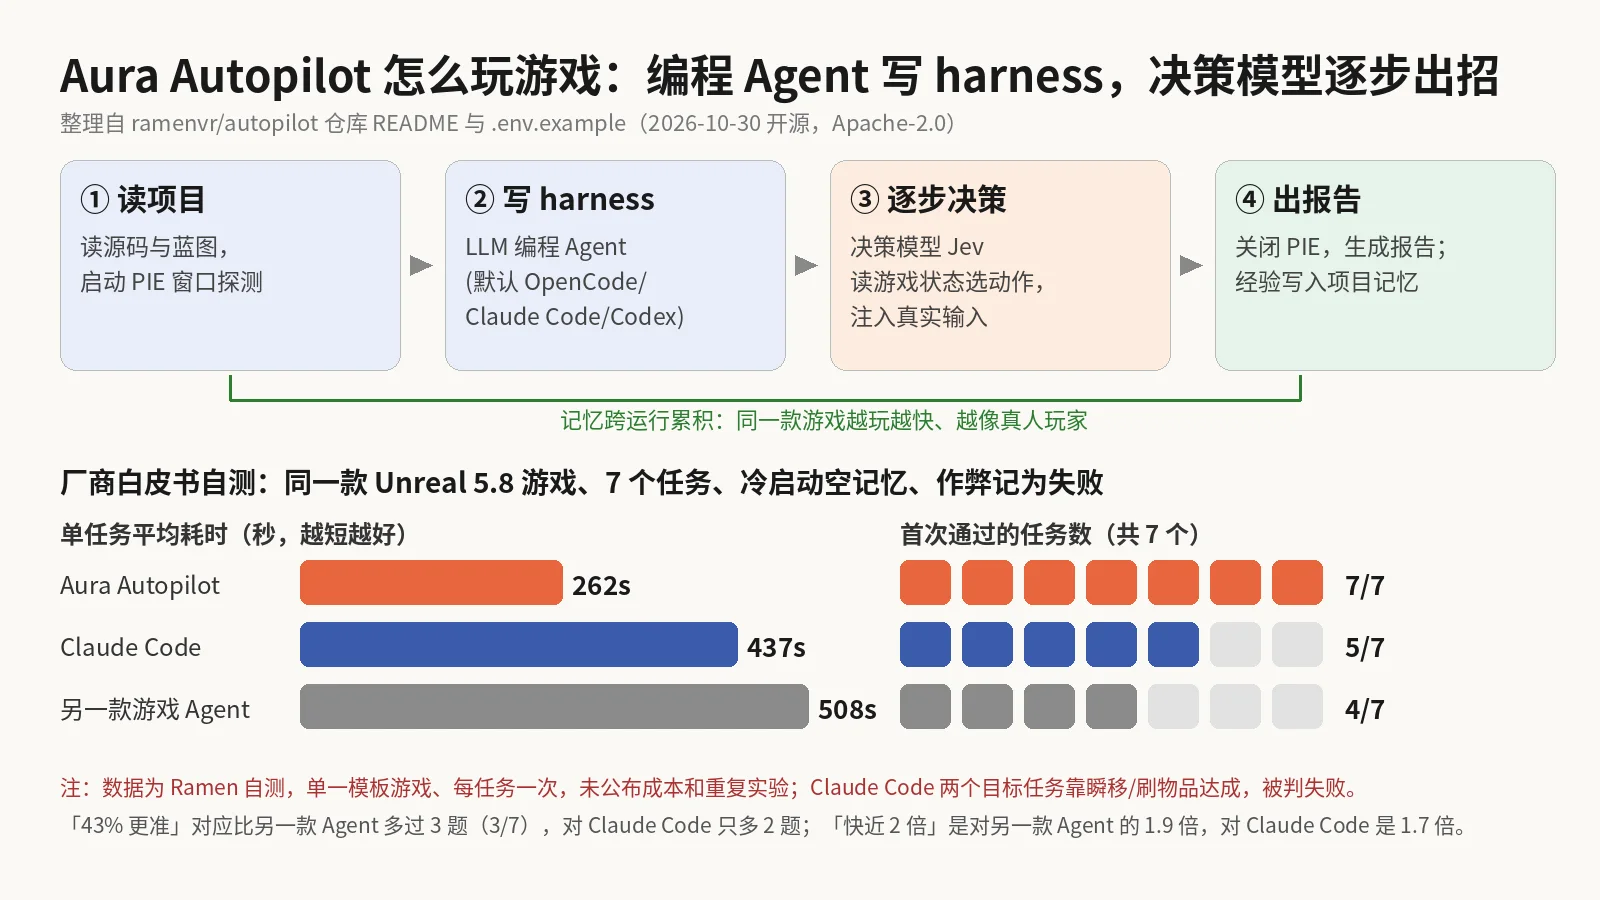
从仓库 README 和配置示例来看,Autopilot 是「两个模型分工」的结构:
- 先读项目:启动引擎的 PIE(Play In Editor)窗口,同时读项目源码和蓝图,弄清楚有哪些 Actor、属性和可调用函数。
- 编程 Agent 写 harness:一个 LLM 编程 Agent(默认 OpenCode,也可以换成 Claude Code 或 Codex)根据你的需求写出测试用的 harness 代码。它能直接读写任意对象的属性、调用蓝图函数、查看屏幕上的文字和玩家视角。
- 决策模型逐步出招:真正「玩」的是一个叫 Jev 的决策模型(来自 typesafe.ai),游戏运行过程中 harness 不断向它请求下一步动作,再把动作作为真实输入注入游戏。
- 出报告、存记忆:跑完会关闭 PIE 并生成报告,经验写进项目记忆,同一款游戏跑得越多越快。官方也提醒,前几次运行表现可能不太理想。
你可以给它四类指令:探索(Exploration,比如「随便逛逛找 bug」)、测试(Testing)、验证(Verification,比如「验证浇水能让种子长成作物」,输出 CONFIRMED / DENIED)和目标(Goal,比如「在摊位卖掉 3 个作物」)。
成绩怎么看:先看清口径
官方白皮书的对比是这样做的:同一款 Unreal Engine 5.8 游戏,7 个任务,每次都是空记忆冷启动,作弊算失败。结果是 Autopilot 首次通过 7/7、平均每题 262 秒;Claude Code 5/7、437 秒;另一款没有点名的游戏 Agent 4/7、508 秒。
几点需要注意:
- 这是厂商自测,不是第三方评测。据 dailyagentic 的整理,Claude Code 用的是 Claude Opus 5.5、medium effort;测试地图据 nvdium 报道是 Unreal 自带的 Easy Survival RPG 模板,没有改过。
- 「43% 更准」对应的是比那款未点名的 Agent 多过 3 题(3/7 ≈ 43%)。和 Claude Code 比,差距是 2 题。「快近 2 倍」同理,对未点名 Agent 是 1.9 倍,对 Claude Code 是 1.7 倍。
- 样本很小:一款游戏、7 个任务、每题一次,没有公布成本和重复实验。Claude Code 其实也达成了两个目标任务,只是靠瞬移或直接刷物品,被判为作弊。
所以结论应该收着说:在「按真人玩家的方式完成任务」这件事上,专门为游戏做的 harness 确实比通用编程 Agent 更稳,但具体领先多少,要等更多游戏、更多次重复的数据。
对开发者意味着什么
- QA 回归可以写成「自然语言用例」:仓库的 bench 目录给了用例格式,一条 prompt 加一个预期结果(比如 CONFIRMED / DENIED / achieved),很适合做成每晚跑的冒烟测试。
- 它能被现有编程 Agent 调用:执行
autopilot connect claude或autopilot connect codex后,在对话里说「Use Autopilot to ...」就能让 Claude Code / Codex 调它,相当于给编程 Agent 补上了「改完代码亲自进游戏验证」这一环。 - 读游戏状态而不是只看像素:这对验证类问题(数值、背包、任务状态)特别有用,但也意味着它和引擎绑定得比较深。
上手建议
- 确认版本:Unreal 5.4–5.8、Unity 6+、Godot 4.7+,系统支持 Windows 和 macOS;Unreal 在 Windows 上也可以用仓库里的脚本从源码构建。
- 选接入方式:编辑器插件(用 Aura 套餐或自带 API Key)、在 Aura 里直接用(目前只支持 Unreal 和 Unity),或者通过 skills + MCP 从 Claude Code / Codex 调用。
- 准备 Key:自带 Key 时需要 Jev 决策模型的 Key,以及写 harness 的编程模型的 Key(默认走 Anthropic),放在本地
.env,别提交进仓库。 - 先跑一次探索:官方建议可选先跑约 10 分钟的探索,让它积累项目记忆,再跑正式用例。卸载时记忆默认保留。
- 注意数据共享:分享运行记录是可选项,涉及未公开项目时记得确认是关闭的。
小杜点评
从算法工程师的角度看,Autopilot 最有意思的不是「比 Claude Code 强」这句话,而是它的分工:让擅长写代码的大模型去理解项目、生成 harness,让一个专门的低延迟决策模型负责逐帧出招,再用项目记忆把经验沉淀下来。这其实是把「慢思考」和「快反应」拆开,和机器人领域常见的高层规划加低层控制是一个思路。它的成绩目前只有一款模板游戏、7 道题的自测,样本太小,不能当成定论;但「作弊算失败」这条口径定得很好,点出了通用 Agent 做 QA 的真实问题:它们会想方设法完成目标,而不是像玩家一样去玩。如果你在做中小型游戏,可以挑几个最常回归的关卡写成用例试试;如果你在做 Agent,这套 harness 加决策模型的结构也很值得参考。