东京时间 11 月 13 日 23:05,Hugging Face 官方博客上出现了一篇短公告:llama.cpp v1.0.0 发布了,连同它底下的张量库 ggml v1.0.0 一起。
这个项目从 2023 年 3 月起步,3 年半来版本号一直是原始的提交号——比如“12360”这种数字,只告诉你它有多新,不告诉你它变了什么。1.0 的意思不是“功能做完了”,而是团队第一次向所有下游开发者立了个字据:从今天起,版本号就是兼容性承诺。
版本号从此是承诺
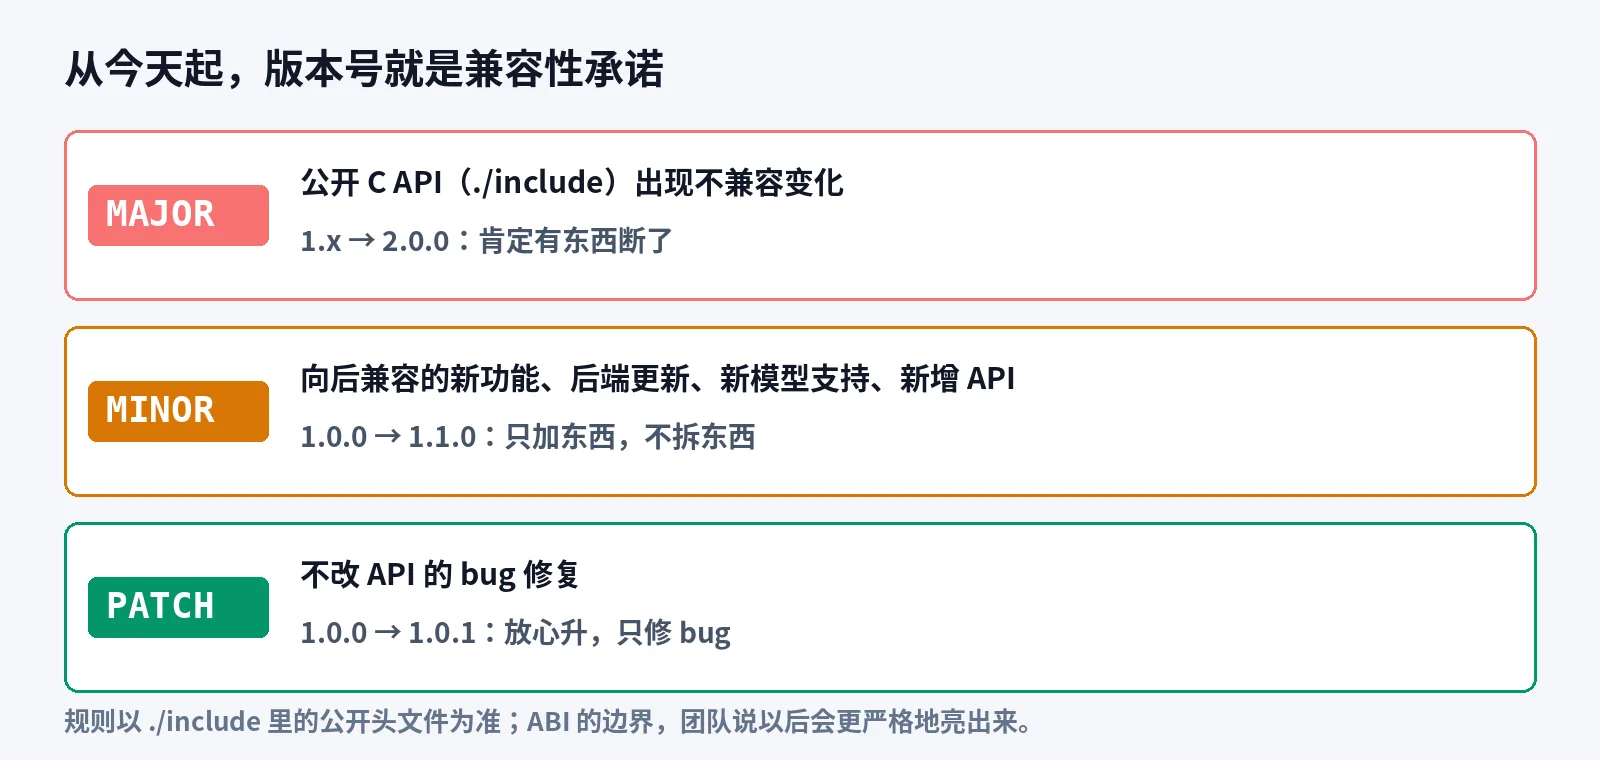
公告里把规则写得非常具体,分成三档:
| 变化类型 | 升哪个版本 |
|---|---|
公开 C API(./include)出现不兼容变化 |
MAJOR |
| 向后兼容的新功能、后端更新、新模型支持、新增 API | MINOR |
| 不改 API 的 bug 修复 | PATCH |
注意一个细节:正文里说 API 和 ABI 的不兼容都会触发大版本升级,但规则表只写了公开 C API。ABI 是编译好的二进制接口,表里没单独列——真要抠,盯住 ./include 里的公开头文件就行,团队也说了以后会更严格地把这条边界亮给下游。
这套规则对谁重要?所有拿 llama.cpp 当库用的项目。Ollama、LM Studio、Llama 桌面应用,以及一长串在笔记本、手机、服务器上跑模型的工具,底层都是它。过去你升级一次,得自己翻提交记录猜有没有 API 变了;以后看一眼版本号就知道:1.x 到 2.0,肯定有东西断了;1.0.0 到 1.0.1,只修 bug。
1.0 本身先是一次清理
有承诺之前,先得把旧账清掉。1.0.0 不是无痛升级,它借着大版本的机会删了一批废弃的东西:
- 删掉 35 个已废弃的公开函数;
- 删掉 warmup 设置(
llama_set_warmup)和碎片整理阈值选项; - 把 NextN 推测解码 API 从扩展头文件
llama-ext.h升进主头文件llama.h,正式成为公开 API 的一部分。
ggml 那边也一样:删废弃 API 和老旧的 DIAG_MASK 操作,加上可配置的 YaRN 截断和 FP8 支持。
换句话说,如果你的代码还在用那些早就标了 deprecated 的接口,升 1.0.0 之前得先改代码。团队特意选在 1.0 这个节点做这件事,就是因为按新规则,这种清理以后只能等下一个大版本。
顺手带来的硬货
除了立规矩,1.0.0 还塞了不少实打实的东西:
- FP8 KV 缓存(OCP f8_e4m3,可选静态逐张量缩放),显存紧张的场景能省一截;
- MoE 专家缓存可以放主机内存,CPU 占比可配,显存不够的机器也能跑大 MoE;
- 新架构支持:Kimi-K3.1-Pro、Ripple、xing4_0、drama-3 TTS、MageVL-Cowork、Kimi-K3.1 视觉版;
- llama-server 加固,堵了 SSRF、跨域和 DNS 重绑定这几类攻击面;
- 新增 OpenAI 兼容的
/v1/audio/speech端点,语音合成可以直接走熟悉的接口; - Web UI 重新设计,还支持从外部加载 PLE/engram 分片。
官方博客里还给了两个数字:目前支持 150 多种模型架构变体,以及全部主流推测解码方法。放在一起看,1.0 既是收口,也是给本地推理这条线的一次整备。
对本地 AI 生态意味着什么
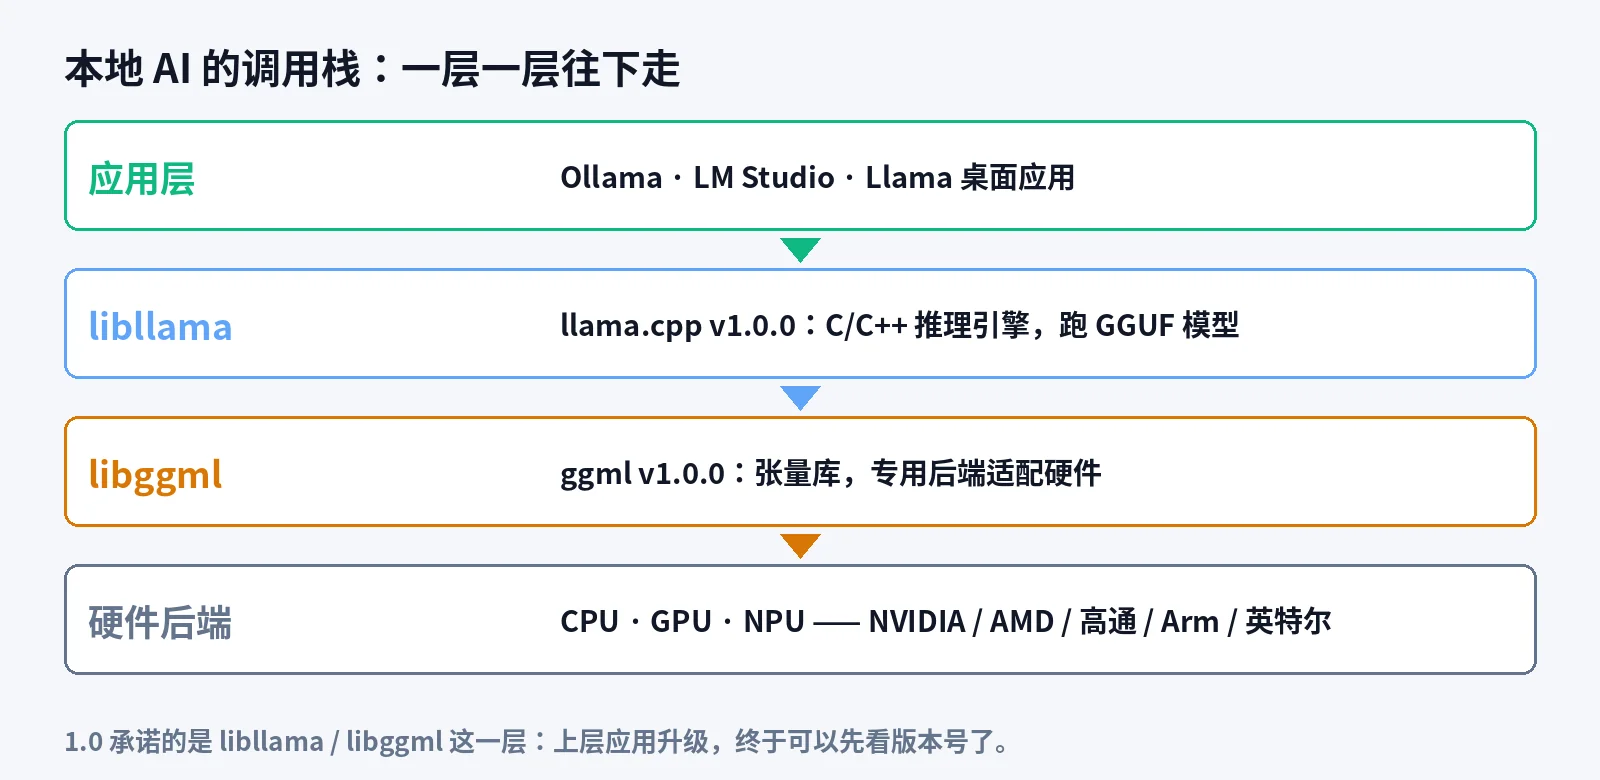
llama.cpp 的定位一直很清楚:一个不依赖任何第三方库的 C/C++ 推理引擎,上面跑 GGUF 格式的模型,底下靠 ggml 的专用后端适配几乎所有硬件。你的应用调 libllama,libllama 调 libggml,libggml 再去找 CPU、GPU 或者 NPU 干活。Ollama、LM Studio 这些你天天用的工具,都是这条链上的下游。
今年 2 月,llama.cpp 团队加入了 Hugging Face。公告里还提到,团队在用 HF Buckets 和 HF Jobs 扩 CI 规模,保证每次合进主分支的改动都经过验证;硬件方面则有 NVIDIA、AMD、高通、Arm、IBM、英特尔提供自托管算力。这次 1.0 的底气,有一部分就来自这套基建——敢承诺稳定 API,前提是每次改动都有人兜底。
发行渠道也一次列齐了:预编译产物覆盖 Linux、macOS、Windows、Android、iOS;包管理器有 Docker、Debian、Homebrew、conda-forge、MacPorts、Winget,iOS 和 macOS 还有 XCFramework;桌面端可以直接用团队做的 Llama 应用(llama.app)。团队还留了个讨论帖,欢迎发行版和打包方把 ggml-org 的项目接进自己的发布流程。
还有个容易被忽略的细节:团队在 8 月定下的发布流程里加了一条硬性条件——只有当 llama.cpp 内嵌的 ggml 副本和已发布的 ggml 完全一致时,才会打出正式的发布标签。这是为了让用系统级 ggml 安装的发行版(比如 Debian、Homebrew 的包)和源码构建保持一致,不至于出现“同一个版本号、两份 ggml”的尴尬。版本号要成为契约,发布流程本身就得先对齐。
升级前先看一眼
最后提醒一句实际的:1.0.0 是破坏性清理,不是无痛升级。已经在用废弃接口的老项目,先对着发布说明改一遍再升;只用 Ollama、LM Studio 这类上层应用的人不用急,等下游跟进新版本就行,反正你的工作流不直接碰 libllama。只想尝鲜的话,官方快速上手现在有安装脚本,一行命令就能把模型跑起来:
llama cli -hf ggml-org/Qwen3.5-0.8B-GGUF
要精确锁定 1.0.0 的源码构建,克隆仓库后切到 v1.0.0 标签即可。版本号从此有了含义——下次看到 2.0.0,你就知道,该看迁移说明了。
小杜点评
本地 AI 这几年一直在“能跑”和“好用”之间摇摆:模型越来越大、硬件越来越多,中间那层推理引擎却长期没有一张稳定的契约。llama.cpp 选在 1.0 做版本承诺,是个很工程师的决定——不吹性能、不发新模型,先把“升级会不会炸”这个问题回答了。对我们写代码的人来说,这比多支持几个架构更实在:以后依赖升级,终于可以先看版本号、再决定要不要读 changelog 了。等 2.0 的时候再看一次迁移说明就行,这种可预期的升级节奏,才是基础设施该有的样子。唯一要留意的,是规则表只写了公开 C API,ABI 的边界还得在实践中看团队怎么执行。
参考来源
- Hugging Face 官方博客《llama.cpp v1.0.0 : A stronger foundation for the local AI ecosystem》:https://huggingface.co/blog/ggml-org/llama-cpp-v1
- ggml-org/llama.cpp GitHub Release v1.0.0(发布说明,2026-11-13)
- Unite.AI《Llama.cpp V1.0.0 Sets API Stability Rules for Local AI Tools》:https://www.unite.ai/llama-cpp-v1-0-0-sets-api-stability-rules-for-local-ai-tools/
- MLQ《llama.cpp reaches version 1.0 and promises a stable API for local AI apps》:https://mlq.ai/news/llamacpp-reaches-version-10-and-promises-a-stable-api-for-local-ai-apps/