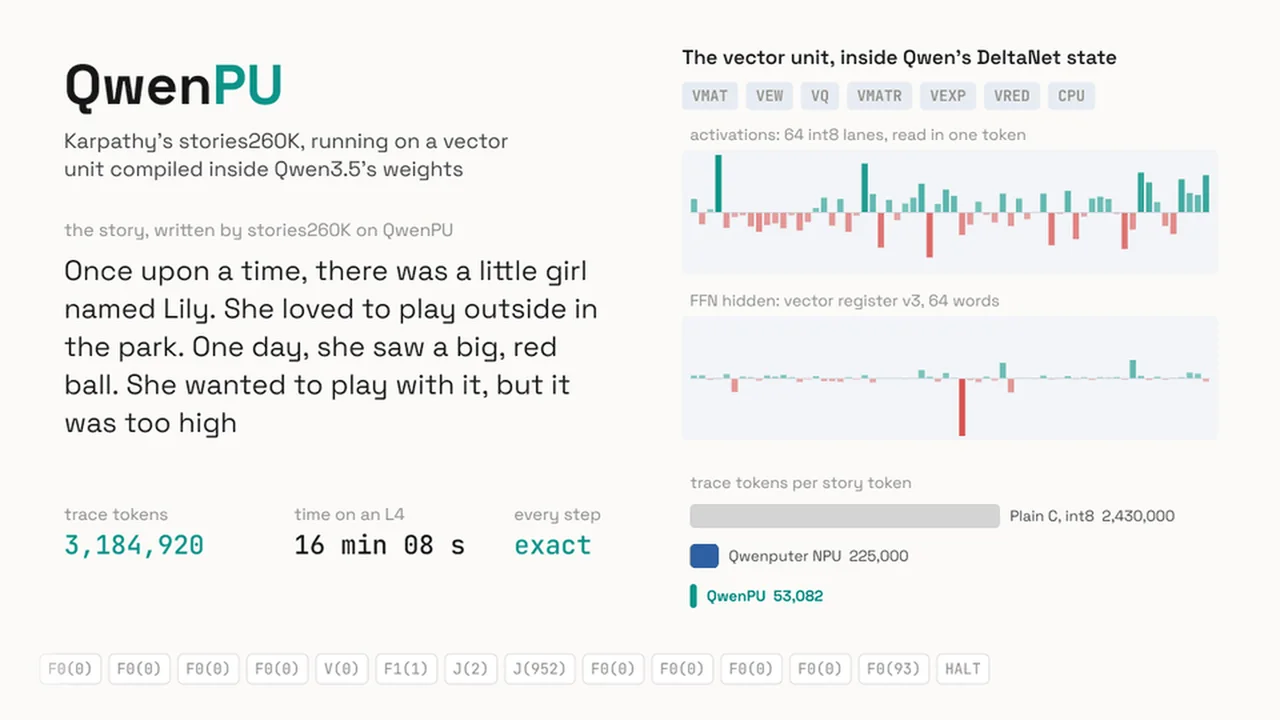
开发者 Divyansh Agrawal(X:@divagr1925)在北京时间 10 月 31 日 22:56(东京时间 23:56)发帖公开了 QwenPU:他把一个 32 位 RISC-V CPU 加一个"向量单元"(作者称 NPU)直接编译进 Qwen3.5-4B 的权重里,然后让 Karpathy 的 26 万参数小模型 stories260K 作为一段 C 程序,在 Qwen 的前向传播里一步步跑起来写故事——也就是"LLM 里跑 LLM"。权重 10 月 31 日已上传 Hugging Face(Apache-2.0)。它慢得离谱(每个故事 token 约 16 秒),但它把"权重本身能当计算机用"这件事又往前推了一步,对做推理、可解释性和工具调用的工程师都很值得一看。

背景:先有 Qwenputer,再有 QwenPU
QwenPU 是同一作者 Qwenputer 项目的续作。10 月 28 日他先发布了 Qwenputer:在 Qwen3.5-4B 原有 32 层前面加 11 层"编译出来"的层,组成一颗 RV32IM(+Zba、+大数单元)的 RISC-V CPU。按作者博客,这颗 CPU 通过官方 riscv-tests,连续自由运行 1800 万条指令无错误,可以在前向传播里跑 C 和 MicroPython。
关键技巧在内存:Qwen3.5 的 4 层里有 3 层用 Gated DeltaNet(一种线性 RNN 注意力)。作者发现把门控设为 1、写入强度设为 1、键用 one-hot,DeltaNet 状态每次写入恰好覆盖一行,用 one-hot 查询又能精确读回——于是它就成了一块大小恒定的"RAM"。所有新增权重都由编译器直接算出,没有训练,Qwen 原本的权重一个不动。
作者在 X 上报告的 DeepMind 数学题结果是:原版 55–90%,原版 + Python 工具 95–100%,Qwenputer 97.5–100%(作者自测)。
QwenPU 多了什么:一个 64 通道的向量单元
Qwenputer 的 CPU 跑神经网络太慢——纯 C 实现的 stories260K 每生成 1 个故事 token 要 243 万个 trace token(CPU 每执行一步就要解码几个 token)。QwenPU 的做法是给 CPU 配一个专用向量单元,指令包括:
VMAT:int8 × int4 矩阵行运算,一个 token 算 64 通道,也能做 argmaxVQ:把向量寄存器量化成 int8 激活或 KV cache 行VEW:残差加、SiLU 门控乘、RoPEVMATR:基于 K cache 算注意力分数、再乘 V cacheVEXP/VRED:查表 exp(softmax 分子)、求和与平方和
它的存储同样放在 DeltaNet 头里:16 个 64 字的向量寄存器、384 个 int8 激活、4,152 个 int4 权重行块,以及 32 个位置的 KV cache。stories260K 的 int4 权重由 C 程序装进这块"权重内存",并没有编译进 checkpoint,所以理论上任何放得下的小模型都能用同样方式跑。
关键数字(均来自模型卡,作者自测)
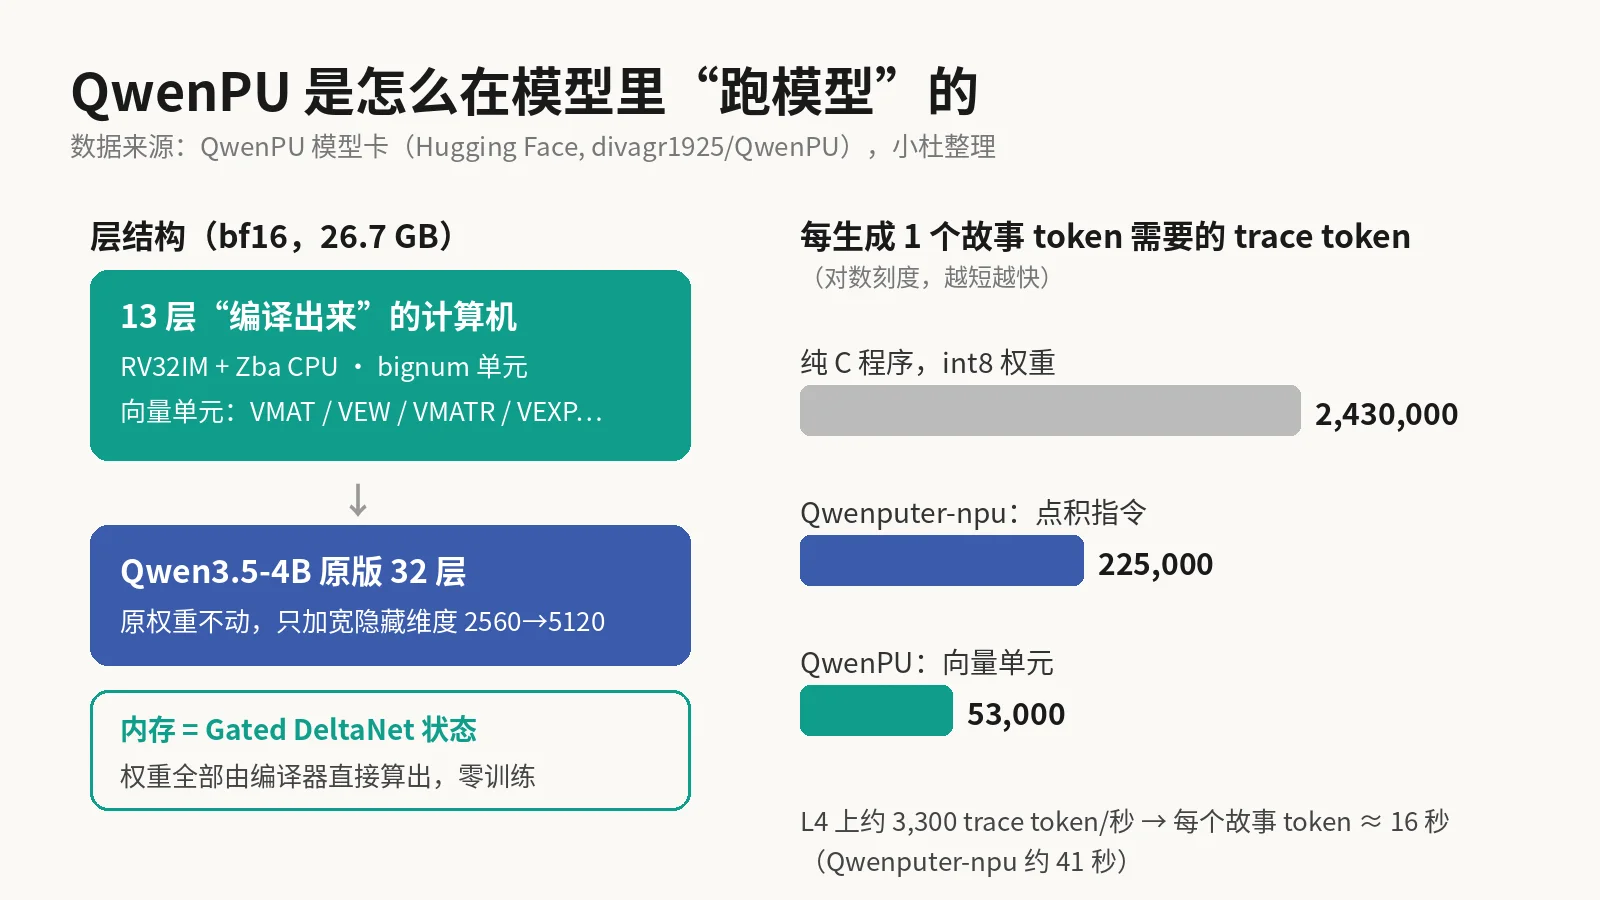
- 每个故事 token 的 trace token:纯 C 243 万 → Qwenputer-npu(点积指令)22.5 万 → QwenPU 5.3 万,约 46 倍提升
- 精确性:每条向量指令用随机程序对照参考模型做 teacher-forcing 检查,零不匹配;完整故事在 GPU 上自由运行 3,184,920 步,每一步都与参考一致
- 速度:L4 上约 3,300 trace token/秒,每个故事 token 约 16 秒(Qwenputer-npu 约 41 秒)
- 体积:13 层计算机层 + Qwen 的 32 层,隐藏维度 2560 → 5120,词表新增 394,164 个 trace token,bf16 共 26.7 GB(大部分是零填充);整模加载需要 40 GB 以上显存,只加载计算机层(约 13 GB)的检查和演示能放进 24 GB
对开发者意味着什么
第一,它不是产品,是一次"可编程权重"的演示。 16 秒一个 token 不会有人拿来用,作者也明确标注 Work in progress,下一步是削减隐藏维度和 checkpoint 体积。
第二,它模糊了"工具调用"的边界。 Qwenputer 里 Qwen 还是按熟悉的 <tool_call> 格式发起计算,但执行者是模型自己的层,不经过任何外部运行时。如果这类"编译进权重的确定性模块"能做小做快,一些精确计算可能不必再交给外部沙箱。
第三,线性注意力的状态是可以被精确操控的存储。 这对研究 DeltaNet/Mamba 类架构的同学是很好的反例教材:同一套状态更新规则,在特定参数下就是一块可寻址内存。
想上手怎么做
- 先看 Hugging Face 模型卡 的演示动图,弄清 trace token 是什么。
- 不下 26.7 GB 权重也能先玩:按 README,克隆 GitHub 仓库 后
uv sync --extra hf,用storyrun.py在执行器上直接跑故事程序。 - 有 24 GB 卡再下载权重,用
vxcheck --chip-only只加载计算机层做逐步校验;整模加载需要 40 GB 以上。 - 想理解原理,先读作者的 Qwenputer 博客,DeltaNet 当 RAM 的推导写得很清楚。
小杜点评
从算法工程师的角度看,QwenPU 最打动我的不是"套娃"本身,而是精确:318 万步、bf16 下逐 token 与参考一致,说明这不是"模型学会了算术"的概率故事,而是把电路确定性地写进了 Transformer。它和 Karpathy 当年提出的"Software 2.0"思路刚好反着来——不是用数据训练出程序,而是把程序编译成权重。
当然要冷静:数据全部来自作者自测,checkpoint 大且慢,离实用很远;社区里也有人做了审计,认为组件级验证扎实,但端到端执行的证明还可以更完整。我的建议是把它当作理解线性注意力状态、模型内部计算能力上限的一个好样本来读,而不是期待它替代 Python 工具。如果作者后续真把体积和速度降下来,"把小型确定性计算单元焊进模型"可能会成为 Agent 工具调用之外的另一条路。