东京时间 11 月 4 日 22:08(UTC 13:08),ggml-org 在 GitHub 打出了 llama.cpp v0.9.0。这不是一次只修 bug 的小版本:它第一次把 OCP FP8 E4M3 放进正式发布,给统一 KV cache 加了面向多序列推理的 flash_attn_ext_rows,并把底层 ggml 升到 v0.29.0——其中包含基于 NCCL 的多机张量并行初版。同一天还接进了 Mistral Large 4、Chatterbox TTS、Nemotron 3.5 Transcribe 等一批新架构和语音能力。对每天在本地或小集群上跑 GGUF 的算法工程师来说,这比再出一个新榜单模型更值得立刻看一眼。
这次到底改了什么
官方 Release 把亮点收成三条:
- 量化:新增 OCP FP8 E4M3 张量类型(饱和模式),带转换辅助和文件类型
LLAMA_FTYPE_MOSTLY_F8_E4M3(PR #27512)。 - 推理路径:新算子
flash_attn_ext_rows,让统一 KV cache 在多序列场景更高效,并宣称恢复了非统一 KV 的 prefill 表现(PR #29510)。 - 底层拷贝 API:
ggml_backend_tensor_copy_n/set_n/get_n取代旧的_2d接口,已在 Metal 和 CUDA 落地(PR #30881)。
模型侧,v0.9.0 新支持 Clover(35B-A3B-Preview,扩散模型的 AR 模式)、Limite 1B、Metis-1.6(Praxis ~2.9B / Logos ~10.2B,Mamba-2 + GQA + LatentMoE),以及 Mistral Large 4。多模态和语音扩展也不少:Chatterbox TTS、Nemotron 3.5 Transcribe(离线转写,官方写明 40 种语言、支持提示上下文和说话人归属)、Pocket TTS 预置音色,还有更准确的 Qwen3-VL 视频提示模板。Gemma 4 的 E2B / E4B 做了图优化,Release 用「massive prefill gains」描述,但没有给出具体加速数字;LFM3 则补上了 NVFP4 GGUF 和 tensor split。
NCCL 多机并行:作者自测大约 1.6–1.8 倍
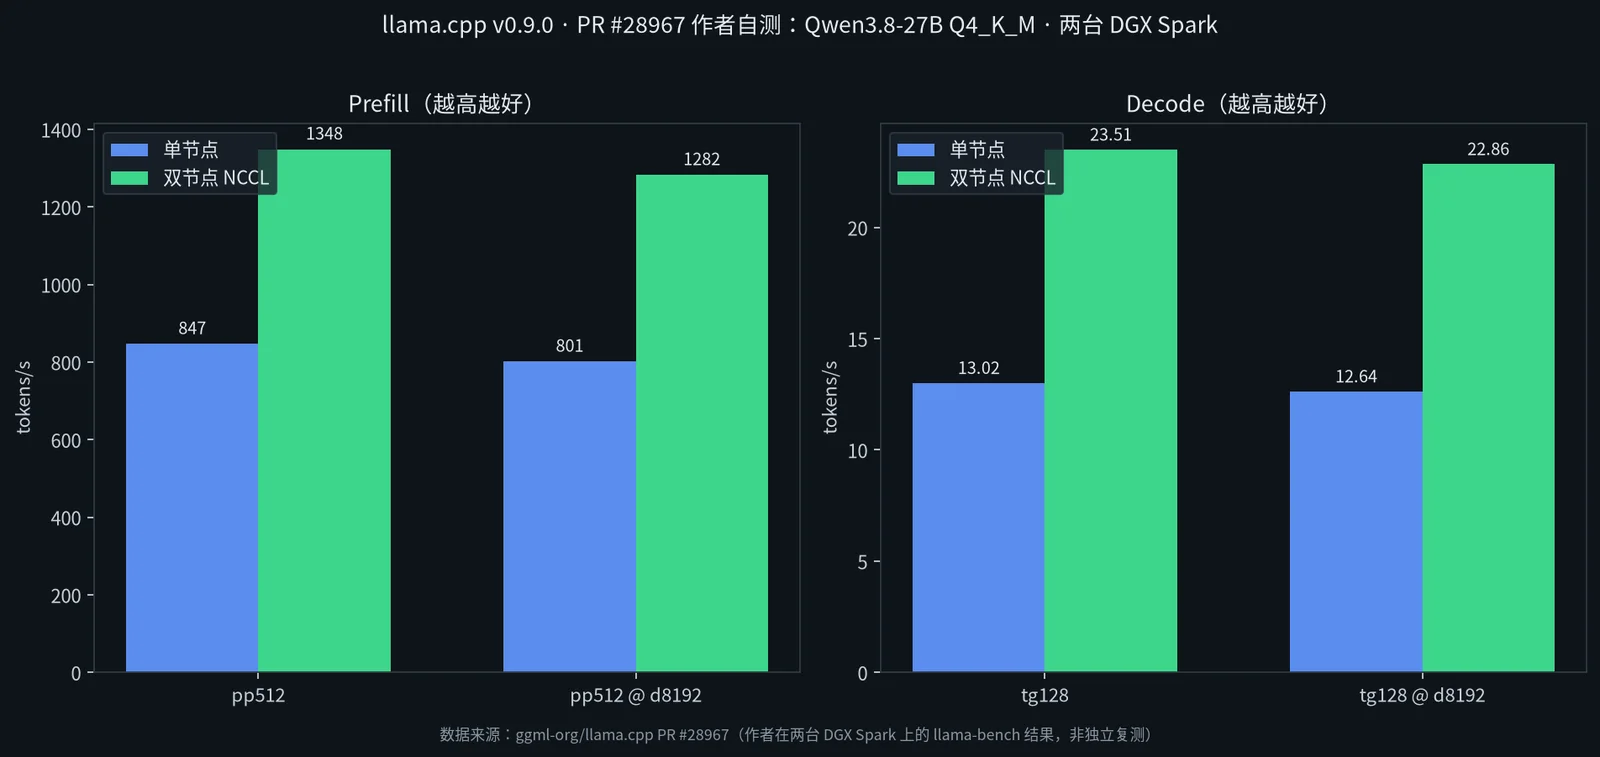
真正让本地推理「能跨机器」的,是 ggml v0.29.0 里那套多进程通信接口,以及 CUDA 后端上的 NCCL 实现(PR #28967,11 月 3 日合入,随 v0.9.0 发布)。作者在两台 DGX Spark 上用 llama-bench 跑 Qwen3.8-27B Q4KM,给出的数字是(均为作者自测):
| 指标 | 单节点 | 双节点 NCCL | 相对单节点 |
|---|---|---|---|
| pp512 | 846.54 t/s | 1348.29 t/s | 1.59× |
| tg128 | 13.02 t/s | 23.51 t/s | 1.81× |
| pp512 @ d8192 | 801.23 t/s | 1282.35 t/s | 1.60× |
| tg128 @ d8192 | 12.64 t/s | 22.86 t/s | 1.81× |
同 PR 里还对比了 pairwise 路径:decode 已经接近 NCCL(约 1.7×),但 prefill 只有约 1.14×;作者后续把 duplex、发送队列、直接注册缓冲区叠上去后,pairwise 的 pp512 可提到约 1.43×,仍低于 NCCL 的 1.59×。维护者 am17an 确认:两台 Spark 都跑在 2400 MHz 时能复现这些数字;ggerganov 在一台因功耗锁频到 1200 MHz 的机器上则看不到提升。换句话说,跨机加速高度依赖互联和时钟状态,不是开箱必然翻倍。
使用方式上,PR 示例是通过 RPC 设备做 tensor split:-sm tensor --rpc NODE1:50052,NODE2:50052 -dev RPC0/RPC1。讨论里也提到 NCCL 实例会额外吃显存(一度约每 RPC 节点多 2 GB),作者后来用 maxCTAs=8 等配置把 Spark 上的通道数压下来。升级前建议先在你自己的两机拓扑上跑同一组 llama-bench,别直接把作者的 1.8× 写进容量规划。
FP8 现在能用到什么程度
FP8 E4M3 是 OCP 定义的 8-bit 浮点(4 位指数、3 位尾数),按字节算是 FP16 的一半。这次 Release 把它做成原生张量类型,方便直接读写 FP8 权重,而不必先抬到更大精度。合入该能力的 PR #27512 写得很清楚:主 PR 面向推理常用的 E4M3 饱和模式;KV cache、CUDA、更稳健的 scale 处理、Vulkan 等是后续栈里的 PR,并不是 v0.9.0 一天全齐。
实操上可以这样理解:
- 如果你主要跑 Q4KM / IQ 系列,这次 FP8 对你短期不一定更快,整数量化仍是本地默认最优路径。
- 如果你的上游训练或导出管道已经产出 FP8,或者你想少做一次「FP8 → BF16 → 再量化」的往返,原生类型会省事。
- 升级后请在你实际使用的后端(CUDA / Metal / Vulkan / CPU)上确认:类型能加载,不代表该后端已经有完整的高速 FP8 matmul 内核。
升级时建议先核对的几件事
- API 变动:
llama.h增加了LLAMA_FTYPE_MOSTLY_F8_E4M3;mtmd.h增加了一串 TTS / voice API;server 的GET /props会报告预置音色,/v1/responses会合并extra_params。直接链库的项目要重新编译并对一下头文件。 - 多机路径仍是初版:需要 NCCL、RPC 拓扑和匹配的驱动;单卡用户可忽略,但别误以为「装了 v0.9.0 就自动多机」。
- 语音能力变宽:想在同一套 llama.cpp server 里做本地 TTS / 转写的人,可以开始试 Chatterbox 和 Nemotron 3.5 Transcribe;质量与延迟仍需自测。
- 验证命令:单机先
llama-bench对比 v0.8.x 基线;有两机再按 PR 示例开-sm tensor看 pp/tg 是否接近作者量级。
小杜点评
从工程视角,v0.9.0 的主线很清楚:把「更省的权重量化格式」和「能跨机器切模型」推进到可发布状态,同时把本地推理栈往语音和更多新架构延伸。对算法工程师,NCCL 多机并行比再多一个榜单分数更有信息量——它说明 llama.cpp 不再只满足于单机极致,而是在补小集群场景。但数字要带着条件看:作者自测、特定型号、特定时钟;FP8 的后端加速也还没收齐。我的建议是:单机用户优先关注新模型支持和 flash_attn_ext_rows 对多会话服务的影响;已经有两台同构 GPU 机器的人,值得花半天按 PR #28967 复现一轮 bench,用自己的加速比决定要不要把跨机路径写进部署脚本。