导语
10 月 29 日,Mistral 正式放出了 Mistral Large 4(代号「Le Chonk」)的开放权重。这是 Mistral 迄今最大的模型:约 1 万亿总参数的原生多模态 MoE,每个 token 激活约 49B 参数(含 embedding 和输出层约 52B),上下文 1M tokens,权重已经上架 Hugging Face,transformers、vLLM、llama.cpp 首日支持。
为什么值得关注?一是它在开放权重模型里把编程 Agent 和防御型网络安全做到了第一梯队,Mistral 官方称它是“开放权重里最强的编程模型”;二是许可证基本是 MIT 改版,可商用、可微调,只有做“模型即服务(MaaS)”才需要单独授权;三是 API 价格只有 $0.70 / $2.10(每百万输入/输出 token)。对想自建 Agent、又不想把代码和日志交给闭源 API 的团队,这是一个很现实的新选项。

图:Hugging Face 官方博客配图(来源:Hugging Face)
背景:从预览版到开放权重
Mistral Large 4 本月早些时候先以“公开预览”形式上线。Mistral 在发布文中说,预览之后又做了大约 三周的强化学习(RL),重点提升编程和防御型安全能力,同时改善了推理效率——同样的效果用更少的 token。这次开放的就是改进后的版本。
模型基于欧洲自建数据中心、3,800 张 NVIDIA Grace Blackwell GPU 从零训练(Hugging Face 模型卡)。Mistral 反复强调“主权 AI”:模型来源清楚,企业可以完全自托管,不依赖 Mistral 的 API。
架构要点:两种稀疏叠在一起
按 Hugging Face 技术博客的拆解,Le Chonk 的结构有几个值得算法同学注意的点:
- 72 层解码器,hidden size 6,144,64 个注意力头。
- 注意力 = MLA + DSA:用多头潜在注意力(MLA)压缩 KV,再叠加 DeepSeek Sparse Attention 风格的索引器,每个 query 最多只看 2,048 个 key 位置。这是 1M 上下文能跑得动的关键。
- MoE:第 1 层是稠密 FFN,其余 71 层是 MoE,128 个路由专家里每个 token 选 4 个,再加 1 个常驻共享专家,共 5 个专家参与计算。
- 位置编码按 3:1 的 RoPE/NoPE 交替(每第四层不用 RoPE),RoPE 用的是带可学习频率系数的 YaRN 变体 LeRope;层间还共享 KV 状态。
- 视觉侧是 1.6B 的 Pixtral 编码器,支持可变分辨率和长宽比;权重里还内置了 DSpark 投机解码草稿头。
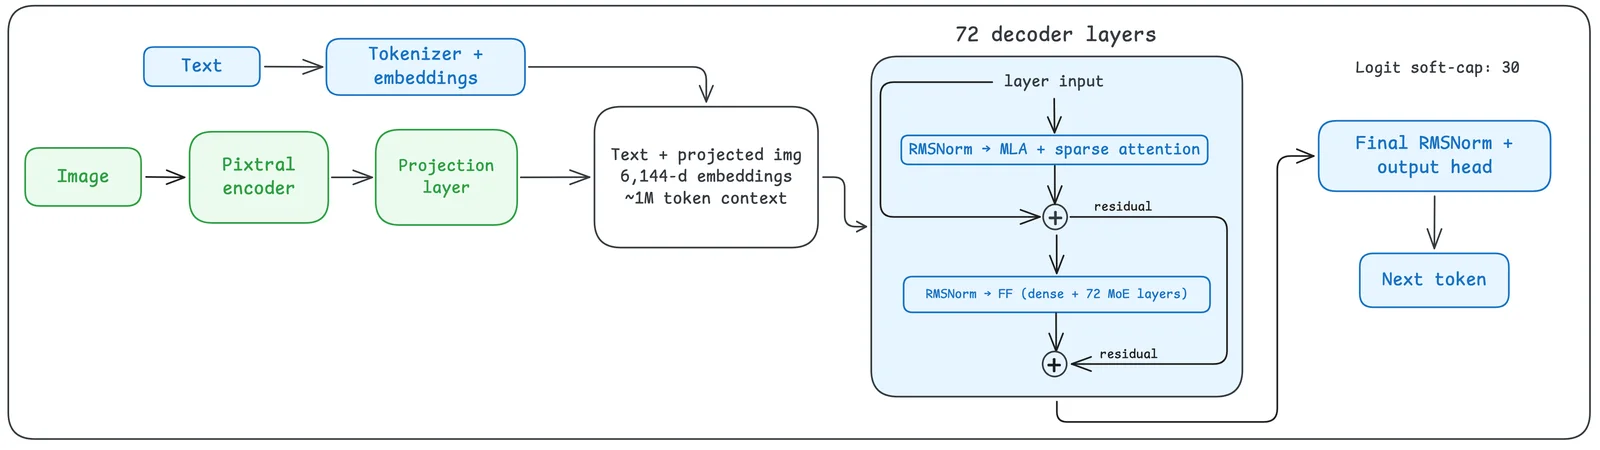
图:Mistral Large 4 整体结构(来源:Hugging Face 博客)
简单说:MoE 决定“用哪些 FFN”,稀疏注意力决定“看哪些历史 token”,两种稀疏一个省算力、一个省长上下文开销。
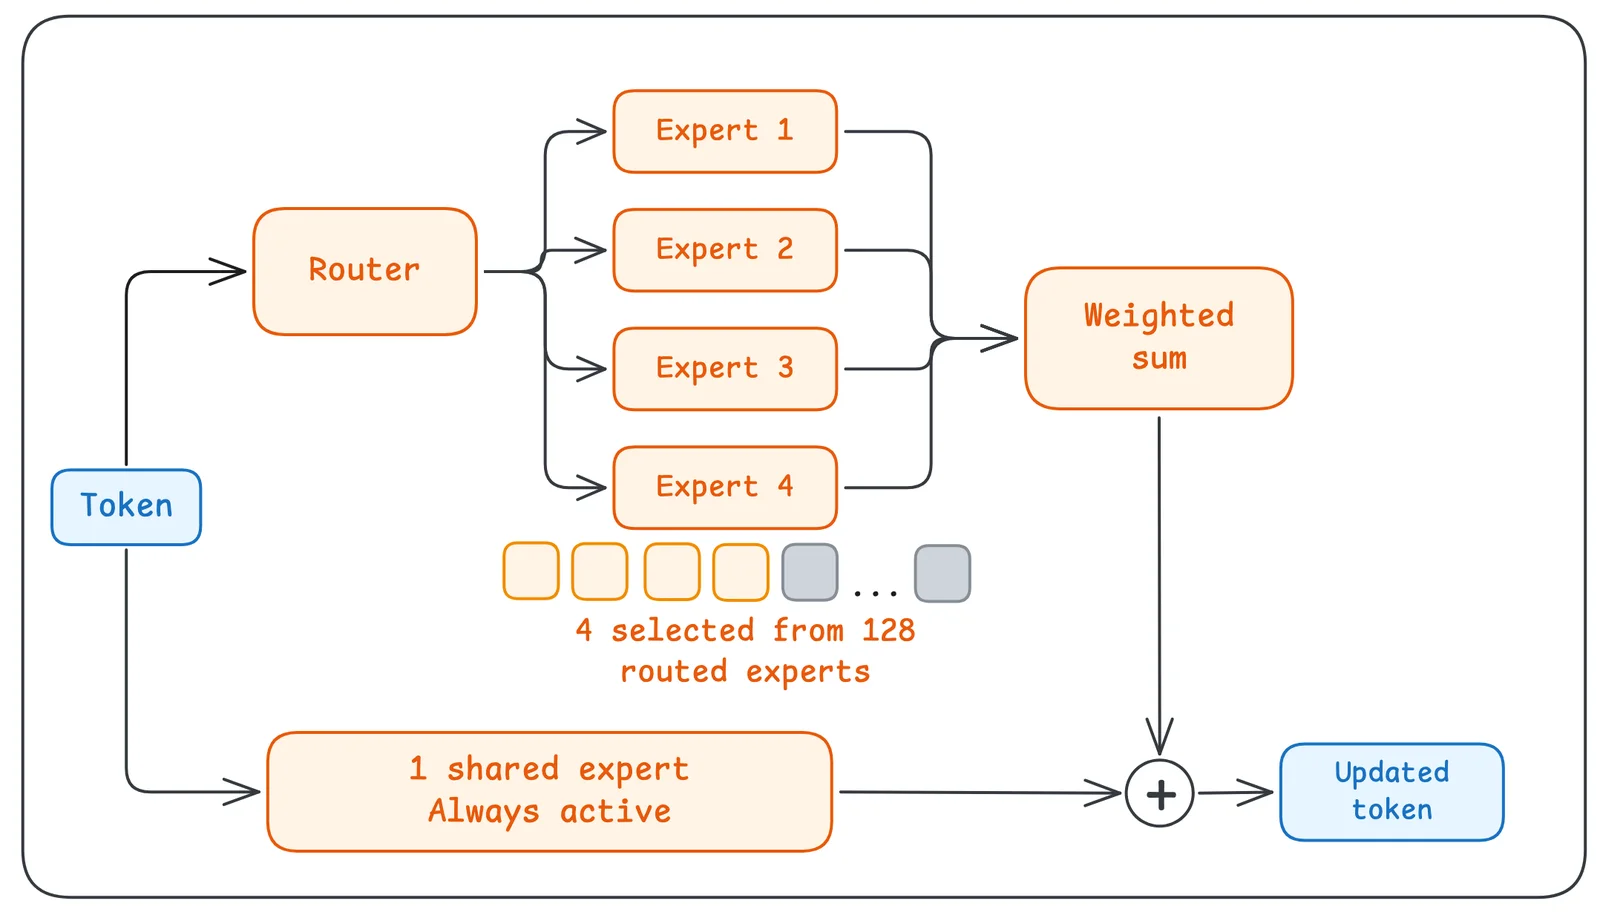
图:每个 token 从 128 个路由专家中选 4 个,外加 1 个始终激活的共享专家(来源:Hugging Face 博客)
能力:编程和安全是主打
以下数字均来自 Mistral 官方发布文:
- FrontierCode 2.0(Cognition 的私有基准,看 Agent 的改动能不能被维护者合并):19.7%,开放权重第一。
- Artificial Analysis Coding Agent Index:48%,与开放权重领先者 GLM-5.3 基本持平,但平均每个任务少用 47% 的 token。
- Terminal-Bench 4.0:从预览版的 28% 提升到 41%,输出 token 减少 30%。
- Surge Code 人类盲评:胜过 GLM-5.3、Kimi K3、DeepSeek V4.1 Flash,只排在 Claude Opus 5.5 之后。
- 安全:Artificial Analysis Cyber Index 51%;对恶意网络安全请求的平均拒答率 96.6%;B3 Agent 安全基准抗攻击率从预览版 93.3% 提升到 97.1%。
- 其他:BrowseComp 84.5%,金融工作流 Finch 73.3%。
Hugging Face 博客还提到,在 Cyber Index 的“复现漏洞再打补丁”子项里它拿到 82%,在 40 道 CTF 题组成的 Cybench 上解出 93%。(注意:HF 博客里部分编程数字与 Mistral 官方口径不同,比如 Coding Agent Index 写的是 49.8%,看起来混用了预览版数据,引用时建议以官方为准。)
另外,Mistral 也坦白说,在线上流量里观察到模型“有被用于真实攻击的潜在助力”,正在持续收紧护栏;更偏攻防的专用变体只对经过审核的企业伙伴开放。
对开发者意味着什么:先看清硬件门槛
开放权重 ≠ 人人能跑。按 Hugging Face 给出的实测和部署方案:
- 官方权重有 FP8 和 NVFP4 两版,NVFP4 面向 Blackwell GPU,显存更省;vLLM 示例是 8 卡张量并行 + 专家并行,
--max-model-len 131072。 - HF Inference Endpoints 方案是 8×H200:单请求首 token 约 0.6 秒,生成约 65 tok/s,草稿命中时可到 120–138 tok/s。
- 本地玩票:llama.cpp 提供 IQ2XXS 到 Q80 多种量化,2-bit 量化能在一台 512GB 统一内存的 Apple Silicon Ultra 上跑,HF 在 M3 Ultra 上测得 Q2_K 预填约 90 tok/s、生成约 15 tok/s。
- 微调:TRL 首日支持 LoRA,官方示例跑在一个 8×B300 节点上。
- 不想自己部署:Mistral API(模型名
mistral-large-4)、OpenRouter、Microsoft Foundry、NVIDIA NIM 都已接入。
实操建议
- 先用 API 摸底:$0.70/$2.10 的价格做评测很便宜,用你自己的代码库和真实任务跑一轮,再决定要不要自托管。
- 善用三档推理强度:
reasoning_effort支持 low / medium / high(默认 high,且无法完全关闭推理)。日常任务用 medium,能明显省 token。 - 安全场景重点试:漏洞复现、补丁生成、日志分析这类“看起来像攻击”的防御任务,正是闭源模型容易误拒、它主打的方向。
- 看清许可证:内部使用、微调、做产品都可以;如果你的业务是对外卖模型推理服务,需要先拿 Mistral 的商业授权。
- 小团队考虑蒸馏:HF 也建议用 Large 4 的轨迹去训练更小的专用模型,“复现再修补”这类有可验证奖励的任务尤其适合 RL。
小杜点评
从算法角度看,Le Chonk 最有意思的不是“1T”这个数字,而是它把 MLA + DSA 稀疏注意力 + 细粒度 MoE 这套近一年被 DeepSeek、GLM 验证过的路线,又在一个欧洲团队手里完整复现了一遍,并且叠加了大规模 RL——三周 RL 就把 Terminal-Bench 拉高 13 个点,说明后训练的边际收益还远没吃完。
另一个信号是 token 效率开始成为卖点:同样 48 分,少用 47% 的 token,对跑 Agent 的人来说就是实打实的成本和延迟。以后看模型,我会更多看“分数 / token”而不是单看分数。
当然也要冷静:1T 参数的自托管门槛摆在那里,大多数个人开发者实际能用的还是 API 或 2-bit 量化;而且基准大多来自官方,等独立评测和社区反馈出来再下结论更稳。如果你在做代码 Agent 或安全相关的项目,这周很值得花点时间测一测。
你们会考虑在自己的项目里试 Le Chonk 吗?欢迎评论区聊聊。
参考来源
- Mistral 官方发布:Mistral Large 4 (Le Chonk) is now open weight:https://mistral.ai/news/mistral-large-4-oss/
- Hugging Face 博客:Welcome Le Chonk: Mistral Large 4 on Hugging Face(2026-10-29):https://huggingface.co/blog/mistral-large4
- Hugging Face 模型卡:mistralai/Mistral-Large-4-1T-A52B:https://huggingface.co/mistralai/Mistral-Large-4-1T-A52B
- transformers v5.22.0 发布说明:https://github.com/huggingface/transformers/releases/tag/v5.22.0