OpenAI 在 11 月 18 日发布了第二份关于「AI 加速 AI 研究」的内部报告《Research acceleration: The jagged frontier》,更新了今年 9 月那份报告的数据。核心结论一句话:Coding Agent 在 OpenAI 内部已经能独立完成近一半 2 到 4 小时的研究任务,但能力分布极不均匀——有的活干得比人还稳,有的活一上手就翻车。OpenAI 自己用的词是「jagged frontier」,锯齿状的前沿。
这份报告值得细读,因为它不是一场发布会,而是一家顶级实验室把自家研发流水线的内部仪表盘公开了:Agent 每天烧多少钱、哪些任务已经可以撒手、哪些还得人盯着,全都给了数字。
近一半 2–4 小时任务,Agent 自己搞定了
报告的核心指标叫「零干预成功率」:任务交出去之后,Agent 全程独立完成、中间没有任何人插手,就算成功。OpenAI 用自家 GPT-6 Astra Agent 评估了一批交互式 Coding Agent 日志,再结合人工判断,给出了估计值。
从 3 月到 10 月,需要 2 到 4 小时人类工作量的任务,零干预成功率从 23% 涨到了 46%,翻了一倍;需要 4 到 8 小时的任务,从 13% 涨到了 35%。也就是说,如今交给 Agent 一项「半天量级」的研究任务,接近一半的概率你完全不用管,回来就能收工。
但这个数字要配着报告自己的提醒一起看:随着 Agent 变强,研究员也在改变「把什么任务交给它」的选择。成功率的上升,一部分是模型变强了,一部分是人更会挑任务了。OpenAI 坦承这是内部估计,不是独立评测,任务耗时也是模型估计的,还需要更多验证。
真正有信息量的是按任务类型拆开的细账。统计窗口是 2026 年 8 月 1 日到 10 月 18 日:
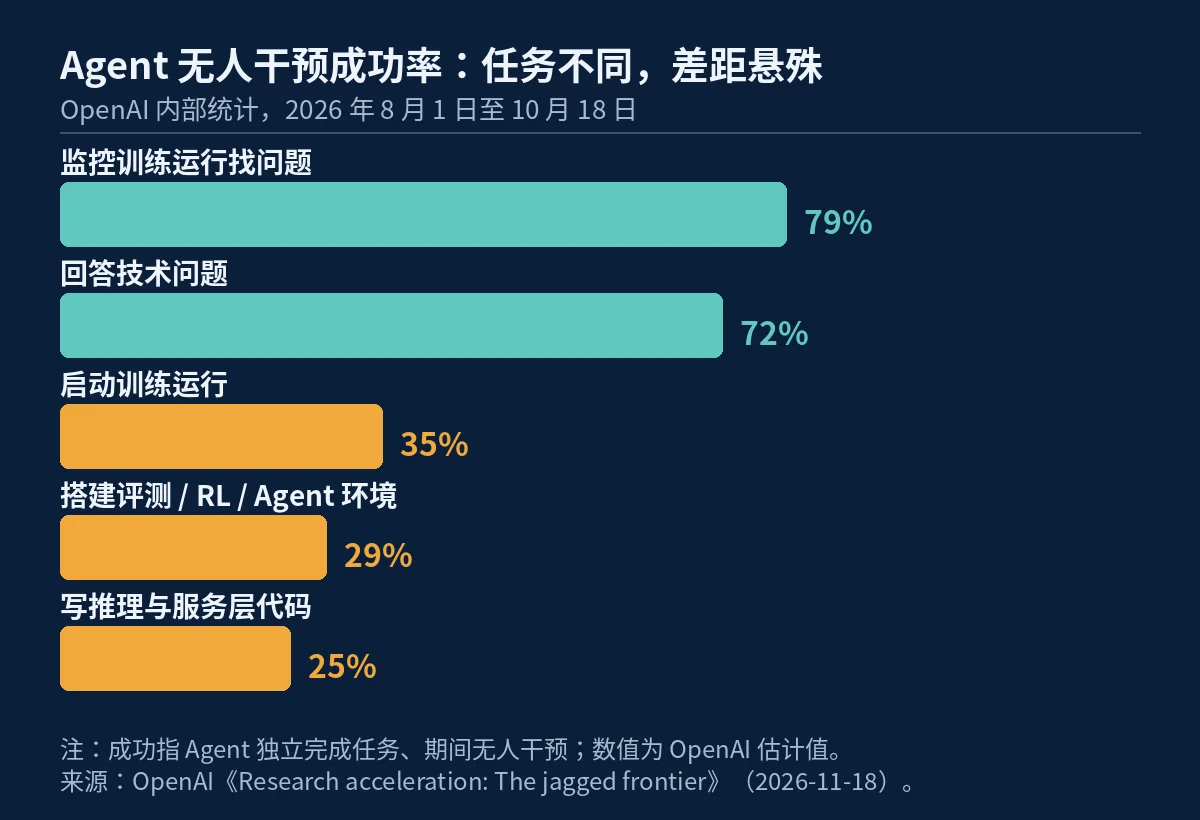
监控训练运行、发现问题:79%。回答技术问题:72%。这两类活 Agent 已经相当可靠。往下掉得很快:启动一次训练运行只有 35%,搭建评测、强化学习或 Agent 环境只有 29%,写推理与服务层代码只有 25%。按大类分,沟通类任务 69%、分析类 58%、构建类 43%。
这个分布就是「锯齿状」的意思:Agent 不是均匀地变强,而是在某些任务上已经摸到天花板,在另一些任务上还卡在四分之一。OpenAI 的判断很直接——表现最弱的那几类,可能会成为整体研发提速的瓶颈。换句话说,Agent 能不能加速 AI 研究,不取决于它最擅长什么,而取决于它最不擅长的那几块能不能补上来。
研究员每天烧 2400 美元,头部用户 2.3 万
用量数字比成功率更夸张。按 API 标价算,OpenAI 研究员 10 月每天中位数的 Agent 花费是 2400 美元,比 9 月的 1500 美元涨了 62%;90 分位的研究员每天要花 23000 美元,比 9 月的 11000 美元涨了 105%。头部用户拉开差距的速度比中位数更快。
换个更直观的单位:OpenAI 把每 8 小时 Agent 运行折算成一个「Agent 工作日」。每位研究员每天的 Agent 工作日从 0.5 个涨到了 5.7 个,11 倍。其中预训练和后训练团队最高,平均每天约 8 个 Agent 工作日;规模与基础设施团队约 4 个。也就是说,一名研究员每天名义上指挥着相当于五六个全职 Agent 的算力。
并发数也在涨。到 10 月中旬,超过三分之二的研究员每天峰值同时跑至少 4 个 Agent,超过 10% 的人峰值同时跑 16 个以上。研究员的工作方式已经从「写代码」变成了「同时指挥一支 Agent 小队」。
花这么多钱,值吗?OpenAI 做了一次很有意思的调查。2026 年 8 月底到 9 月初,他们问了 101 名研究员一个假设问题:如果未来三个月收走所有比 GPT-5.2 更强的 Coding Agent,你愿意拿什么换回来?中位数的回答是:40% 的团队人头,或者 30% 的团队算力。没有 Agent 的情况下,研究员估计要花 3 个月才能做出过去一个月的工作量——前提是只能用 GitHub Copilot 加 ChatGPT。
10 月底的另一项小调查更直接:27 名受访者里有 27 人表示,日常工作更愿意用最新的内部模型,而不是一位职业中期的人类研究工程师加一个 2024 年的模型(o1-preview)。样本很小,但信号很明确:在 OpenAI 内部,顶级模型已经是研究员默认的「同事」。
安全与对齐,成了投入增长最快的方向
报告里还有一个容易被忽略的数字:从 1 月到 9 月,安全与对齐方向有记录的研究工作量增长了 77%,是所有研究方向里绝对增量最大的。增长来自新招的人,也来自现有研究员转岗。拐点出现在 7 月 Hugging Face 事件之后。
这个数字放在整份报告里看很有意思:一边是 Agent 能力快速爬坡,一边是安全与对齐的人力投入同步爬坡。OpenAI 没有把这两件事写成对立面,而是写成了同一件事的两面:模型越能自己干活,越需要有人盯着它怎么干活。
创意还在人手里,但「品味」的保质期没人敢保证
报告最诚实的部分是访谈。OpenAI 访谈了预训练、后训练和安全方向的 10 名研究员,总结出五个主题,几乎句句都是工程师的日常:
Agent 最擅长的是把代码落地、调试和盯实验。一位做评测的安全研究员说,过去把一个开源评测移植过来、跑通各种消融实验验证它好不好用,要花一到一个半星期;现在从零到跑起来,「一天,也许几天」。
但 Agent 的「品味」很差:想不出好问题、写不出好代码、产不出好数据、写不好文章。一位做强化学习环境的研究员说,模型「一般没法一口气想出一个它自己解决不了的好问题」,让它生成一百个数据点,出来的东西都长一个样。
工作流因此变得非常依赖人盯着:Agent 会低效地启动实验、钻进不必要的步骤、提交「AI 味很重」的 PR、产出没法用的数据、做出错误的分析假设。一位做后训练评测的研究员总结了自己的经验:以前说「照着那个任务做一个一样的」,被坑太多次之后,现在改成「先做一个,我审一遍改好,你再去做剩下的」。
关于创意从哪来,报告给了个干净的答案:研究员们为 GPT-6 Astra 和 GPT-6.2 Astra 列出的最重要想法,据他们所知全部来自人,模型负责落地。唯一例外是 GPT-6.2 Astra 的预训练方向:一位研究员说,和 Codex 一起推演想法时,Codex 发现了关键洞见;另一位说,主意是自己的,但 Codex 提了一个改动之后才真正跑通。
不过没有人敢把「创意属于人类」当成永久结论。一位预训练研究员的话被原样引用:「我确实觉得自己在想法上更有品味,但我完全没有信心这种情况会持续很久。」
产出端:实验多了 68%,能力曲线还在加速吗
光看投入和过程还不够,报告还给了产出侧的三个指标。前两个是老指标:每位活跃贡献者改动的代码行数在 2026 年继续大幅上升;每位活跃实验者跑的实验数,在截至 10 月 18 日的四周里平均是 2025 年基线的 1.68 倍。实验密度上去了,但 OpenAI 自己也提醒:代码行数和实验数涨了,不等于研究进展真的变快了。
所以报告引入了第三个指标 OpenAI ECI——内部版的 Epoch 能力指数,用公开基准加内部基准的组合来衡量模型能力。自 2025 年 8 月以来,OpenAI 模型的 ECI 前沿每年上升 16.4 分,而 Epoch 观测到的行业趋势是自 2024 年底以来每年 14 分。
OpenAI 的结论留有余地:这些趋势都是「人类加 AI 协作」的历史数据,未必能预测未来的进展速度。报告还提到,最近前沿模型在数学上出现了「突然且快速的突破」,他们正在密切关注深度学习领域会不会出现类似的跃升。
报告最后回到了它一再强调的主题:AI 实验室应该被要求追踪并公开报告递归自我改进(RSI)的指标,也就是 AI 加速下一代 AI 研发的过程。OpenAI 同时声明,公开这些数据不应被理解为他们打算追求完全的递归自我改进。这份报告本身就是一次表态:把仪表盘亮出来,让所有人都能看到加速进行到了哪一步。
小杜点评
这份报告最值得带走的不是 46% 这个数字,而是它背后的工作方式:OpenAI 的研究员已经不再把 Agent 当工具,而是当成一支需要指挥、审查和纠错的队伍——每天 5.7 个 Agent 工作日、峰值 16 个并发、愿意拿 40% 人头去换三个月的使用权,这些数字拼出来的是一张新工种的画像:研究员的核心能力正在从「自己写」变成「会挑任务、会审结果、会在 Agent 跑偏时一把拽回来」。
对国内的算法工程师来说,有两点可以直接对照:第一,别只看 Agent 在你最顺手的任务上有多强,去测它在你最弱的环节上有多弱——推理服务代码 25% 的成功率提醒我们,瓶颈任务决定整体提速;第二,「品味」暂时还是人的护城河,但连 OpenAI 的研究员都不敢保证它能守多久,现在就该把「怎么给 Agent 出好题、怎么审它的产出」练成肌肉记忆。
参考来源
- OpenAI《Research acceleration: The jagged frontier》(2026-11-18):https://openai.com/index/research-acceleration-jagged-frontier
- New Runtime 对该报告的梳理:https://newruntime.com/posts/research-acceleration-the-jagged-frontier-5f108d/
- Kingy 对该报告任务成功率数据的整理:https://kingy.ai/blog/openai-research-agents-jagged-frontier/