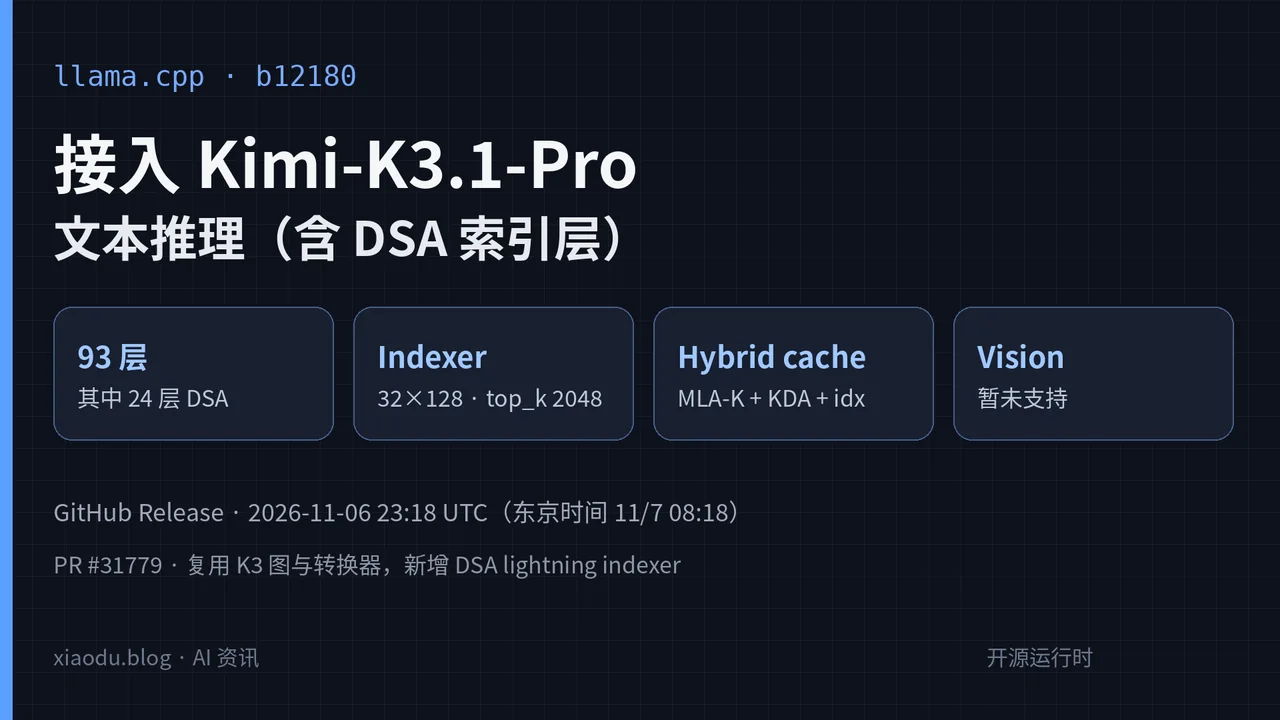
东京时间 11 月 7 日 08:18(官方 Release 时间 2026-11-06 23:18 UTC),ggml-org/llama.cpp 发布 b12180(pre-release)。这次构建的核心变更来自已合并的 PR #31779:在本地推理栈里接上 Kimi-K3.1-Pro 的文本路径。对已经在看 Moonshot 开源权重(本站此前写过 Kimi K3.1 Pro 权重与结构)的工程师来说,这意味着「权重能下」之后,「用 llama.cpp 怎么转、怎么跑」也补上了一截——视觉塔与 mm_projector 仍未接入,当前仅文本。
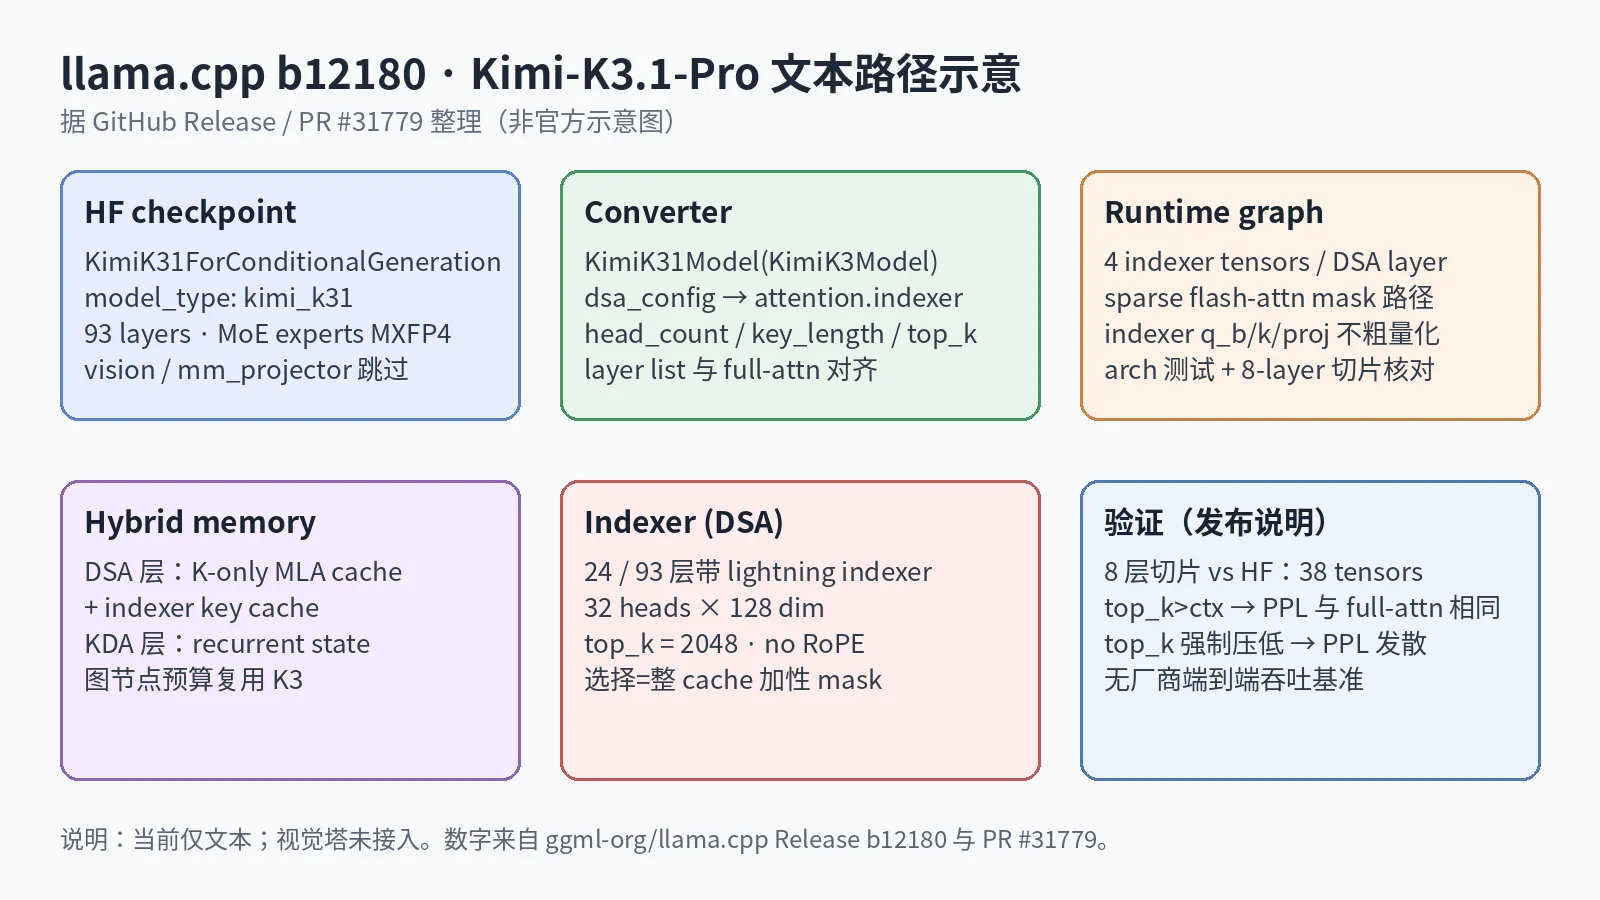
它改了什么:K3 骨架 + DSA,而不是整图重写
发布说明把关系说得很直接:K3.1 在这条 checkpoint 上,把原先全注意力的 MLA 层换成了 DSA;其余 K3 骨架——KDA(线性注意力)层、跨层残差、latent MoE、SiTU、MLA output gate、full-rank KDA gate——基本不动。因此实现上是 复用 K3 的计算图与转换器,再挂上 indexer。
具体到本 checkpoint(发布说明数字):93 层里有 24 层带 lightning indexer(32 heads × 128 dim,top_k = 2048,无 RoPE)。Indexer 的选择方式是对整段 cache 做 加性 mask,而不是把 top-k 行 gather 出来,从而复用已有的 sparse flash-attention 路径;离开该路径时 mask 仍正确,但仍会付出整 cache 的 kq 代价。Indexer key 的 LayerNorm eps 取自模型的 rms_norm_eps,因为 dsa_config 自身不声明 eps。
转换与量化:文本 only,indexer 精度要留着
转换侧新增 KimiK31Model(KimiK3Model),由 KimiK31ForConditionalGeneration 选中;dsa_config 映射为 attention.indexer.{head_count,key_length,top_k,types} 以及 indexer LayerNorm eps。层列表与 linear_attn_config 一样是 1-indexed,转换器会断言它恰好覆盖全部 full-attention 层。Routed experts 保持 MXFP4 并按 K3 方式 repack,不做反量化。Vision tower 与 mm_projector 直接跳过。Arch key 跟 checkpoint 的 model_type(kimi_k31)走;HF 展示名里的 -Pro 后缀并不出现在 config / tensor 名里。
量化上有一条实操提醒:indexer 的 q_b、k、proj 被刻意留在 quant override 之外——发布说明写明 top-k 选择对这些张量的精度敏感。PR 作者还提到在 BF16/MXFP4 转换,以及 q2/q2/q3 的 gate/up/down 量化路径上做过自测;社区评论里有人用 tiny-random checkpoint 对比 CPU / CUDA 的 llama-completion 输出一致。这些都属于 贡献者自测 / 社区验证,不是官方端到端吞吐基准。
运行时:混合缓存,以及目前验了什么
图与 cache 侧为 DSA 层准备了 四个 indexer 张量,并采用混合 memory:DSA 层保留 K-only MLA cache + indexer key cache;KDA 层保留 recurrent state。图节点预算与 K3 入口共享。
发布说明给出的核对范围是:在 8 层切片上对照 HF checkpoint,精确检查了 38 个张量,并对 indexer metadata、以及「相对 full attention 的 selection」做了对照——当 topk 大于上下文长度时 PPL 与 full attention 一致;把 topk 强制压到上下文以下时 PPL 会发散。Arch fixture 与完整 arch suite 通过。本 Release 未提供端到端 tokens/s、显存曲线或长上下文 Agent 场景数字;若你要写本地部署评估,需要自己在目标量化与硬件上补测。
怎么用、还缺什么
Release 页提供了多平台预编译包(含 CUDA 12/13、Vulkan、ROCm、OpenVINO、Windows/macOS/Linux/Android 等)。手头已有 Kimi-K3.1-Pro 文本权重的人,可以升到 b12180 后走新增转换器生成 GGUF 再推理。需要注意三点:
- 只做文本:多模态输入还得等后续 PR;
- 体量很大:2.8T 级 MoE 本地跑对磁盘与显存都不友好,量化策略与 expert offload 仍是硬门槛;
- 这是 nightly 式 pre-release:适合先验证转换与短测,生产环境仍建议盯后续稳定标签与社区 GGUF。
小杜点评
Kimi K3.1 Pro 权重开放后,生态瓶颈很快从「有没有权重」转到「常见 runtime 能不能正确吃下 DSA」。b12180 做对了两件工程上关键的事:一是 少发明、多复用(K3 图 + indexer 插件),二是 把精度敏感张量单独留出来,避免量化把 top-k 选坏。对算法工程师,更值得读的是发布说明里那几行实现约束——加性 mask、hybrid cache、layer list 断言——而不是再复述一遍参数表。下一步我会更关心视觉塔何时接入,以及社区在 1M 上下文附近的实测显存与 PPL;在那之前,把它当「文本路径可用性补丁」来跟即可。