博客
AI 资讯、算法拆解和上手教程。一共 390 篇,新写的在最上面。
- 2026/11/01AI资讯约 5 分钟读完
在 Qwen3.5-4B 的权重里跑另一个模型:QwenPU 把向量单元"编译"进 LLM,逐 token 精确
开发者 Divyansh Agrawal 于 2026-10-31 发布 QwenPU:把 RISC-V CPU 和 64 通道向量单元编译进 Qwen3.5-4B 权重(零训练),让 Karpathy 的 stories260K 在前向传播里写故事,318 万步全部精确;每故事 token 约 16 秒、权重 26.7 GB。本文拆解原理、关键数字和上手方式。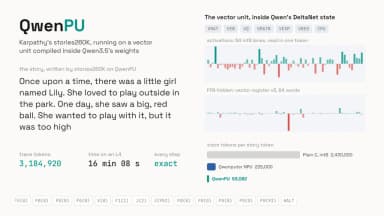
- 2026/11/01AI资讯约 5 分钟读完
36 种 Transformer 变体同算力公平比:NextTransformer 开源,混合架构和残差改造跑赢 Dense 基线
NextTransformer(MIT)10 月 31 日开源:36 种注意力、稀疏、线性、循环、残差和混合结构,用同一数据、同样 49.152B tokens、对齐到 ±1% 的训练算力对比,公开 31 组结果。mHC、AttnRes 和 GDN 混合架构在 CORE 与 BPB 上都优于 Dense 基线。本文解读协议、榜单与上手门槛。