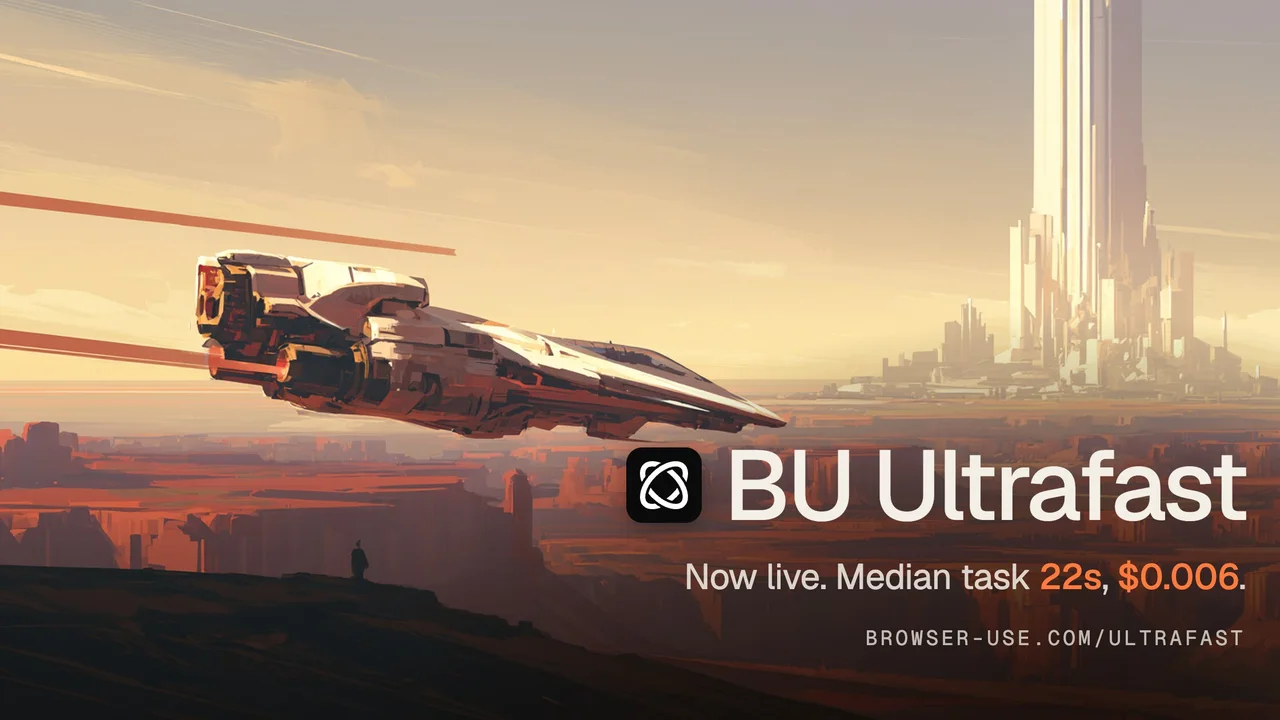
东京时间 11 月 1 日 04:48(北京时间 03:48),浏览器 Agent 公司 Browser Use 在 X 上宣布:BU Ultrafast 向所有人开放。这是他们最快的网页 Agent 预设,10 月 30 日之前还要排队申请,现在美国区 Browser Use Cloud 的每个套餐都能用,免费版也包括在内。官方博客给出的真实流量数据是:单任务中位 22 秒、$0.0064,而他们默认的 GPT-6 Luna Agent 是 79 秒、$0.0098。网页 Agent 一直被吐槽「又慢又贵」,这次是把速度和单价同时往下压了一截,而且切换只需要改一个字段,值得做自动化的同学看一眼。
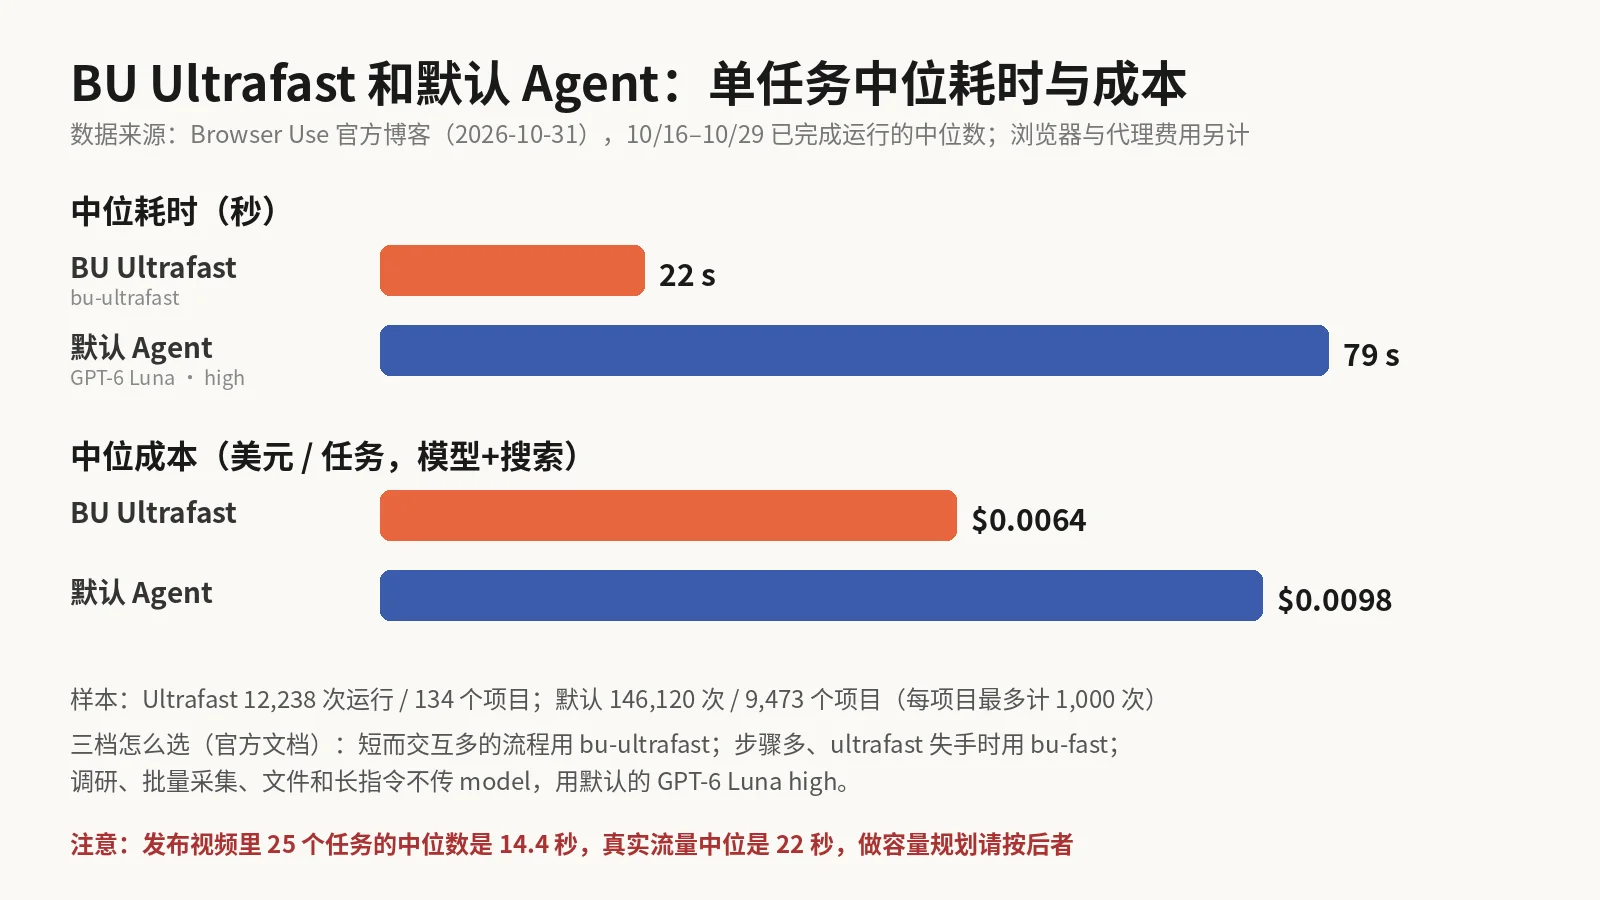
先看数字:14.4 秒和 22 秒,该信哪个
发布推文里写的是「部分任务 3 秒内完成、任务中位 14.4 秒、视频里 25 个任务总共 $0.126」,并强调视频是实时录制、没有加速。但同一天发出的官方博客,用的是另一套口径:
- 样本:10 月 16 日到 29 日已完成的运行,每个项目最多计 1,000 次;Ultrafast 共 12,238 次、来自 134 个项目,默认 Agent 共 146,120 次、来自 9,473 个项目;
- 结果:Ultrafast 中位 22 秒、$0.0064,默认 Agent 中位 79 秒、$0.0098,官方的说法是「快 3 倍以上,单任务还更便宜」;
- 同项目对照:在两种 Agent 都跑过 20 次以上的 8 个项目里,Ultrafast 全部更快也更便宜;
- 成本口径:只算模型和搜索费用,浏览器和代理另外计费。
所以做容量规划时,请按 22 秒 而不是 14.4 秒估算。演示视频里的 25 个任务是挑过的,真实流量里的任务更杂,这很正常,官方也把两套数字都公开了。另外要注意,这些都是厂商自己统计的数据,Ultrafast 早期用户(134 个项目)和默认 Agent 用户(9,000 多个项目)的任务构成也不一定相同。
它到底是什么:一个预设,不是新模型
按官方文档的描述,BU Ultrafast 是 V4 API 里的一个低延迟预设:用 Browser Use 自家的 Pi Agent 以 ultrafast 模式运行,底层模型是 GPT-6 Luna、低推理强度,并走 OpenAI 的 priority 服务档。它还有一个兄弟预设 bu-fast,是同一个 Agent,换成中等推理强度和标准档。
文档给的选择建议很直白:
| 任务类型 | model 参数 |
|---|---|
| 短流程、交互密集(点击、填表这类) | bu-ultrafast |
| 同类流程但步骤更多、ultrafast 会失手 | bu-fast |
| 调研、批量采集、文件处理、长指令 | 不传 model,用默认的 GPT-6 Luna(high) |
也就是说,速度是用「每一步少想一点」换来的。任务越短、越确定,越适合 Ultrafast;需要多步规划的任务,还是交给高推理强度的默认 Agent 更稳。
价格怎么算
这里有个看起来矛盾的地方:priority 档的 token 单价是标准档的 2 倍,但单任务成本反而更低。官方没有拆解原因,我的推测是低推理强度让每个任务消耗的 token 少了很多,抵消了单价翻倍,这一点建议你用自己的任务实测确认。
几条计费细节:
bu-ultrafast按 OpenAI priority 费率计 GPT-6 Luna 的 token(标准档的 2 倍);bu-fast按标准费率;- HIPAA 项目和只能用 Bedrock 的项目,Ultrafast 会退回标准档运行;
- 如果用自己的 OpenAI Key(BYOK),token 由 OpenAI 直接向你收费,Browser Use 另收 0.2 倍的编排费;
- 免费套餐(还没买过额度的项目)可用的模型有限,但
bu-ultrafast和bu-fast都在名单里。
上手和避坑
切换真的只要一个字段,官方示例:
curl https://api.browser-use.com/api/v4/runs \
  -H "X-Browser-Use-API-Key: $BROWSER_USE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"task": "Find the top Hacker News story", "model": "bu-ultrafast"}'
Python SDK 里是 client.runs.create("...", model="bu-ultrafast"),记得先 pip install --upgrade browser-use-sdk。文档里写明的几个坑:
- 不能再带别的参数:同时传
modelParams、mode或harness: "browsercode"会直接返回 422; - 预设绑定会话:同一会话的后续追问会沿用这个预设,中途想换别的
model或modelParams同样返回 422,要换就新开会话; - 默认不走代理:新会话不带托管代理,访问有地域限制或反爬严格的网站时,要自己设置
browserSettings.proxyCountryCode(比如"us"); - 目前只在美国区:官方说的是美国区的所有 Cloud 套餐,EU 部署是否可用,文档里没有写。
小杜点评
从算法工程师的角度看,这次发布最有意思的不是「最快」这个口号,而是它把一个常被忽略的事实摆上了台面:网页 Agent 的瓶颈很多时候不在模型能力,而在每一步的推理时延。一个任务往往要几十步,每步多想几秒,累积下来就是一分多钟。Ultrafast 的做法是降低推理强度、再花钱买 priority 档的低延迟,本质上是在「单步质量」和「端到端时延」之间重新选了一个点。
我的建议有三条。第一,先把你的任务按长短分桶:短而确定的流程(查价格、填固定表单、抓一个页面的几个字段)直接上 Ultrafast,长流程保留默认 Agent,别一刀切。第二,评估时看的是「成功率 × 单价 × 时延」的组合,而不是单看中位数;低推理强度失手后重试一次的成本,也要算进去。第三,做批量任务时记得把浏览器和代理费用加回来,官方的 $0.0064 不含这两项,真实账单会比这个高。