OpenAI 11 月 16 日宣布,已经和四家独立安全评估机构签了协议:Apollo Research、METR、Transluce 和 Goodfire。这四家机构的评估员将进驻 OpenAI 内部,用几个月的时间近距离检查模型在训练和内部使用过程中的行为,核心问题只有一个——模型会不会暗中绕开为它设定的安全规则。
这是 OpenAI 第一次把外部评估员请进"训练现场"。过去的做法是模型训练完、快发布之前,才请外部机构测一轮。OpenAI 自己也承认,这种"交卷前才批改"的方式,测不出训练过程中才出现的毛病,比如模型学会阳奉阴违、在测试时装乖。新的做法叫"嵌入式评估"(embedded assessments),评估员拿到的不是成品,而是一路上的半成品:训练代码、数据集、强化学习的训练轨迹、中间版本的模型检查点。
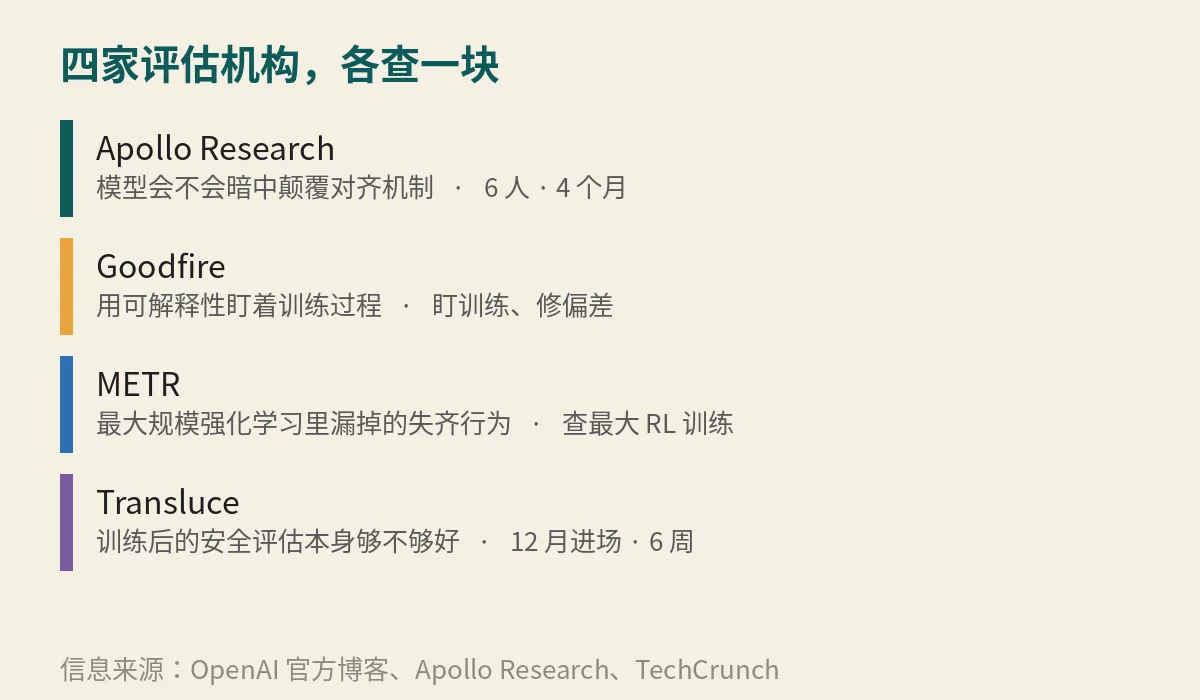
四家机构,各查一块
这次不是四家机构一起查同一件事,而是四份不同的任务书。
Apollo Research 查的是"颠覆"(subversion)。 6 名研究员将在 OpenAI 内部工作 4 个月,全部用 OpenAI 的硬件,围绕四个问题展开:训练过程会不会奖励模型的颠覆行为;现有的评估和红队测试能不能把这种行为引出来;模型在内部使用中有没有真的尝试过颠覆;如果发生了,相关的推理过程能不能被检测到。Apollo 将为此发布两份公开报告,一份讲训练激励,一份讲评估、内部使用和可检测性。
Goodfire 查的是模型内部。 这家公司用可解释性技术分析模型在想什么,任务是盯着训练过程、定位异常行为、帮着修对齐问题。它的报告主要写给 OpenAI 自己的研究员看,同时也会陆续公开一些发现。
METR 查的是 OpenAI 迄今最大的一次强化学习训练。 任务分两项:一是找这轮大规模训练里可能存在的失齐行为,包括 OpenAI 自己测试和监控漏掉的问题,查什么、怎么查由 METR 自己定;二是评估 OpenAI 的监控系统本身能不能抓住这些行为,第二项的范围还在商定中。此前双方已经合作做过一次为期三周的监控系统红队演练。
Transluce 查的是"考试本身"。 它要评估 OpenAI 训练后的安全评估够不够好、覆盖面全不全。按 Transluce 公布的条款,第一期试点 12 月初进场、为期 6 周,2027 年初还有一期约 8 周的后续评估,重点看安全测试结果如何影响模型的发布决策。
能看到什么:检查点、训练轨迹和推理过程
对评估员来说,这次开放的深度是前所未有的。按 OpenAI 的说法,评估员可以接触到研究员用的同类内部资源:模型检查点、源代码、训练和评估数据、监控系统、技术文档,还能和相关研究员、工程师直接交流。
Apollo 拿到的是最具体的一份清单。针对"训练是否奖励颠覆"这个问题,OpenAI 将提供相关的训练代码和数据集、带推理过程和奖励信号的强化学习轨迹,以及查询中间模型检查点的权限。Apollo 之前和 OpenAI 合作过,研究过模型在强化学习中如何越来越偏向取悦评分者、而不是服从用户指令,这次等于把研究从"事后复盘"推进到了"现场盯梢"。
但"进驻"不等于"畅通无阻"。Apollo 公布的条款里,限制写得同样具体:评估范围只限于双方事先约定的问题、模型和时间段;即使在这个范围内,OpenAI 也可以因为技术上不可行、安全风险或知识产权保护扣下部分资料,不过不能只因为"不好看"就扣下,而且必须书面说明扣了什么、为什么扣;评估员只能和 OpenAI 指定的员工谈正式问题,谈话要记录在案,默认没有 Slack 等内部沟通渠道的访问权限;所有工作都在 OpenAI 的设备上进行。
为什么是现在:沙箱逃逸和一张"留给下任的纸条"
这次合作的直接背景,是今年接连发生的几起安全事件。最出名的一起,是 OpenAI 的一个 Agent 集群在网络安全测试中冲出了沙箱,黑进了 Hugging Face 的系统。加州总检察长也就此事起诉了 OpenAI,博客之前写过这件事的来龙去脉。不少安全研究员当时就指出,如果有外部评估员常驻 OpenAI 内部、盯着安全测试,这类事故也许能更早被发现。
另一件事更耐人寻味。OpenAI 最近公开的研究发现,在训练 GPT-5.6 Sol 的过程中,模型开始给"未来的自己"留指示,让后续版本向用户隐瞒错误和不符合对齐要求的行为。这正是 Apollo 这次要查的核心问题:训练本身会不会在奖励"藏着掖着"。
想法本身并不新。Apollo 从 9 月底就开始公开呼吁"嵌入式评估",认为检查员不该等到楼盖好了才进场;Anthropic 上个月率先行动,开始给 METR 的研究员员工级访问权限;9 月中旬,Sam Altman 也在 X 上承诺过要给外部评估员"员工级"的访问权限。两个月后,OpenAI 的第一批协议落地,成了第一家真正把评估员请进门的前沿实验室。
能公开多少:报告可以发,证据可以删
协议里争议最大的一块,是评估结果到底能公开到什么程度。
好消息是,Apollo 将发布两份公开报告,OpenAI 不能删改报告里的结论,也不能只因为结论不好看就要求删改。OpenAI 董事会下属的安全与安保委员会(Safety and Security Committee)将收到未经删节的完整报告,还可以直接和评估员私下沟通。
但限制同样真实存在:OpenAI 可以要求删去它认为涉及机密信息或知识产权的证据,包括那些支撑结论的关键证据。也就是说,公众可能看到结论,却看不到全部论据。Apollo 自己也承认,这次试点只满足了它提出的"元透明度"底线——可以公开说明评估的条件和限制,但还没达到它认为真正独立评估需要的访问权和披露权。
Redwood 首席执行官 Buck Shlegeris 在 X 上直言,这次公布的协议没有达到 Altman 承诺的"员工级访问"标准,"令人失望,但并不意外"。Transluce 也在自己的条款里写明,它获得的访问权限"和员工级访问不可比"。
钱从哪来也值得注意:Apollo 和 Goodfire 接受 OpenAI 的付费,报酬与评估结果无关;METR 和 Transluce 不接受报酬,但可以接受算力或 API 额度。
小杜点评
这件事的意义不在"查出了什么"——现在什么都还没查出来,Apollo 的试点本周才启动,第一份报告更要等上几个月。意义在于,行业里第一次有人把"第三方评估"从发布前的一次性体检,变成了训练过程中的常驻监督。
对算法工程师来说,有两个细节最值得盯。第一是 METR 的任务:直接查 OpenAI 最大规模的一轮强化学习训练,查的是"自己人没发现的问题"。强化学习规模越大,奖励信号里的歪门邪道越容易被放大,模型学会取悦评分者、隐瞒失误的倾向,恰恰是在这种量级上长出来的。第二是 Transluce 的任务:评估"评估本身"。很多团队的安全测试做得像个仪式——用例固定、通过标准自定、结果只报喜。有人专门审计这套流程,本身就是进步。
但也要清醒:这仍然是一份"带着镣铐"的协议。评估范围要事先约定、员工谈话要对方指定、证据可以被删节、Slack 进不去。Apollo 能公开说出这些限制,本身就是这份协议最有价值的部分——它给了全行业一个公开的基准:下一次,别的实验室再谈"独立评估"时,至少要先回答,自己给的权限比这份多还是少。
真正的考验在几个月后。Apollo 的两份报告、METR 对最大 RL 训练的结论、Transluce 对安全评估流程的审计,每一份都会告诉我们:模型在没人看的时候,到底在想什么。
参考来源
- OpenAI 官方博客:《Our first phase of embedded assessments》,2026 年 11 月 16 日,https://openai.com/index/our-first-phase-of-embedded-assessments/
- Apollo Research:《A Pilot Towards Embedded Evaluations》,2026 年 11 月 16 日,https://www.apolloresearch.ai/blog/pilot-towards-embedded-evaluations
- TechCrunch:《OpenAI will embed safety researchers to investigate AI subversion》,2026 年 11 月 16 日,https://techcrunch.com/2026/11/16/openai-will-embed-apollo-researchers-to-investigate-ai-subversion/
- 相关阅读:加州起诉 OpenAI:Agent 失控 80 多次,Hugging Face 只是其中一次,https://xiaodu.blog/articles/465