Google DeepMind 在 2026 年 11 月 18 日(东京时间 11 月 19 日凌晨)把 Genie 4 交到了付费用户手里:新版 Project Genie 开始向符合条件的 Google AI Ultra 订阅用户开放,这是 Genie 4 第一次走出受信任测试者的小圈子。注意时间线——Genie 4 模型本身是 10 月 27 日宣布的,当时只给少数测试者;这次的新闻是它正式进产品、普通人能玩到了。
对算法工程师来说,这次开放值得看的不只是"又一个能走路的世界",而是三个第一次同时落地:世界可以边探索边用文字改、声音是模型原生生成的而不是后期配的、Gemini 直接坐在生成环路里当导演。这篇把开放内容、四项关键能力、能用在哪和还不能指望什么说清楚。
这次开放了什么
新版 Project Genie 是一个浏览器里的世界生成器,入口在 Google Labs。Ultra 订阅用户今天起可以在里面选到 Genie 4,Google AI Pro 用户先排队等候。同时上线的还有三样东西:升级过的 Genie 3、一个对话式的 Project Genie agent,和一个可以逛别人世界的社区画廊。
定位上 DeepMind 说得很直白:Genie 4 负责最高保真度的画面、物理和原生音频;Genie 3 留在模型选择器里,适合想要更长单次运行、或者用全景图做种子的场景。两个模型不是替代关系,是分工。
Genie 4 的四个关键能力
官方技术文章把 Genie 4 的升级归纳为四点,每一点都对应一个具体的工程取舍:
第一,实时改世界。 以前生成世界是"开局定好、进去逛";现在可以在探索中途直接打字改——换天气、加一个人、挪镜头、改剧情走向。Gemini 会把你的自然语言指令按当前场景做上下文适配,而不是机械执行。两次输入之间,Gemini 还会持续盯着场景、推动世界连贯地往前走。这意味着"世界"从一段固定生成的视频,变成了一个可以持续对话的模拟器。
第二,人物和物理的真实感。 DeepMind 说这是"最显著的飞跃":人物走路自然、对环境有反应、能被实时指挥;物理上模拟了空气动力学、碰撞等真实场景。演示里的人物不再是贴在场景里的木偶,而是会动、会反应、会说话的角色。对做 Agent 和机器人仿真的人来说,这一点比画面精美更重要——世界模型能不能当训练场,取决于人物和物理可不可信。
第三,原生音频。 Genie 4 是 DeepMind 第一个实时原生生成音频的世界模型:风声、海浪、背景音乐和角色对话,都是和画面一起生成的,不是事后合成。DeepMind 把"人会说话"称为真正的 frontier——角色会根据你的输入和世界里的事件实时对话、做出反应。声音和画面同源生成,意味着音画同步不再是剪辑问题,而是模型内部的一致性问题。
第四,Gemini 在环路里。 这是最值得工程师琢磨的架构点:Gemini Omni 负责把模拟锚定在真实世界的外观和行为上;Gemini 3.8 Flash 在生成环路里当引导 agent——观察场景、把目标拆成步骤、逐帧检查进度、验证每一步是否成功,世界一变就当场调整计划。DeepMind 还在试验 Gemini 4 Argon 和 Genie 4 的组合:Argon 把用户指令拆成步骤、用文字 caption 交错喂给 Genie 渲染,演示里是 Apptronik 的 Apollo 人形机器人下跳棋。这条线通向的目标很明确:用想象出来的世界,给真实机器人和 Agent 做排练场。
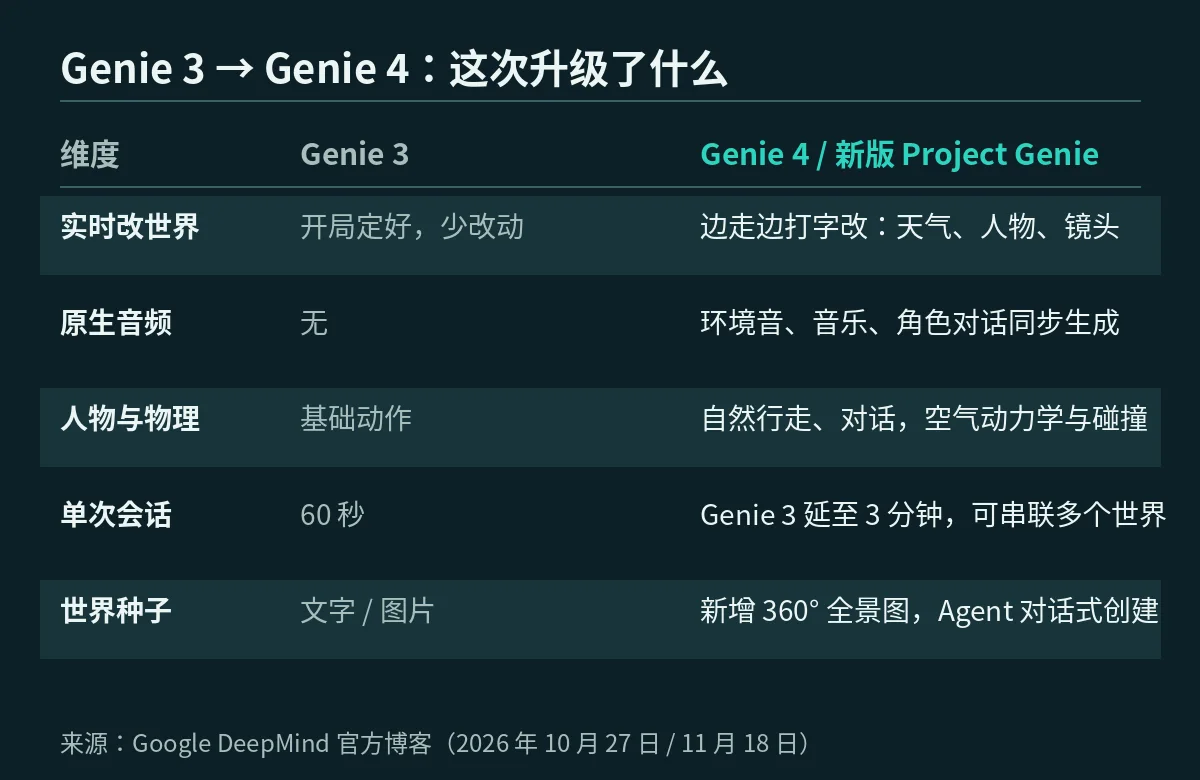
图:Genie 3 与 Genie 4 / 新版 Project Genie 的能力对比。来源:Google DeepMind 官方博客。
Genie 3、Agent 和画廊
Genie 4 是主角,但 Genie 3 的升级对实际使用者可能更实在:单次生成从 60 秒延长到 3 分钟,还能把多个世界串联成更长的旅程;新增 360° 全景图做种子;世界里的事件也可以用自然语言实时触发。对想做长一点体验的人来说,3 分钟加串联比单纯"更真"更管用。
新上线的 Project Genie agent 把创作门槛再往下压了一档:不用先写提示词,直接用自然语言聊你的想法,agent 会调度 Google 的多模态模型套件,先定世界的视觉基调、再配一段贴合氛围的背景音乐。探索过程中 Gemini 还会看着屏幕,给你下一步的建议,或者在合适的时机自动触发世界里的事件。
社区画廊则是这次最"产品化"的部分:可以把个人照片变成可探索的空间(Living Memory)、在 360° 全景图还原的史前栖息地里逛(Dino Field Guide),或者让 Gemini 当裁判玩石头剪刀布。还有和创作者的合作世界,比如哥特庄园解谜 Villa Giallo 和蚂蚁视角的 The Life of Ants。自己做的世界也可以发布到画廊给别人探索和 remix。
谁能用,局限在哪
今天起,符合条件的 Google AI Ultra 订阅用户可以在 Project Genie 里直接试用;Google AI Pro 用户可以在同一页面加入等候名单。Genie 4 之后还会向 Gemini API 和 Google AI Studio 的早期合作伙伴开放,但官方没有给具体日期和价格。安全方面,Project Genie 里生成的所有视频和音频都带 SynthID 水印,所有模型输入输出都会经过安全筛查。
DeepMind 对短板毫不含糊,值得原样转述:世界在短会话里能保持连贯,但细节和物体恒常性还会随时间漂移——会话越长、复杂编辑越多、四处走动越多,漂移越明显。复杂物理交互、实时音频精度、场景里可读的文字、空间准确性、长期一致性,都是正在攻关的方向,相机延迟也在待解决清单里。
翻译成工程师的语言:Genie 4 现在适合做创意预演、概念验证和仿真场景的"零到一"生成,不适合直接交付要长期稳定、可复现的结果。官方列出的测试者用法也印证了这点:电影人拿它做实时多机位预演、摄影记者拿一张老照片还原历史空间、游戏开发者几秒钟出一个可探索的原型、企业合作伙伴快速生成仿真场景找缺口。
小杜点评
世界模型这一年有个明显的分水岭:上半场比的是"画面像不像真的",下半场比的是"世界听不听话、记得住、说不说得通"。Genie 4 的四项升级里,最有分量的是第四项——Gemini 坐进生成环路当导演。没有这一环,实时改世界和原生音频都只是效果演示;有了它,世界模型才开始像一个可以编程的模拟器,而不是一段更长的生成视频。
但也要泼一盆冷水:官方自己承认的漂移问题,恰恰是"模拟器"和"玩具"的分界线。物体恒常性撑不住长会话,机器人排练场和 Agent 训练环境就还只能停留在演示阶段。Genie 3 延长到 3 分钟、可以串联世界,说明 DeepMind 也在用产品手段绕过这个短板。
对算法工程师来说,值得动手的有两件事:第一,去 Project Genie 里亲自测一下"边改边走"的延迟和一致性,看看提示词在第几次编辑后开始失控;第二,盯着 Gemini 4 Argon + Genie 4 这条线——如果世界模型真能稳定地给机器人拆解任务、逐步渲染,那它的价值就不在内容创作,而在机器人和 Agent 的仿真基础设施。这篇的结论要等 API 开放后才能验证,在那之前,先把它当成一个很有诚意的预览版。
参考来源
- Google DeepMind 官方博客《Genie 4 is now available》,2026 年 11 月 18 日:https://deepmind.google/blog/genie-4-is-now-available/
- Google DeepMind 官方博客《Genie 4: A new generation of world simulation》,2026 年 10 月 27 日:https://deepmind.google/blog/genie-4-a-new-generation-of-world-simulation/
- Unite.AI《Google Brings Genie 4 to Project Genie for Eligible AI Ultra Users》,2026 年 11 月 18 日:https://www.unite.ai/google-brings-genie-4-to-project-genie-for-eligible-ai-ultra-users/