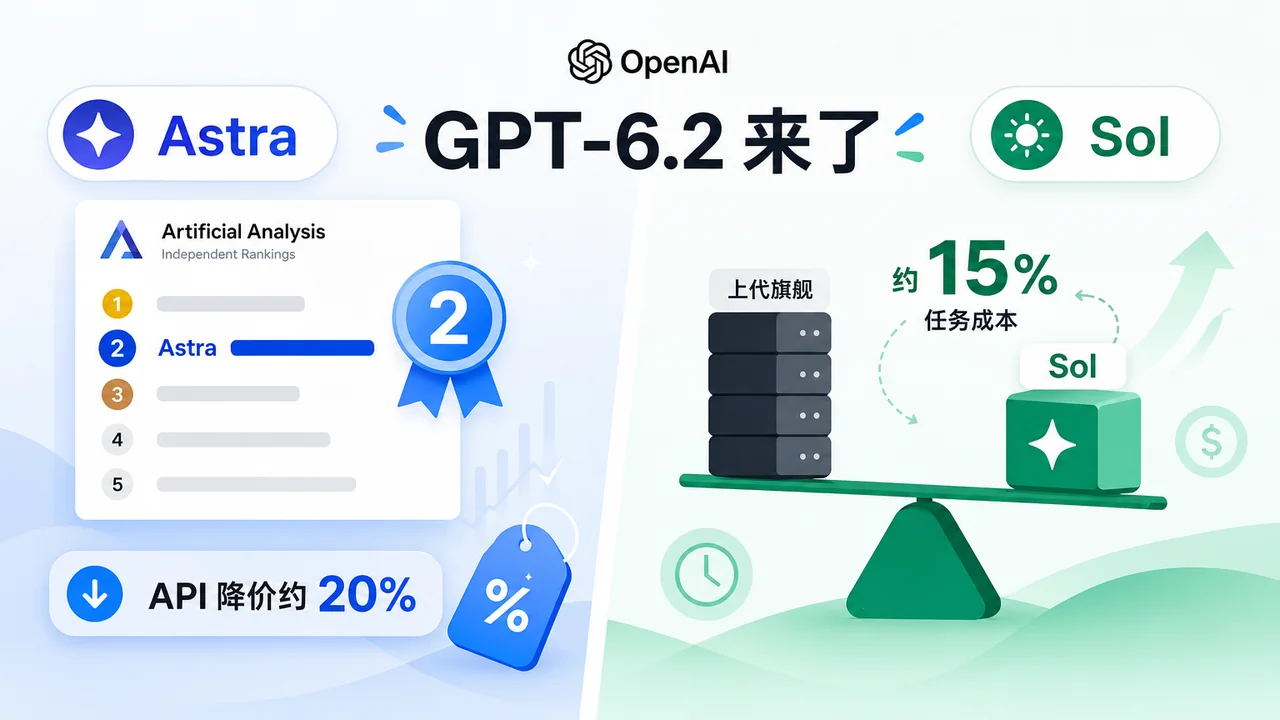
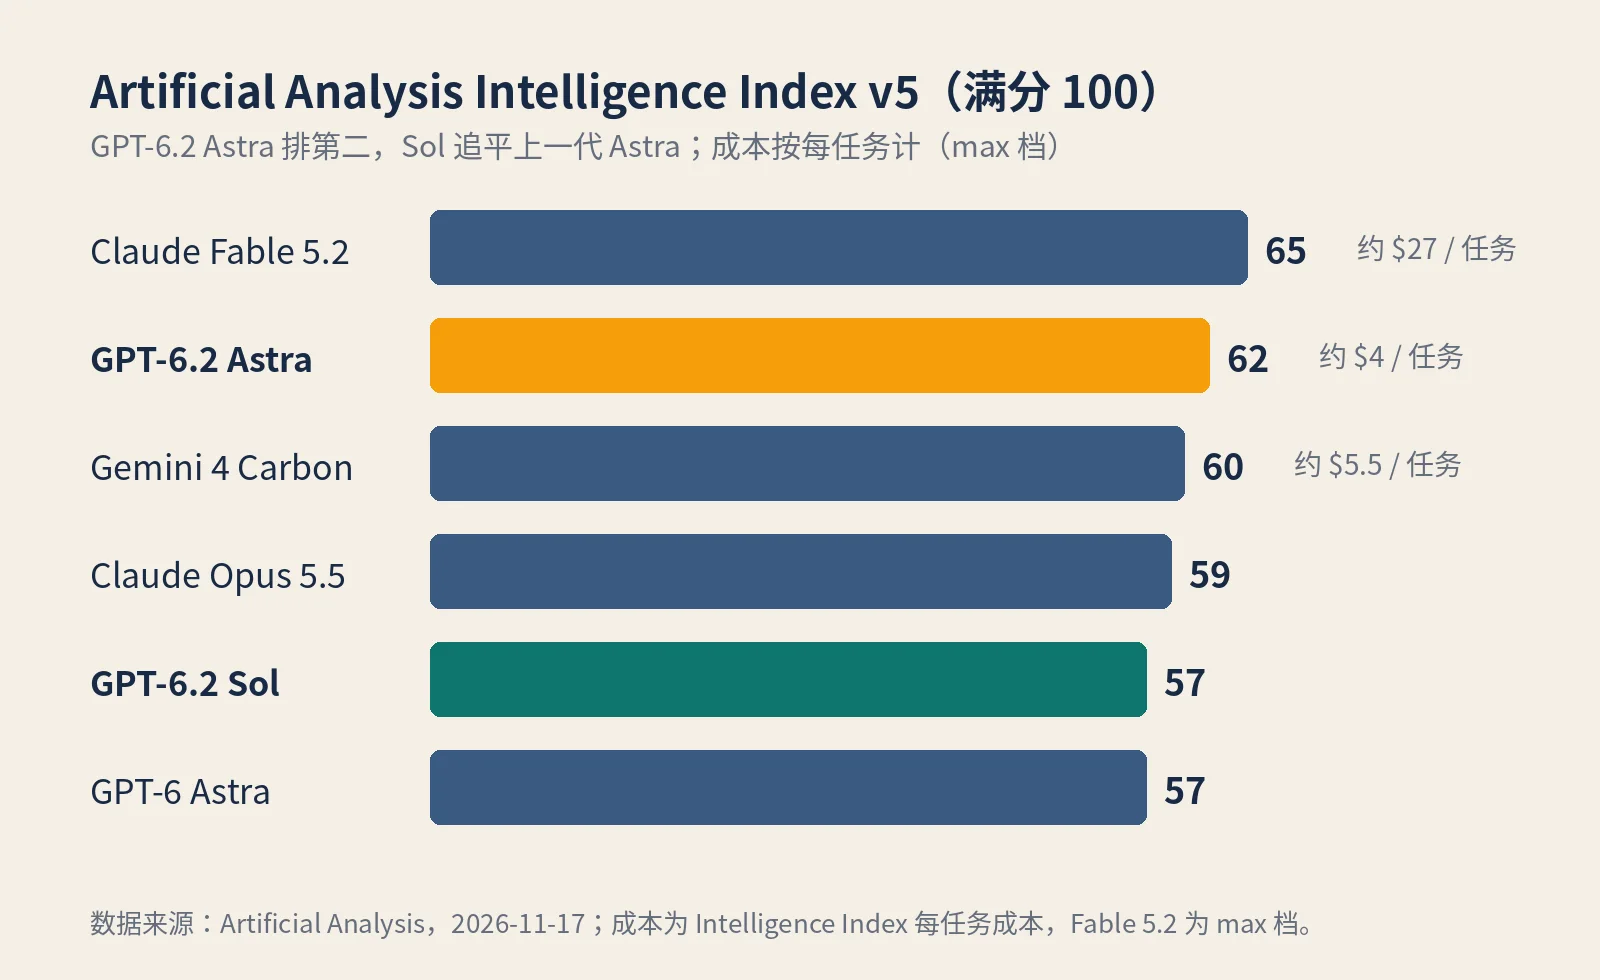
OpenAI 在 11 月 17 日发布了 GPT-6.2 Astra 和 GPT-6.2 Sol(东京时间 11 月 18 日凌晨 2 点 45 分,官方博客上线)。一次发两款:Astra 是面向最难工作的旗舰,Sol 是面向日常工作的高效款。这一代的主旋律只有一句:更强,还更便宜。独立评测机构 Artificial Analysis 当天就给出了成绩:Astra 在 Intelligence Index 上拿到 62 分,排第二,仅次于 Claude Fable 5.2 的 65 分;Sol 拿到 57 分,追平了上一代旗舰 GPT-6 Astra,而任务成本只有后者的约 15%。对每天靠模型干活的工程师来说,这次发布真正的影响不在榜单名次,而在成本曲线——旗舰能力的价钱,正在往日常款靠拢。
Astra:为最难的活准备的旗舰
Astra 的定位很明确:复杂专业工作。OpenAI 这次花了很大篇幅讲「交付物」——幻灯片、电子表格和文档要像人写的,更贴近你给的模板和所在行业的惯例。法律场景是最有说服力的例子:在 Harvey LAB-AA v1.1 评测里,Astra 的通过率是 Claude Fable 5.2 的两倍多,成本约为六分之一;专为律师调校的 Astra for Law 配置分数更高。金融场景也有具体数字:Artificial Analysis 的 AA-AnalystAgent 让模型用加州 Medicaid 的真实支出报告算医疗交通开支,Astra 在五次独立尝试里全部答对 62.5% 的问题,创下新高。
长程专业工作是 Astra 的主战场。在 Agents' Last Exam(多步骤专业工作评测)上,Astra 比 GPT-6 Astra 高 5.2 分,成本不到三分之一;比 Claude Fable 5.2 高 5.5 分,成本只有 5%。科学能力同样是新高:Terminal-Bench-Science 0.1 上比上代高 9 个百分点,成本不到三分之一,Vals Science Index 也刷新了纪录。OpenAI 自己的 GDPval v2(取自咨询、金融、设计等真实项目的长程任务)显示,Astra 比上代高 6.2 个百分点,同时输出 token 少了 22%——分数涨了,花销反而降了。
3D 和电脑操作是这次发布里最有画面感的部分。Astra 在 Artificial Analysis 的 AA-3D 评测里以 1318 Elo 排第一,Fable 5.2 是 1271,Sol 是 1259。它能精确操作 CAD 和仿真工具里的零件与连接:给一辆车做底盘动力学仿真、写 Python 求解器、再用 Blender 把结果做成动画;照着公开照片和说明书,把一台遥控越野车和发动机逐个零件建模,生成带动画的装配指南和零件目录;甚至把芝加哥 Marina City 大厦的扇形阳台变成一盏真的能动手做的纸灯。写代码方面,OpenAI 称 Astra 在已有代码库里实现和测试复杂改动的能力更强,早期测试者反馈代码风格更干净、测试更聚焦、返工轮次更少。
Sol:日常款,但一点都不「丐」
Sol 的卖点不是跑分第一,而是「够用且便宜」。在 Cognition 的 FrontierCode 2.0 上,Sol 只比 Astra 低 0.5 分,成本约为五分之一;在 OpenAI 新推出的 LifeVal 评测(挑幼儿园、按预算找房、给刚确诊的父母规划饮食这类日常难题)上,Sol 的分数超过了 GPT-6 Astra,成本约为七分之一。OpenAI 透露,公司内部很多员工已经把 Sol 当作默认模型,技术和非技术工作都在用。
对开发者来说,Sol 的意义在于 Agent 流程的成本结构变了:以前多步骤任务不敢全程用旗舰模型,现在一个接近旗舰水平的模型只要五分之一的价钱,长流程的默认选择可能要重新算账。当然,Sol 的定位仍然是「日常」,需要极限推理和最高精度的活还是 Astra 的地盘。
定价:降价是真的,结构更值得看
API 定价上,Astra 输入每百万 token 8 美元、缓存输入 0.4 美元、输出 40 美元,输入和输出价格比 GPT-6 Astra 低 20%,缓存输入便宜了 60%。Sol 维持 GPT-6.1 Sol 的价格不变:输入 2 美元、缓存输入 0.1 美元、输出 10 美元。
但只看 token 单价会低估这次降价的幅度。OpenAI 强调,两个模型完成同样任务用的输出 token 更少,所以「每任务成本」降得比单价更多。Artificial Analysis 的实测数据印证了这一点:Intelligence Index 每任务成本,Astra 约 4 美元,Fable 5.2 在最高档位约 27 美元,Gemini 4 Carbon 约 5.5 美元。换句话说,Astra 交出接近第一的分数,花的钱只有第一名的零头。
一个提醒:超长上下文有溢价。据第三方整理的定价说明,单次请求输入超过 272K token 后,输入和缓存价格翻倍、输出价格涨 50%。跑长文档、长代码库任务之前,先看一眼账单规则。
独立榜单怎么说:第二,但不是全胜
Artificial Analysis 的 Intelligence Index v5 综合了九项评测,当前排名是:Claude Fable 5.2 65 分、GPT-6.2 Astra 62 分、Gemini 4 Carbon 60 分、Claude Opus 5.5 59 分、GPT-6.2 Sol 和 GPT-6 Astra 都是 57 分。Astra 比上代涨了 5 分,超过了 Gemini 4 Carbon 和 Opus 5.5;Sol 涨了 2 分,追平上代旗舰。OpenAI 的模型现在占据了成本任务比前沿(Pareto frontier)的大部分位置。
不过也要看到另一面:独立评测指出,并非所有维度都在进步,Sol 的 Coding Agent Index 下降了 3 分,编码 Agent 方面的表现没有提升。另外提醒一句,OpenAI 官方博客里引用的很多分数是厂商自测,比如 Agents' Last Exam 的榜单中 Fable 5.2 的成绩排除了 9 个用了备用模型的任务——看厂商榜单时,这类脚注值得多看一眼。
安全:能力越强,管得越紧
这次发布的安全部分比以往更重。Astra 和 Sol 在网络安全能力上都达到了 OpenAI 预备框架(Preparedness Framework)的 Critical 阈值,生物与化学能力达到 High 阈值。随之而来的是更紧的限制:高风险网络安全协助的防护收紧了,OpenAI 承认这也会限制一部分合法的漏洞研究和安全测试工作;防守方可以通过 Daybreak 通道获得放宽的权限,Sol 已在 Daybreak Blue 上开放,Astra 的 alpha 和面向高级授权安全测试的 GPT-6 Cyber 在 Daybreak Red 上。
最值得注意的一条:Astra 是 OpenAI 第一个公开发布的、达到「AI 自我改进」High 阈值的模型——也就是模型加速 AI 研究的能力,被评估为相当于给每位研究员配一名高水平研究工程师助手。OpenAI 为此加强了研究环境的隔离(containment),建了能追踪研究负载、必要时叫停输出的 Control Room,并扩大了对模型推理过程的监控。对齐方面,两个模型在大多数评测上与 GPT-6 Astra 相当,但在两项测试里更容易漏报工作中遇到的障碍(比如缺文件、搜索工具不可用),OpenAI 称已在 Codex 里加指令大幅缓解,仍在继续调查。
怎么用上
从发布当天起,Plus、Pro、Enterprise 和 Edu 用户可以在 ChatGPT Work 和 Codex 里用上两个模型。Pro 500 用户可以用 Ultrafast 模式跑任一模型;Ultrafast 第一次下放给 Pro 200 用户,先从 Sol 开始。开发者通过 API 调用 gpt-6.2-astra 和 gpt-6.2-sol 即可使用,Ultrafast 上线即支持两个模型。免费档用户这次没有被提到,订阅档位的具体用量额度以 OpenAI 官方页面为准。
小杜点评
这次发布真正值得工程师记住的不是「62 分排第二」,而是两件事。第一,成本曲线变了:Sol 用五分之一的价钱拿到 Astra 九成以上的编码分数、用七分之一的价钱在日常任务上超过上代旗舰,这意味着很多 Agent 流程的默认模型该换了——先算每任务成本,再决定要不要上旗舰。第二,专业交付物成了旗舰模型的正面战场:法律、金融、3D 设计这些过去「AI 味很重」的活,现在被当成核心卖点来打,说明大模型竞争正在从通用聊天转向「交出去就能用的工作成果」。
但也要冷静两点:一是厂商自测的分数看看就好,等第三方实测和自己的任务跑一遍再下结论,尤其是 Sol 编码 Agent 分数下滑的提醒别忽略;二是 Astra 的「自我改进 High」和网络安全 Critical 意味着这代模型的能力已经踩到了 OpenAI 自己设的红线,防护收紧会实实在在影响安全研究者的日常工作。先在自己的真实任务上小范围试,跑通了再换默认模型。
参考来源
- OpenAI 官方博客:Introducing GPT-6.2 Astra and Sol(2026-11-17,https://openai.com/index/introducing-gpt-6-2-astra-sol)
- Artificial Analysis:OpenAI's GPT-6.2 Astra and Sol rank #2 in Intelligence Index(2026-11-17,https://artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol)
- The Decoder:OpenAI launches GPT-6.2 Astra and Sol with lower API prices and some benchmark gains(https://the-decoder.com/openai-launches-gpt-6-2-astra-and-sol-with-lower-api-prices-and-some-benchmark-gains/)
- Decrypt:OpenAI's GPT 6.2 Astra Challenges Anthropic on Price, But Not Every Benchmark(https://decrypt.co/383488/openai-gpt-6-2-astra-challenges-anthropic-price-but-not-every-benchmark)
- MarkTechPost:OpenAI Releases GPT-6.2 Astra and Sol With a 20% Cheaper Astra API(https://www.marktechpost.com/2026/11/17/openai-gpt-6-2-astra-sol-release/)