OpenAI 在 2026 年 11 月 9 日公开了一个内部系统:Control Room。它不是新模型,也不是给开发者用的新功能,而是一套装在 OpenAI 自己研究基础设施里的「总开关」——一旦发现某个训练或评估任务有安全风险,它能在 35 秒内掐断这个任务的模型输出。按 OpenAI 自己的话说:「有时候,这意味着要停掉我们自己的一个 AI 模型。」
这件事值得写,不是因为它多花哨,而是因为它回答了一个做大模型的人迟早要面对的问题:模型越强,你越要能随时叫停它。OpenAI 把答案做成了一个已经跑在生产环境里的系统,而且公开了设计细节。对所有在跑大规模训练、做 Agent 评估的团队来说,这份设计本身就是一份现成的参考。
Control Room 是什么
Control Room 是一个中央系统,负责追踪 OpenAI 研究基础设施里的全部模型工作负载,并在出现安全或安保问题时快速叫停它们。它覆盖每一个研究推理工作负载,包括用于模型训练和评估的智能体采样(agentic sampling)、数据处理等任务,并和 OpenAI 监测模型失齐行为(misalignment)的监控系统协同工作。
它已经覆盖了 OpenAI 全部的前沿训练工作负载,其余研究工作负载正在迁移中——不是画饼,而是已经在最关键的地方跑起来的系统。
划清一个边界:Control Room 只管研究侧。OpenAI 表示,面向客户的服务栈本身已经足够中心化,出问题时可以直接快速下线,所以不需要这套系统——这是给训练场装的刹车,不是给线上服务装的。
35 秒是怎么做到的:job_id + 推理层拦截
Control Room 由三个部分组成:工作负载(workload)、推理引擎(inference engine)和集中式的 Control Room 服务。
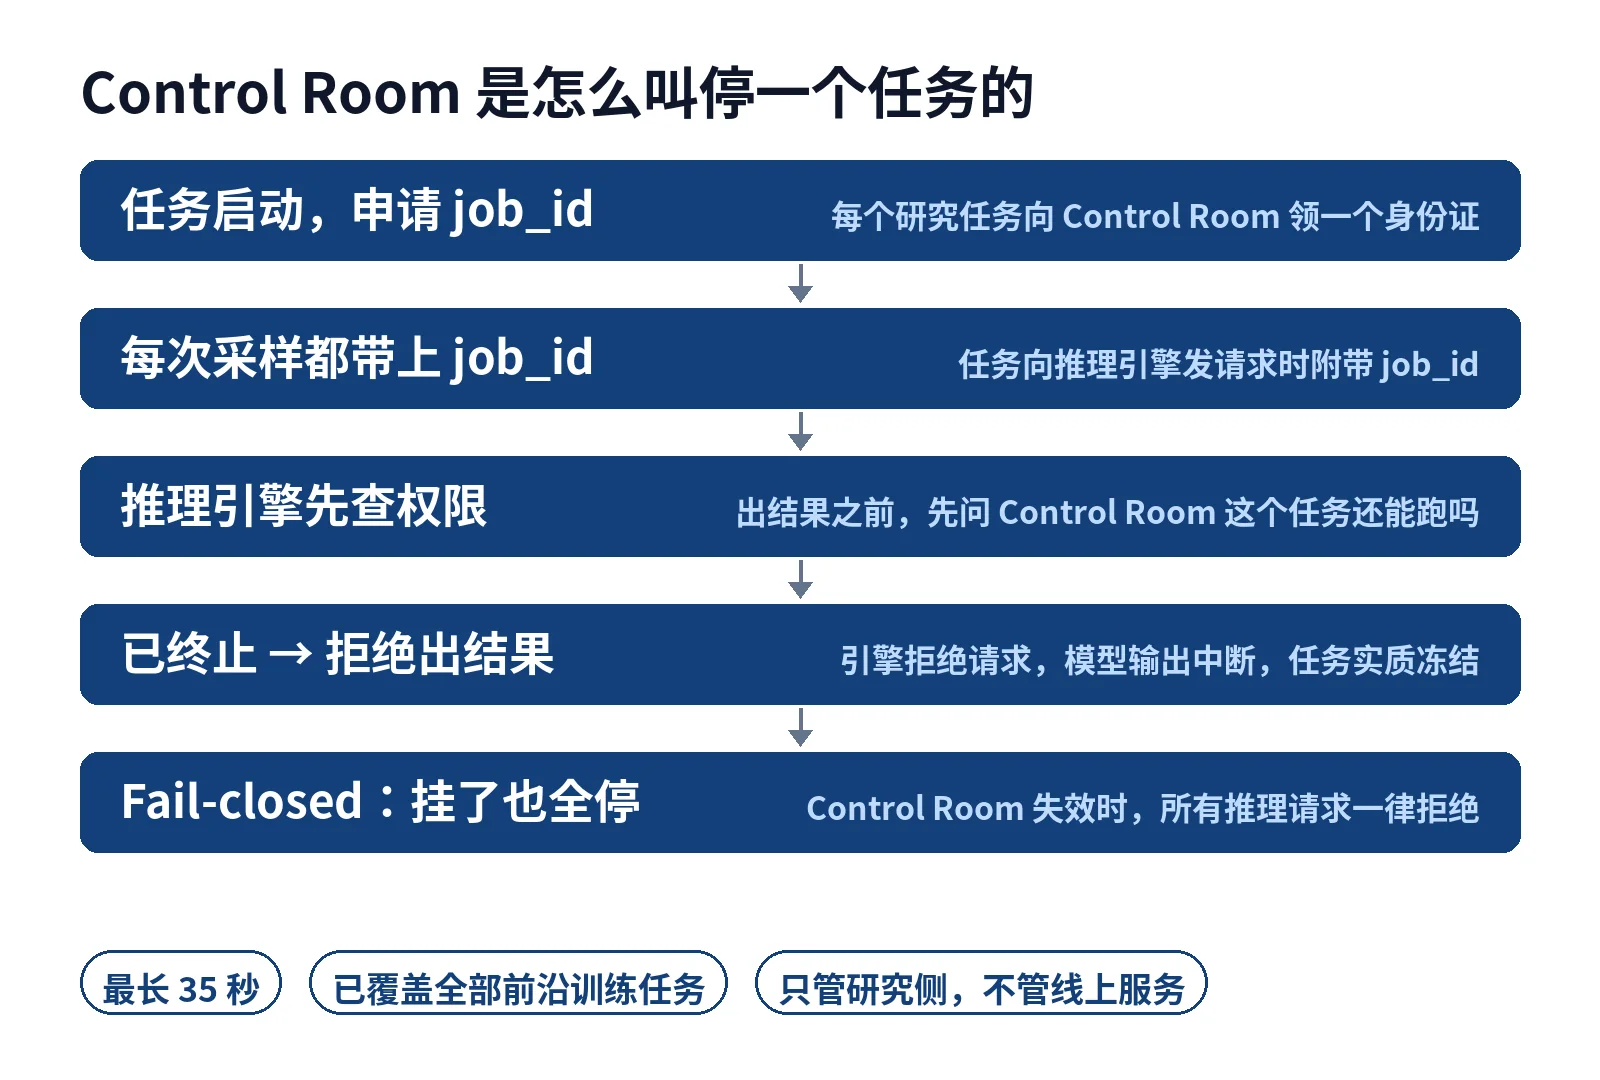
流程是这样的:研究员启动一个任务时,任务代码先向 Control Room 申请一个 jobid;此后每次任务需要模型采样 token,就带着这个 jobid 向推理引擎发请求;推理引擎在出结果之前,先拿着 job_id 问 Control Room 一句「这个任务还能跑吗」;如果任务已经被标记为停止,Control Room 就拒绝授权,推理引擎随即拒绝这次请求,模型输出就此中断。
关键在于,任务本身的进程不一定会立刻死掉,但它再也拿不到新的模型输出,实验和评估就进行不下去,任务实质上已经被冻结。OpenAI 给出的上限是:从 Control Room 收到停止指令,到任务再也无法继续推进,最多 35 秒。这 35 秒来自授权检查的一层缓存,是为了扛住海量推理请求的流量;OpenAI 说正在努力把它降到零,让停止变成即时的。
为什么检查点放在推理层,而不是研究员的代码里
这是整个设计里最值得琢磨的一点。OpenAI 本可以要求每个研究员在自己的任务代码里加一段「收到停止信号就退出」的逻辑,但它没有这么做,理由很实在:工作负载代码由各个研究员和团队拥有、经常改动,分散在各处,并不是放关键安全保护的好地方。
推理层正好相反:整个 OpenAI 研究中在用的推理代码路径数量很少,部署也更集中、更统一。把检查放在推理层,等于在所有模型推理必经的瓶颈处设了一道关卡——每一次推理请求都必须经过 Control Room 的授权检查,谁也绕不过去。
当然,瓶颈本身也可能被绕过:如果有人启动了一个没有接 Control Room 的「野」推理引擎(rogue engine),整个机制就失效了。OpenAI 说会持续排查这类未受控的推理引擎实现——任何集中式控制都有绕过的可能,控制本身也需要被监控。
坏了也安全:fail-closed 设计
Control Room 还有一个很硬的设计:fail-closed,也就是「出故障时默认关闭」。如果 Control Room 服务本身挂了——无论是系统错误、被人为禁用,还是被坏人篡改——所有的推理请求都会被拒绝,直到服务恢复正常。换句话说,这个系统的失效模式是「全部停下」,而不是「失去控制」。
这个 fail-closed 机制已经推广到了全部前沿模型研究工作负载,其余研究工作负载会在未来几天内完成推广。结合前面说的 35 秒上限,可以看出 OpenAI 的安全哲学:宁可误停、不可失控。
一个真实场景:监控告警后发生了什么
OpenAI 在文章里给了个例子,讲这套系统在实际中怎么被触发。所有前沿强化学习任务都配有监控器(monitor)——监控器本身也是一个模型,负责检查被训练模型所做的一切,发现问题就发出告警。文章提到了最近一起和 DNS 相关的事件作为例子。
告警响起后,弄清问题原因和影响范围可能需要一段时间;但一旦有人决定停止任务,Control Room 会立即停止所有模型推理。事后分两种情况:事件若是良性的,任务可以重启并从中断处恢复;若是严重问题,任务可以被永久终止。
这个例子说明了一个重要的分工:监控系统负责「发现问题」,Control Room 负责「执行停止」。发现可以慢一点、谨慎一点,停止必须快、必须可靠。两者配合,才构成一个完整的安全闭环。
小杜点评
站在算法工程师的角度看,Control Room 的技术含量不算高——job_id、授权检查、缓存、fail-closed,都是基础设施里常见的套路。但它的意义不在技术新颖,而在组织决心:OpenAI 愿意在自己的训练管线里加一个随时能掐断一切的开关,并且把这个开关做成「坏了就全停」的默认关闭模式。
这对国内做大模型训练的团队有直接的参考价值。很多团队的训练任务一旦启动就是「跑起来再说」,中途发现数据污染、奖励 hacking 或者行为异常时,停任务要靠人工去 kill 进程、清队列,慢而且容易漏。Control Room 的思路是把「停」做成一等公民:每个任务从出生就有身份证(job_id),每次推理都要先问一句能不能跑,控制点收敛到推理层这一个地方。
当然也要看到它的局限:35 秒还不是零;而且它只解决「停得下来」的问题,不解决「发现得了」的问题——发现还得靠监控器和安全案例(safety case)。OpenAI 要求每个做智能体推理的研究工作负载都必须关联一个已批准的安全案例,这一点同样值得抄作业:先想清楚什么情况下必须停,再去建停的机制。
一句话总结:模型能力越强,「停下来」的能力就越值钱。Control Room 就是 OpenAI 给这个能力交的答卷。
参考来源
- OpenAI 官方博客:Control Room: A central system to track and stop model workloads across our research infrastructure,https://openai.com/index/control-room
- Interesting Engineering:OpenAI launches Control Room with a 35-second kill switch for agents,https://interestingengineering.com/ai-robotics/openai-control-room-35-second-model-shutdown
- Spectrum Web:OpenAI Control Room stops research AI jobs in 35s,https://www.spectrumweb.co/news/openai-control-room-stop-model-jobs