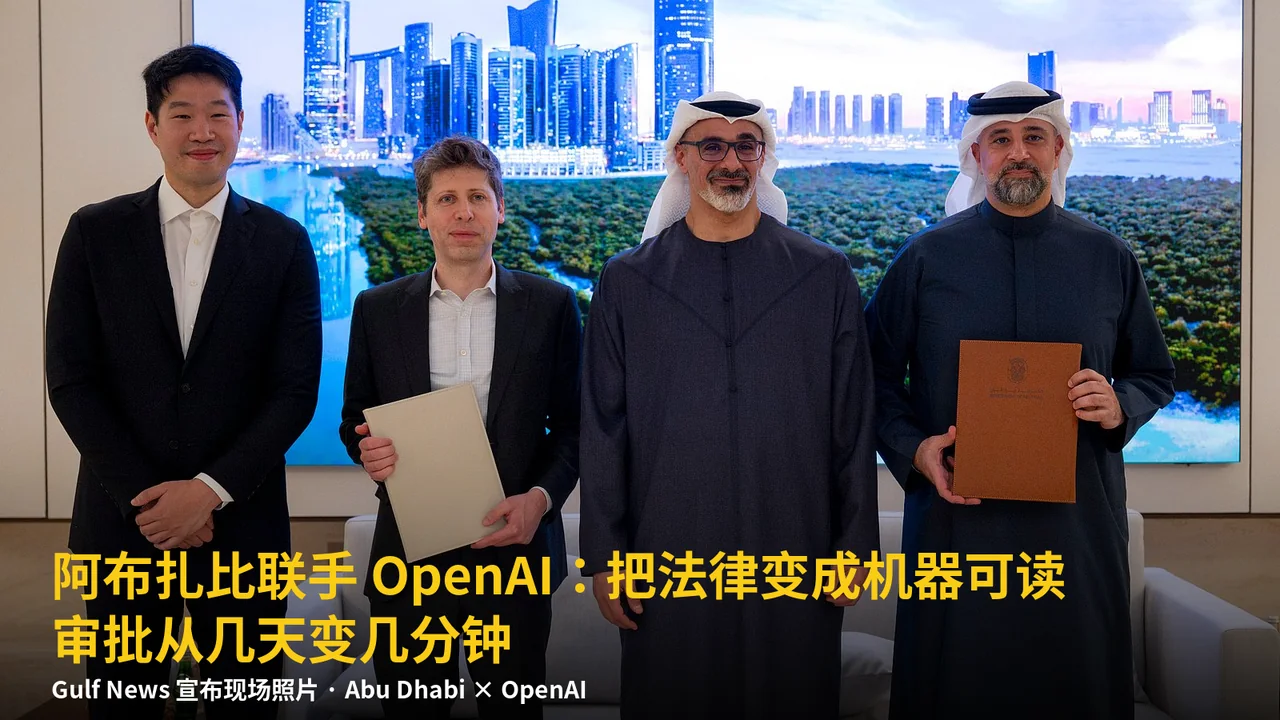
阿布扎比和 OpenAI 在 2026 年 11 月 9 日宣布推出“机器可读政府”(Machine-Readable Government,简称 MRG),要把政府的法律、政策和规章变成机器能直接读、能直接用的格式,让 AI 系统来做常规申请和合规检查。按官方的说法,这类原本要几天人工审核的事,以后最快几分钟就能出结果。阿布扎比也因此成了第一个把一整套法律和政策按 AI 来优化的政府,目标是在 2027 年成为全球第一个“AI 原生政府”。
这件事值得算法工程师留意,不是因为它又多了一个聊天机器人入口,而是因为它动的是最底层的那一环:规则本身。平时我们做 Agent、做自动化,卡住的地方往往不是模型不够聪明,而是规则藏在 PDF、Word 和人的经验里,机器读不懂、也对不齐。MRG 的思路是先把规则变成机器可读,再让模型去执行,执行结果还能一路追溯到具体条款。这条路如果跑通,政务会是第一个大规模落地的场景,但同样的模式完全可以搬到金融合规、采购、HR 这些规则密集的地方。
一、不是给流程加 AI,是把政策本身变成数据
阿布扎比政府赋能部(DGE)主席 Ahmed Tamim Hisham Al Kuttab 把话说得很直白:只给旧流程套一层 AI,走不了多远,更难的事是“让政策本身变智能”。MRG 就是冲着这句来的。
具体做法是:不改写立法本身,而是改变现有规则被应用的方式。书面政策先被转成 AI 能处理的格式,申请交上来以后,系统对照相关规则做检查,再给出一个和具体条款挂钩的结果。常规案件可以全天候自动处理,复杂申请则交给官员,官员定标准、审复杂案子,并对最终决定负责。
这里有个边界划得很清楚:MRG 不打算在高风险领域做自主决策,也不适用于那些会实质影响个人权利、资格或基本服务的场景。换句话说,它先吃的是量大、规则明确、风险可控的那部分,而不是一上来就碰最难的裁量。
二、审批怎么变:每条结论都能追到具体条款
对工程师来说,MRG 里最有含金量的设计是可追溯。每次评估都要链到得出结论的那条法规或条款,形成一条审计链,官员可以反查系统是怎么得出这个判断的。
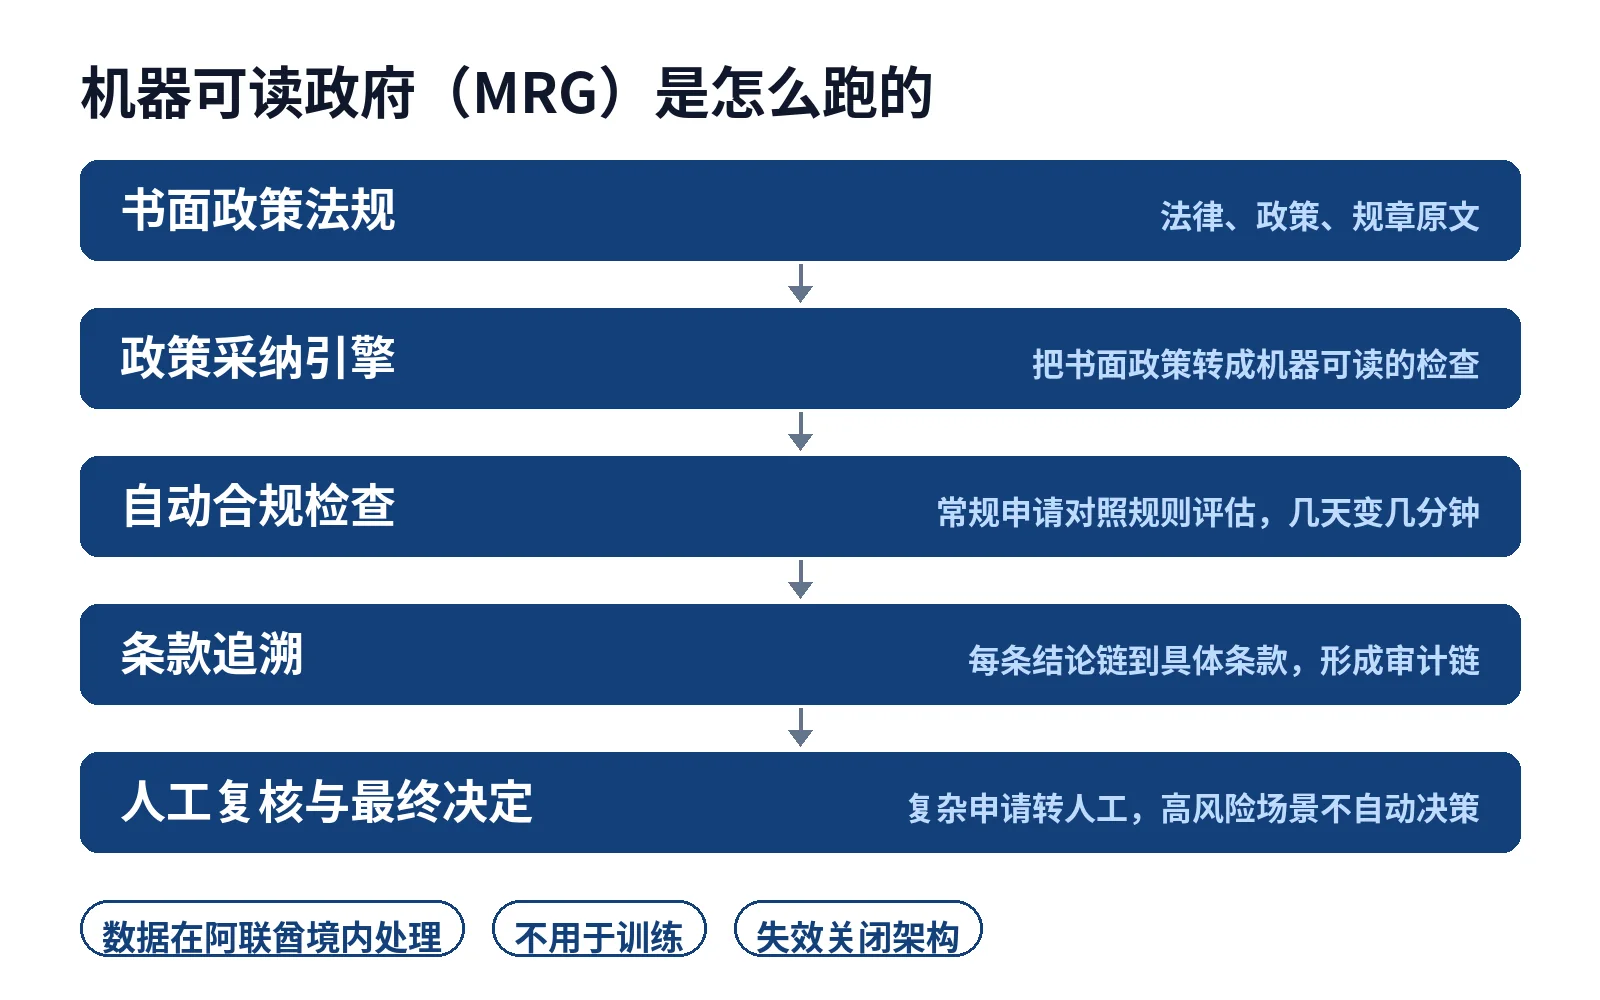
第一个已经投产的应用在阿布扎比农业与食品安全局(ADAFSA),做的是食品进口。试点由 G42 旗下的 Inception 合作开发,里面有个叫“政策采纳引擎”(Policy Adoption Engine)的东西,负责把书面政策转成自动合规检查。每一条输出都能追到产生它的那条规则,官员复核的时候不是只看一个“通过 / 不通过”,而是能看到依据。
这套做法还带来一个副产品:规则之间能不能对得上,终于可以被机器发现了。把不同部门的政策放到同一个机器可读格式里,就能看到哪里重叠、哪里冲突;新政策出台之前,还可以先拿它去对照相关法规跑一遍,看看会不会打架。目标是让监管更简单、更一致,而不是在原有立法之外再叠一层。
阿布扎比计划把这套框架扩展到更多服务,接下来提到的方向包括建筑许可、商业和自由职业执照、数据访问治理、人力资源合规和采购。这些都是规则多、流程长、人工审核压力大的地方,也是最容易先看到“几天变几分钟”的地方。
三、数据不出境、不训练:主权推理是关键设计
这次发布里另一个不能忽略的部分是部署方式。AI 处理在阿联酋本国的国家基础设施内完成,OpenAI 的阿联酋推理驻留(UAE inference residency)意味着实时模型计算跑在位于阿联酋数据中心的 GPU 上。系统采用“失效关闭”(fail-closed)的安全架构,受阿联酋网络安全标准管辖,并适用阿布扎比法律。
数据归属也写得很明确:政府保留通过该系统产生的数据的全部所有权,这些数据不会被用来训练 AI 模型,数据的存储、使用和删除都有约定的保障措施来约束。按官方说法,阿联酋也因此成了中东第一个通过本国推理基础设施使用 OpenAI GPT 模型的国家。
对做 to B、to G 的工程师来说,这几条的实际分量可能比“审批变快”更大。模型能力可以采购,但数据主权、审计链和失效模式才是能不能进政府、金融这些场景的门票。MRG 把“人在回路”“可追溯”“数据不出境、不训练”写进架构里,而不是当成事后补的合规说明,这一点值得抄作业。
MRG 是阿布扎比 2025–2027 年政府数字化战略的支柱之一,这个战略的总规模是 130 亿迪拉姆,约合 35 亿美元。框架会接入 TAMM,也就是阿布扎比统一的政府服务应用,里面汇集了 1,200 多项公共和私人服务。官方还提到,AI 应用场景已经覆盖 40 个政府实体,阿布扎比政府全体公务员都接受过 AI 培训,MRG 要做的是给这些系统提供底层的政策基础设施,让法规和流程能被 AI 应用直接调用。
四、真正难的在后面:规则翻译得准不准
把政策变成机器可读,听起来像一次格式转换,实际上是整个系统里最难的一步。自然语言的法规里有例外、有兜底、有“视情况而定”,翻成机器能执行的检查时,任何一个理解偏差都会变成系统性的误判。Policy Adoption Engine 这类工具的成败,不在它能跑多快,而在它翻译规则时丢了多少、错了多少,以及出错之后能不能被发现、被纠正。
版本管理是第二个坑。法规会改,政策会更新,机器可读的版本和原文之间必须严格同步,改了一处就要知道影响了哪些检查、哪些历史结论要不要重算。MRG 强调每条结果都能追到条款,这在出问题时是救命的设计:至少你能定位到是哪条规则、哪个版本出了问题,而不是面对一个黑盒结论无从下手。
第三个是边界的执行。官方说复杂申请留给人、高风险场景不做自主决策,这条线在纸面上好划,在系统里需要一整套分流和兜底机制:什么时候该转人工、转人工之后机器的结论还算不算数、人工改判了要不要回流到规则里。这些细节官方这次没有展开,也是接下来最值得盯的部分。
小杜点评
站在算法工程师的角度,MRG 最值得看的不是“审批变快”这个结果,而是它把三件事排了个正确的优先级:先让规则机器可读,再谈自动化;先保证每条结论可追溯,再谈规模化;先把数据主权和失效模式定下来,再谈模型能力。这正是很多 Agent 项目翻车的地方——模型接进去了,规则还在人脑里,出了问题既说不清、也改不动。
如果要借鉴这套思路,我建议别从“做一个政务助手”开始,而是从最小的规则闭环开始:挑一个规则明确、量大、出错成本可控的场景,把规则写成机器可读的检查清单,每条结论强制带上条款引用,再配一个人工复核和规则版本管理的回路。跑通这一个闭环,比同时上十个对话入口有用得多。
当然也要泼一盆冷水:这次发布没有给出准确率、误判率、人工复核比例这些关键数字,首个试点也只覆盖食品进口这一个场景。MRG 能不能从“一个跑通的试点”变成“覆盖全政府的底座”,要看它在建筑许可、执照、采购这些更复杂的场景里,规则翻译和版本管理的坑能不能一个个填上。先当作一个设计正确的方向来跟踪,别当成已经验证过的结论。