东京时间 11 月 7 日 03:01(AWS Machine Learning Blog 标注 2026-11-06 18:01 UTC),Amazon 宣布 SageMaker Inference 支持基于 NVIDIA MIG 的 GPU 分区。过去在 GPU 端点上,最小申请单位通常是「整张加速卡」——小模型占不满、多模型又难隔离。这次把硬件级分区接到托管推理上,主要面向已经在用 Inference Components 的多模型端点:布局写进 EndpointConfig,分区类型写进组件资源需求,调用接口本身不变。
解决什么问题:整卡粒度的两头尴尬
官方开篇把痛点说得很直白:部署到 GPU 端点时,能申请的最小 GPU 单位是一张整卡。后果有两层。一是实例上的模型数很难超过加速卡数——例如 ml.p4d.24xlarge 有 8 张 A100,就大致只能放 8 个模型,哪怕每个只要十几 GB。二是扩容变成「整卡跳档」:老一代整卡不够用时,新一代整卡又往往过剩,容易要么服务能力不够,要么为用不到的算力买单。
团队此前常见三条路:少开端点、把流量硬塞进多模型端点(软件共享、缺隔离)、或自己上 Kubernetes 管 MIG。第三种能拿到硬件分区,但要把驱动、分区配置、device plugin 和调度一起扛起来。SageMaker 这次做的,是把「选分区配置」留在托管端点里。
怎么用:两个可选字段,没有新 API
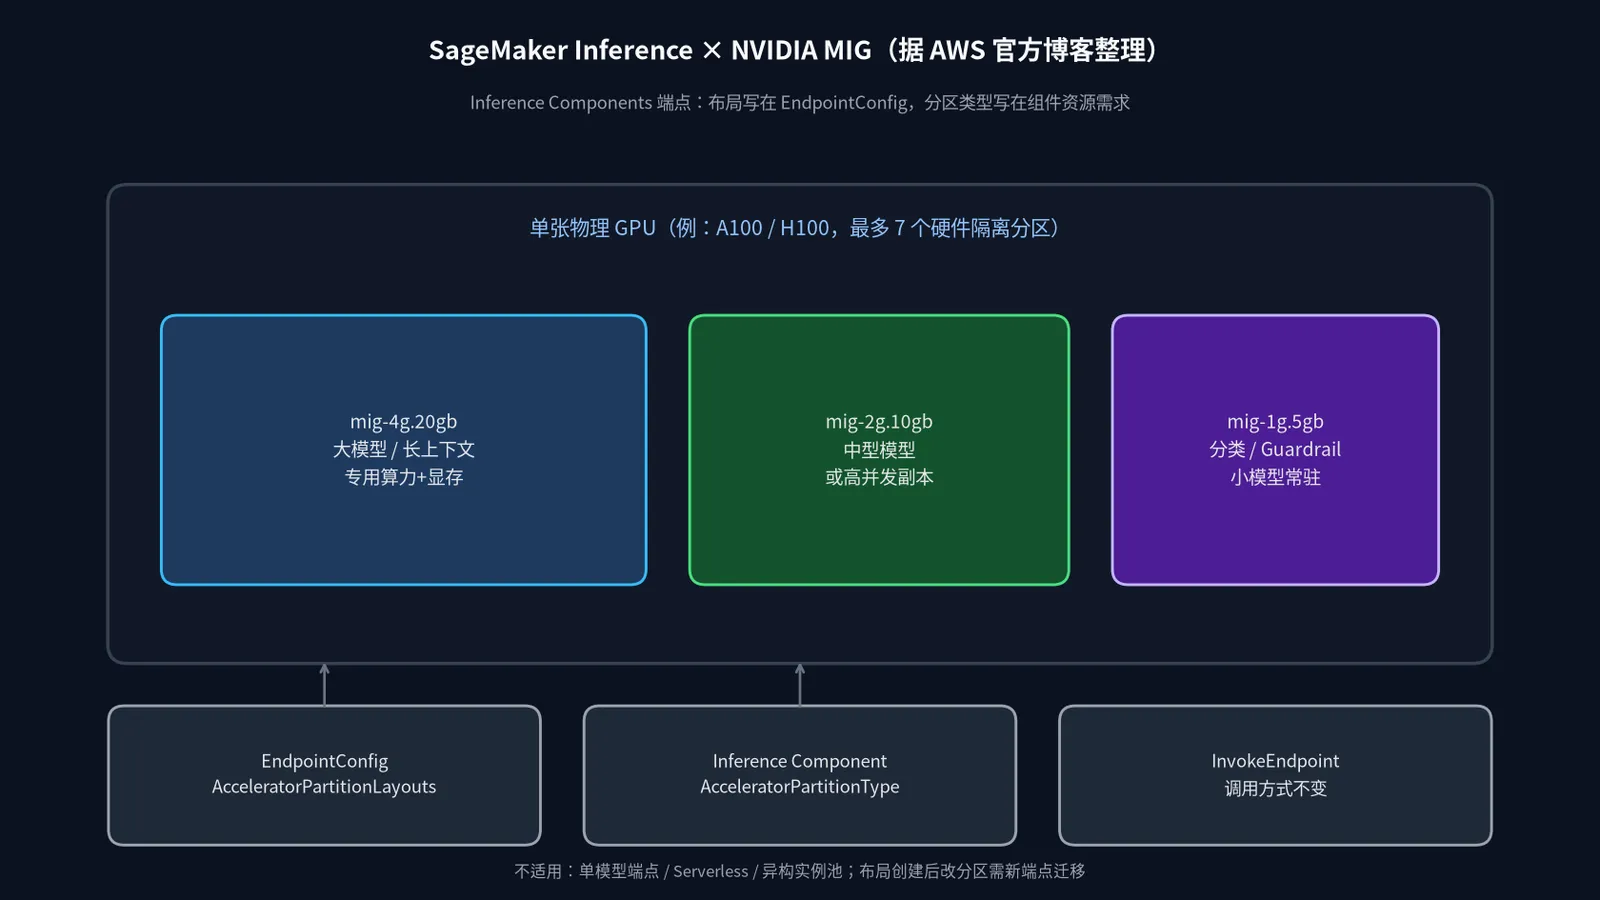
功能只在 使用 Inference Components 的实时端点 上生效;单模型端点、Serverless、异构实例池不能分区。配置侧没有新 API、新资源类型,也没有新的 IAM action——省略这两个字段时行为与今天一致。
AcceleratorPartitionLayouts:写在CreateEndpointConfig的 production variant 上,声明「每张加速卡怎么切」。示例布局mig-4g.20gb + mig-2g.10gb + mig-1g.5gb会吃满 A100 的 7 个计算切片;同一 variant 里每张卡按同一布局切分。AcceleratorPartitionType:写在 Inference Component 的ComputeResourceRequirements里,指定该组件副本落在哪种分区上。此时NumberOfAcceleratorDevicesRequired仍为 1,但语义变成「一个分区」而不是「一张整卡」。
分区在端点进入 InService 时完成切割;官方称其测试中,GPU 分区操作使端点配置时间大约增加 17 秒。组件的分区类型在生命周期内固定;要换 profile 需新建组件,要改整卡布局则通常需要新端点并做流量迁移。计费仍按整台实例小时价,分区提高的是利用率,不改单价。
实例与 profile:先按 GPU 查表,再算显存三件套
当前覆盖 P4d(A100 40GB)、P5(H100 80GB)、G7、G7e 实例族,支持区域包括美东/美西、新加坡、东京、法兰克福、爱尔兰等(实例可得性因区而异)。单卡分区上限不超过 7,且随 GPU 而变;G7 最多 2 片,G7e 最多 4 片。profile 名要按 GPU 核对,不能把 P4d 布局原样搬到 P5。
选型时官方提醒:分区同时给出固定比例的算力与显存。Prefill 更吃计算切片,decode 与并发更吃显存带宽和 KV cache。显存至少要装下 权重 + KV cache(按上下文与并发)+ 约 1–2 GB 运行时开销;只按权重大小选型,上线后很容易在负载下缩短上下文或直接失败。文中给的参照:FP16 的 8B 模型,在 40GB 分区上较从容地服务约 8K 上下文。
厂商自测:H100 的 3g 切片对整卡 A100
AWS 用 genai-bench,在生产级实时端点上对比 H100 的一个 mig-3g.40gb 分区 与 一张未分区的 A100-40GB,两边都跑 Llama-3.1-8B-Instruct、同一镜像与客户端。五组流量形态、并发从 2 扫到 512。文中给出的厂商自测结论包括:分区侧输出 tokens/s 全面更高;在成本效益最大的负载点上约高 53%–89%;inter-token latency 低约 8.9%–42.1%;TTFT 低约 5.6%–47.5%;按当时 on-demand 单价折算到「单元成本」后,每百万输出 token 大约便宜 18%–34%(短提示、低并发时整卡 A100 仍可能更便宜)。长上下文高并发时,A100 侧出现请求超时失败,分区侧未出现同类失败——官方强调这是场景对比,不是普适结论,应用自己的流量复测。
小杜点评
对做推理平台的人,MIG 本身不新鲜;新鲜的是 托管端点把硬件隔离变成两个可选字段,还明确画了边界:只服务 Inference Components、布局创建后难热改、账单仍是整机。工程上我会先问三件事:现有多模型是不是已经组件化、各模型的权重+KV 是否吃得下候选 profile、以及「稳定画像」够不够久——适合微调变体、租户模型、流水线多阶段同机共置,不适合天天改混部比例的实验集群。数字一律按 厂商自测 读:有用的是「切片 vs 整卡」这种可比单元,落地仍要按自己的 prompt 长度与并发画曲线。