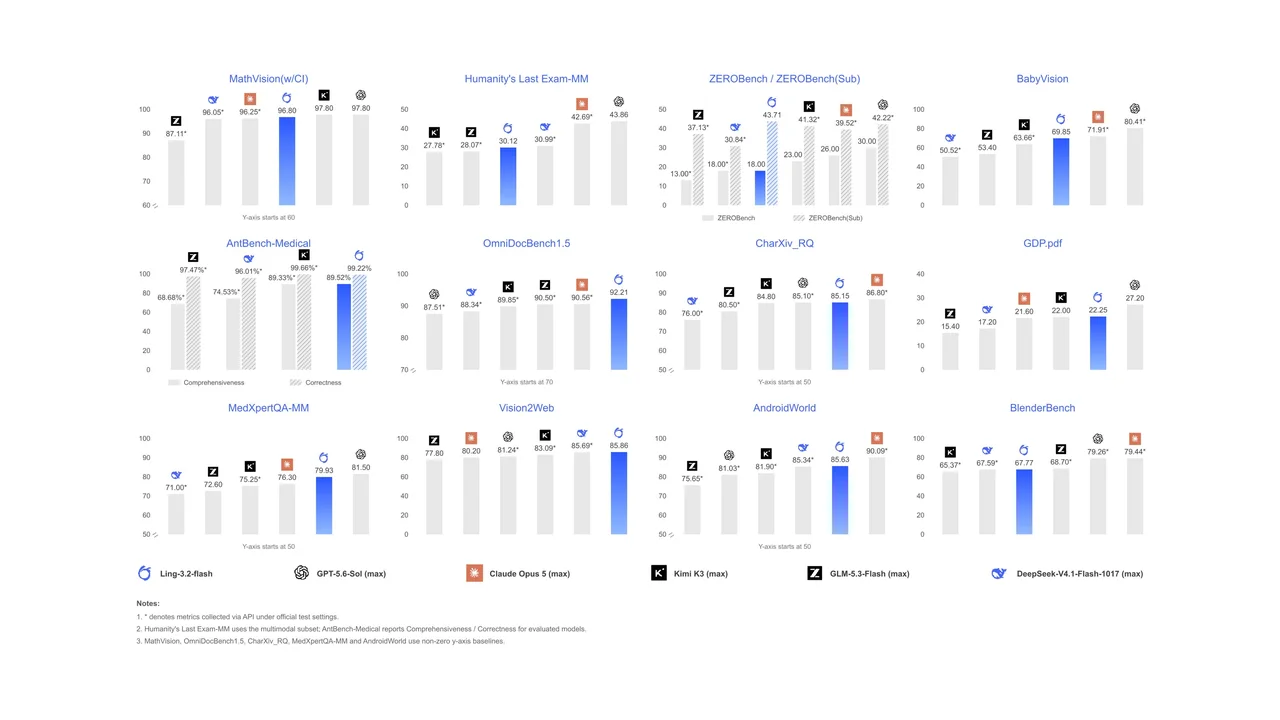
东京时间 11 月 6 日凌晨 4:40(Ant Ling 官方 X 帖发布时间为 UTC 2026-11-05 19:40,官方文档更新日志标注的上线日期是 11 月 5 日),蚂蚁集团旗下的 Ant Ling(百灵)发布了新一代原生多模态模型 Ling-3.2-flash:总参数 560B、每个 token 激活约 25B,上下文 1M,支持图像、文本、视频输入。官方还拿出了一张评测图,称它在三项基准上超过 Claude Opus 5(max)。
这条新闻值得看,不只是因为又多了一个大尺寸多模态模型,而是它把「560B / 25B / 1M」这套 Ling 3.1 已经用过的规模,直接接上了视觉输入,并且给出了偏低的 API 价格和两周免费期。下面把能核实的信息和需要打折扣的部分分开讲。
这次到底发布了什么
按官方文档,Ling-3.2-flash 是 Ling 系列「最新一代原生多模态模型」:560B 总参数、25B 激活参数,上下文窗口上限 1M,在架构层面融合视觉与语言,不依赖外挂的视觉模块,输入可以是图像、文本和视频。官方强调的四个方向是:复杂视觉理解、多模态长程 Agent、3D 理解与交互、医疗多模态。
放在 Ling 家族里看,文档里的对照表很清楚:Ling-3.1-flash 同样是 560B / 25B / 1M,定位是办公、长程软件开发和复杂 Agent 任务;之前的 Ling-3.0-flash-VL 是 124B / 5.5B / 256K 的多模态模型,并且已经在 Hugging Face 和 ModelScope 开源。所以 3.2 可以理解为:同样的大容量低激活比,加上原生视觉与视频输入。
需要说明的一点是,官方文档和更新日志只提到在线体验和 API 调用,没有提到 3.2 的开放权重。想本地部署的读者,目前先别抱期待。
怎么用:接口、限制和价格
官方文档写明,模型同时兼容 OpenAI 的 Chat Completions 接口和 Anthropic 的 Messages 接口。图片用 image_url 内容块,视频用 video_url 内容块。多模态教程里列出的限制包括:视频时长不超过 30 秒,每次请求只能带 1 个视频。长视频、多视频的场景,现阶段需要自己先切分和抽帧。
价格方面,IT之家报道的数字是输入每百万 token 0.30 美元、输出 0.90 美元(该报道称 DesignArena 榜单指出这是同性能级别里最低的费率,这一说法出自转述,不是蚂蚁文档里的原话)。官方更新日志明确写了:上线后前两周免费。如果你有文档解析、网页还原或者医学影像问答之类的评测集,这两周是低成本试跑的好时机。
另外一个值得留意的细节是,同一套 560B / 25B / 1M 的规格,3.1 偏文本和 Agent、3.2 偏视觉和多模态 Agent,两个模型现在都挂在同一个 API 平台上。对做应用的团队来说,这意味着可以按任务分流:纯文本的长程任务走 3.1,带图或带视频的走 3.2,同一套鉴权和接口协议,不用维护两套接入代码。这是我根据文档对照表做的推断,具体效果还是要以实测为准。
官方评测图:赢在哪里、输在哪里
蚂蚁官方发的评测图里,对比对象有 GPT-5.6-Sol(max)、Claude Opus 5(max)、Kimi K3(max)、GLM-5.3-Flash(max)和 DeepSeek-V4.1-Flash-1017。图注说明:带星号的数字是蚂蚁在官方设置下通过 API 采集的,也就是对手的成绩由蚂蚁自己重新测的,整张图都应当当作厂商自测来看。
我把图里 Ling-3.2-flash 与 Opus 5(max)都有读数的项目列出来(读自官方图,单位均为图中分数):
| 基准 | Ling-3.2-flash | Opus 5(max) |
|---|---|---|
| OmniDocBench1.5 | 92.21 | 90.56 |
| ZEROBench(Sub) | 43.71 | 39.52 |
| Vision2Web | 85.86 | 80.20 |
| MedXpertQA-MM | 79.93 | 76.30 |
| GDP.pdf | 22.25 | 21.60 |
| MathVision | 96.80 | 96.25 |
| CharXiv_RQ | 85.15 | 86.80 |
| BabyVision | 69.85 | 71.91 |
| AndroidWorld | 85.63 | 90.09 |
| BlenderBench | 67.77 | 79.44 |
| ZEROBench | 18.00 | 26.00 |
| Humanity's Last Exam-MM | 30.12 | 42.69 |
官方标题说的「三项超过 Opus 5」,指的是 OmniDocBench1.5、ZEROBench(Sub)和 Vision2Web。把图里两边都有读数的 12 项全列出来,Ling-3.2-flash 领先 6 项、落后 6 项,领先的集中在文档解析、前端还原和部分医学多模态;落后的集中在 GUI 操作(AndroidWorld)、3D 建模(BlenderBench)和难度高的知识推理题(HLE-MM、ZEROBench 主榜)。另外在图里,GPT-5.6-Sol 在 HLE-MM(43.86)和 BabyVision(80.41)上也明显更高。
此外,IT之家转述 DesignArena 的图像转前端竞技场结果:Ling-3.2-flash 以 1238 的 Elo 分进入前十。这个榜单我没有单独核对,仅作参考。
对开发者意味着什么
如果你做的是文档解析、截图转网页、带图的问答,这个模型值得进评测集:价格低、接口兼容 OpenAI 和 Anthropic 两套协议,换模型的代码改动很小。如果你想做的是手机或桌面 GUI Agent,或者需要强 3D、强知识推理的场景,按这张图的自测结果,它并不比 Opus 5 占优,选型时别被「超过三项」的标题带偏。
实操上我建议这样试:先用自己的真实数据(不是公开榜单)挑 50 到 100 条样本,跑 Ling-3.2-flash 和你现在在用的多模态模型,重点对比文档表格抽取、截图还原和长图理解;限免期内多跑几轮,留好延迟和失败率的记录。视频场景先按 30 秒、单视频的限制设计。
小杜点评
从算法工程师的角度,我的看法有三点。第一,「560B 总参数、25B 激活」让它在价格上能打,但 MoE 的好处主要体现在推理成本上,真要自己部署还得看权重放不放,目前没放。第二,官方图里对手成绩是蚂蚁自己用 API 重测的,这种做法本身没问题,但我们读的时候要把它当成厂商口径;两边都有读数的 12 项里它赢 6 项、输 6 项,别只看标题里赢的那三项。第三,我更关心的是 1M 上下文加视频输入在真实任务里的稳定性,这需要独立评测和社区反馈来验证,建议等一两周看第三方结果再决定要不要全面切换。