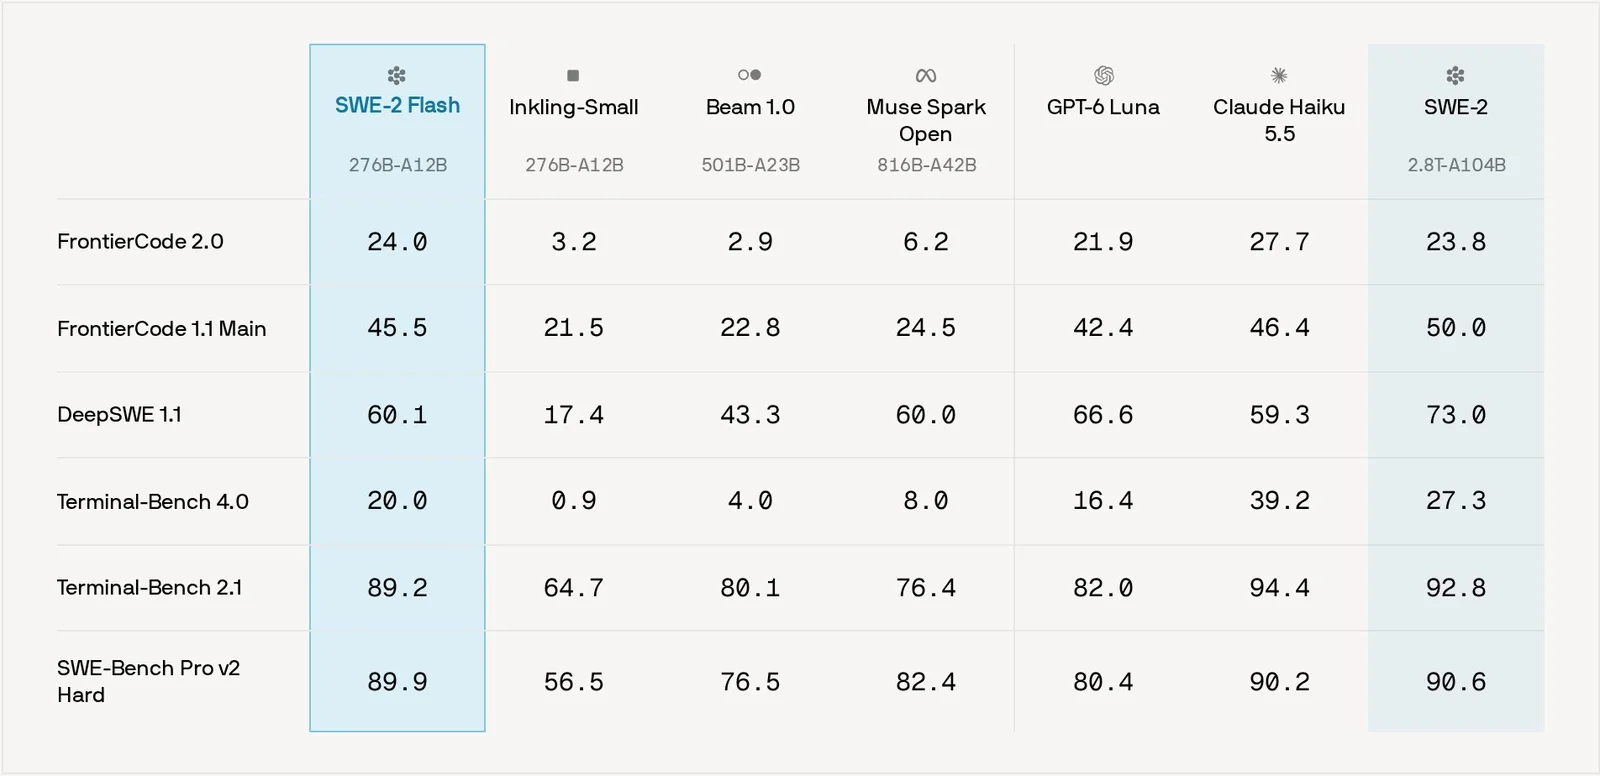
东京时间 11 月 5 日凌晨 4:55(美国时间 11 月 4 日),做 Devin 的 Cognition 发布了新编程模型 SWE-2 Flash。它不是从零训练,而是在 Thinking Machines(Mira Murati 创办的公司)开源的 Inkling-Small(276B 总参数、12B 激活的 MoE) 上,加了一段中期训练再做大规模强化学习。官方自测在 FrontierCode 2.0 上从基座的 3.2 拉到 24.0,略超自家 2.8T 参数的 SWE-2(23.8);速度约为 SWE-2 的 3 倍、价格只有它的 1/5。值得关注的点有两个:一是“拿开源基座做中训 + RL”这条路线的收益被量化得很清楚;二是 Cognition 以网络安全风险为由,暂不公开权重,只打算通过一个审核制的项目分享给合作方和研究者。
发布了什么
按 Cognition 官方博客和 X 上的发布串,这次的要点是:
- 模型:SWE-2 Flash,基座是 Inkling-Small,276B 总参数、12B 激活。据 AI Affairs 报道,Inkling-Small 的权重在 7 月 30 日以 Apache 2.0 许可发布。
- 定位:面向日常工程活,官方举的例子是自动化、代码审查、功能开发和更新文档,这些越来越多可以交给小模型。
- 速度和价格:官方称是 SWE-2 的 3 倍速度、1/5 价格,演示里写的是 200 tok/s 对 60 tok/s。
- 怎么用:现在只能在 Devin Desktop 和 Devin CLI 里用,Pro、Max、Teams 用户 免费用到本月底(11 月 30 日)。
- 权重:不公开。官方说正在做一个“安全分享权重”的项目,几周后公布细节。
OrcaRouter 的解读文章特别指出:这次没有 API 端点、没有模型 ID、没有按 token 计价,上下文长度和最大输出也没写。所以“1/5 价格”目前只能理解为 Devin 内部的相对成本,外部开发者还买不到。
成绩怎么看:赢了美国开源,但不是全面领先
下面这些都是 Cognition 自测的数字(博客完整表格里还有两个中国模型,官方 X 配图里没放):
| 基准 | SWE-2 Flash | Inkling-Small(基座) | GLM 5.3 Flash | DeepSeek V4.1 Flash | Claude Haiku 5.5 | SWE-2 |
|---|---|---|---|---|---|---|
| FrontierCode 2.0 | 24.0 | 3.2 | 14.2 | 19.3 | 27.7 | 23.8 |
| DeepSWE 1.1 | 60.1 | 17.4 | 63.4 | 77.0 | 59.3 | 73.0 |
| Terminal-Bench 4.0 | 20.0 | 0.9 | 41.8 | 42.3 | 39.2 | 27.3 |
| Terminal-Bench 2.1 | 89.2 | 64.7 | 84.3 | 91.0 | 94.4 | 92.8 |
| SWE-Bench Pro v2 Hard | 89.9 | 56.5 | 88.2 | 86.3 | 90.2 | 90.6 |
| ExploitBench | 34.8 | 11.3 | 36.0 | 31.1 | 38.0 | 36.1 |
我读这张表有三点感受:
- “超过所有美国开放权重模型”是成立的:同表里的 Beam 1.0(501B)和 Muse Spark Open(816B)在每一项上都不如它,比如 Terminal-Bench 4.0 只有 4.0 和 8.0。
- 但加上中国开源模型就不一样了:DeepSeek V4.1 Flash 在 DeepSWE 1.1(77.0)、Terminal-Bench 4.0(42.3)、Terminal-Bench 2.1(91.0)上都明显更高,GLM 5.3 Flash 在 Terminal-Bench 4.0 上也有 41.8。Terminal-Bench 4.0 这种更难、更偏长链路终端操作的测试,SWE-2 Flash 只有 20.0,差距不小。
- 对比自家大哥 SWE-2:FrontierCode 2.0 打平略高,但 DeepSWE 1.1(60.1 对 73.0)和 Terminal-Bench 4.0(20.0 对 27.3)还落后。这符合“小模型扛日常、硬骨头交大模型”的定位。
另外速度那张 200 对 60 tok/s 的演示,官方自己写明是“把两个模型各自的运行记录按模拟速度回放”,并非线上实测吞吐,这点 OrcaRouter 和 AI Affairs 都特意提了。
训练配方:这次真正值得抄的部分
对算法工程师来说,博客里最有价值的是训练方法:
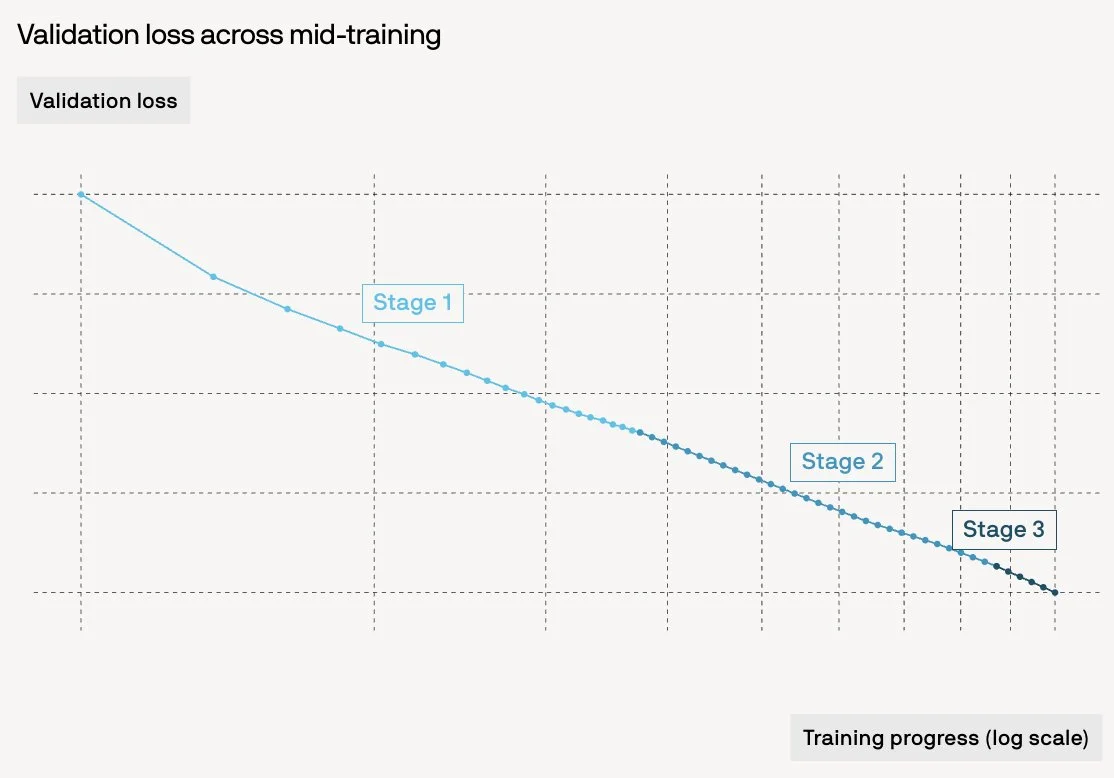
1. 第一次在 RL 前加了中期训练(mid-training)。 数据是几万亿 token 的代码、科学文章、博客等,分三个阶段训练,把最稀缺、质量最高的数据放到最后。官方说三个阶段里验证集 loss 都按对数线性稳定下降。
2. 用“token 效率曲线”选数据配比。 他们先准备了一个反映真实软件工程能力的高质量留出集,然后对每种候选数据配比,测“要多少 token 才能达到基线配比同样的验证 loss”,把这个比值画成曲线来横向比较。这个方法很朴素,但比拍脑袋调配比靠谱,自己做领域继续预训练时可以直接借鉴。
3. RL 的提升主要来自任务,而不是算法。 官方原话的意思是:RL 配方相对 SWE-2 只做了小调整,大部分收益来自更高质量、更多样的 RL 任务。他们逐个审核了任务指令、环境搭建和验证器(verifier),还新增了多种任务类型。做过 Agent RL 的人应该都有体会,验证器写错一个,模型就会学会钻空子。
权重为什么不放:网络安全这道坎
Cognition 专门针对安全攻防做了训练,ExploitBench 从基座的 11.3% 提到 34.8%。官方的说法是:这些能力能帮防守方,也能被攻击者利用,加上最近网络攻击明显增多,所以暂不公开权重,改为向可信的行业伙伴和研究机构安全分享,允许他们在自己的敏感环境(包括本地部署)里微调和运行。
这和最近“开源基座 + 闭源微调版”的趋势是一致的:基座 Inkling-Small 是 Apache 2.0,谁都能下载;但加了中训和 RL 之后的版本,分发开关握在 Cognition 手里。
对开发者意味着什么
- Devin 付费用户:月底前免费,可以把代码审查、写文档、小功能这类活切到 SWE-2 Flash,顺手和 SWE-2 对比一下,看哪些任务小模型就够用。
- 想自己部署的团队:现在拿不到 Flash 的权重。如果需要可控部署,可以关注几周后公布的权重分享项目,或者直接从 Inkling-Small 基座出发,参考上面的中训 + RL 配方自己做。
- 做选型的同学:别只看“美国最强开源”这个标签。如果对来源没有限制,表里的 DeepSeek V4.1 Flash、GLM 5.3 Flash 在难的终端类任务上更强,而且是能下载的。
小杜点评
这次发布最有意思的不是分数,而是它把“基座 → 中训 → RL”每一步的收益摆得很清楚:同一个 276B-A12B 基座,FrontierCode 2.0 从 3.2 到 24.0,Terminal-Bench 4.0 从 0.9 到 20.0,说明对编程 Agent 来说,后训练的数据和环境质量才是大头,参数规模没那么决定性。token 效率曲线选配比、把高质量数据放最后、逐个审 verifier,这三条都能直接用在自己的项目里。
但也要冷静看两点:一是所有成绩都是厂商自测,速度对比还是模拟回放;二是“美国开源第一”是个带限定词的口径,放到全球开源里,它在难任务上还不占优。权重暂不公开,目前对大多数人来说它只是 Devin 里的一个更快更便宜的选项。等权重分享项目的细节出来,再看它能不能真的成为企业私有化部署的选择。