东京时间 11 月 5 日早上 8:35(美国时间 11 月 4 日),OpenAI 发布 Images 2.6:ChatGPT 里能直接做动图(GIF)、能把人物和宠物存成"参考图"反复用;API 侧同时上线两个新模型 GPT-Image-2.6 Flare 和 Sunburst,官方称出图比之前快 50%,并新增 SVG 矢量输出、圈画式编辑(markup)和一个控制"规划力度"的 complexity 参数。价格和 GPT Image 2.5 一样。对做内容、做设计工具、做 Agent 的开发者来说,这次值得关注的不是画质又涨了多少,而是"动图、矢量、精确局部修改"这三类以前要拼好几个工具才能完成的活,现在一个接口就能出。
这次更新了什么
按 OpenAI 官方博客和开发者文档,Images 2.6 的变化可以分成 ChatGPT 端和 API 端两部分。
ChatGPT / Codex 端:
- GIF 动图:用一句提示词或一张图生成循环动图,可以调速度、单独改某一帧。
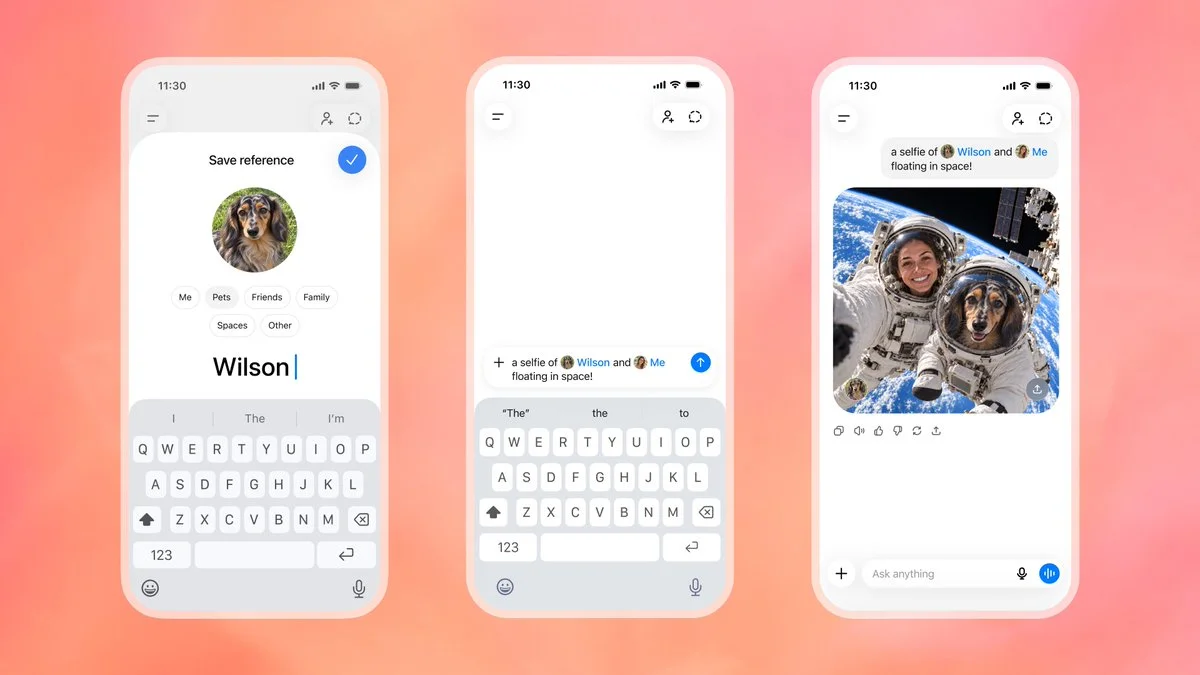
- 参考图库:把自己、宠物、角色存成参考图,之后新建图片时直接调用,不用每次重新上传(见下图)。
- 速度:整体出图比之前快 50%。
- 覆盖范围:全球所有订阅档位,桌面端、移动端、网页端都有,Codex 里也能用。
API 端:
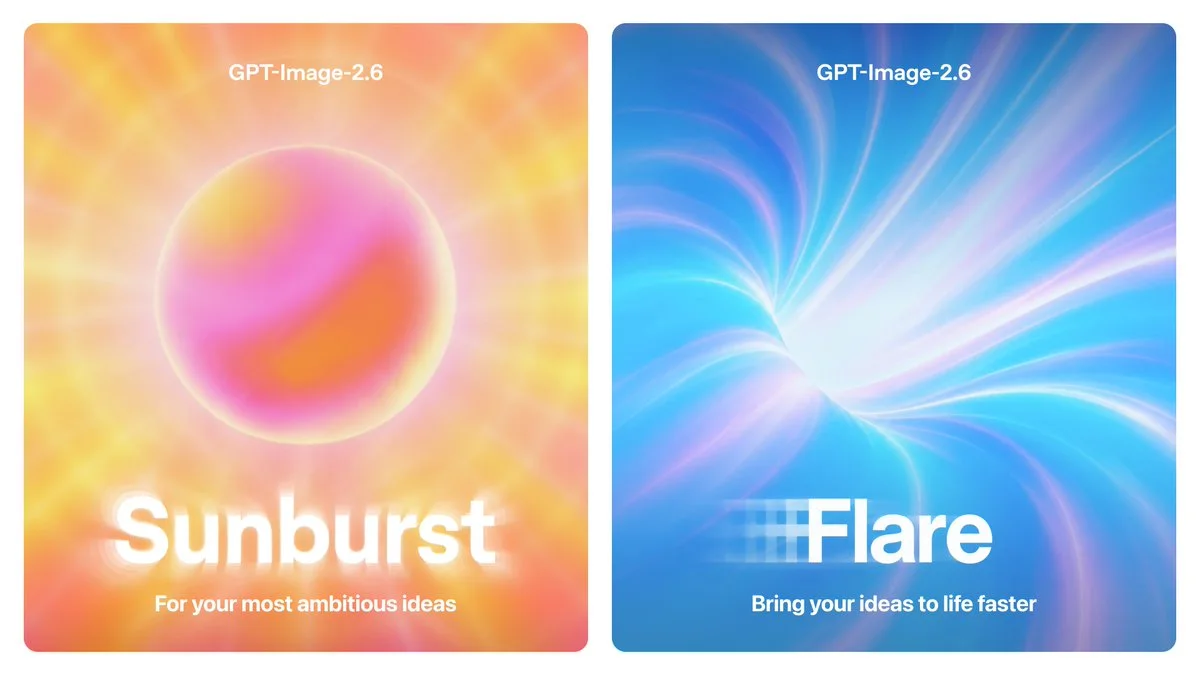
- 两个新模型:
gpt-image-2.6-flare(快速迭代)和gpt-image-2.6-sunburst(细节和多轮编辑一致性)。 - 新增
complexity参数、markup 圈画编辑、SVG 输出、GIF 输出。
官方还给了一个规模数字:ChatGPT、Codex 和 API 上每周生成 40 亿张图,平均每天超过 5 亿张。
Flare 和 Sunburst 怎么选
两个模型的定位很清楚:
- Flare:quality 设为 low 时,最快约 6 秒出一张图;官方说它在海报、产品图这类讲究版式的图上也有改进。适合交互式生成、草稿、批量出图。
- Sunburst:quality 设为 medium 或 high 时,画质更高,而且多轮编辑之间更能保持角色、产品和品牌细节一致。适合需要反复修改的正式素材。
价格上两者完全相同(每 100 万 token):文本输入 $5、缓存文本输入 $1.25;图片输入 $8、缓存图片输入 $2;图片输出 $30。这和定价页上 gpt-image-2.5 系列、gpt-image-2 的价格一致,也就是说升级不加价。两个模型都只支持 Image API 的 v1/images/generations 和 v1/images/edits 两个端点。文档也提醒,使用 GPT Image 系列可能需要先在控制台完成组织验证(Organization Verification)。
三个对开发者最实用的新能力
1. complexity:控制模型"想多少"再画
complexity 有 low、medium、high 三档,不填默认是 high,调节它不单独收费。它和 quality 是两回事:quality 管渲染精细度,complexity 管模型在出图前做多少规划。官方建议:大多数编辑任务用 low complexity,换背景、改招牌这类局部修改更快;元素多、约束多、文字密集的场景再用 medium 或 high。文档同时提醒,complexity 越高延迟越高,也可能引入你不想要的改动,最好针对自己的任务对比一下。
2. markup:圈哪改哪
以前做局部编辑主要靠 mask,而文档也承认 mask 是"提示词驱动"的,模型不一定严格按形状改。现在可以传一张透明背景的标注层 PNG(在原图上画圈、画草图),配合文字说明要改什么。要点:
- 只在
POST /v1/images/edits上可用,GPT Image 2.5 和 2.6 的支持模型都能用; - 标注层必须和第一张输入图同宽同高,必须保留透明像素,不能直接画在原图上合并;
- 原图和标注层各自最多 16,777,216 像素,标注文件不超过 50 MB;
- 不能和
mask、prompt_rewriter同时使用。
这对做"AI 修图"类产品很友好:前端让用户随手圈一下,后端直接把那一层传上去就行。
3. GIF 和 SVG:直接拿到可用的格式
- GIF:在 generations 接口设
output_format: "gif"。frame_count可选 2~64 帧(默认 9),frame_duration_ms每帧 20~2000 毫秒(默认 200,按 10 毫秒取整)。不支持流式、局部预览和 prompt_rewriter,edits 接口也不能输出 GIF。官方示例里 9 帧 × 200 毫秒,正好 1.8 秒一个循环。 - SVG:设
output_format: "svg",n必须为 1。API 会先生成一张参考位图再转成矢量,quality 控制的是那张参考图。输出是静态矢量,不含脚本、外部资源或内嵌位图,适合图标、Logo、插画。同样只在 generations 接口可用。
实操建议
- 先换模型名跑回归:价格不变,现有用 2.5 的流程可以先把 model 换成
gpt-image-2.6-flare或-sunburst,对比延迟和效果再决定。 - 编辑任务先试 low complexity:默认是 high,如果你的场景主要是小修小改,显式设成 low 往往更快,也更不容易"改过头"。
- 做动图注意像素预算:文档说帧数、单帧尺寸和生成数量要一起落在模型的像素上限内,超了就减帧数、减尺寸或减 n。可以先用
size: "auto"让接口自己选。 - SVG 拿到后做一次清理:虽然官方说不含脚本和外链,但要放进网页或印刷流程前,还是建议用 SVGO 之类的工具压缩、检查一遍路径数量。
- 面向终端用户的应用带上
safety_identifier:文档推荐对用户名或邮箱做哈希后传入(不超过 128 字符),旧的user参数已标记为弃用。
小杜点评
从算法工程师的角度看,这次最有意思的是 complexity 这个参数。它把"出图前的规划量"单独暴露出来,和渲染质量解耦——这和文本模型里调推理力度是同一个思路:简单任务少想一点,复杂构图多想一点,把延迟和效果的取舍交给开发者。对做批量生成的团队来说,这意味着可以按任务类型分档,而不是一刀切地用最高配置。
markup 编辑则补上了一个长期痛点。mask 本质上还是让模型"猜"你想改哪里,而一张透明标注层加一句说明,更接近人和设计师沟通的方式,也更容易做成前端交互。
GIF 和 SVG 输出说明图像模型正在往"直接产出可交付格式"的方向走。不过要注意,这些速度、一致性方面的说法目前都来自 OpenAI 官方和早期合作客户,还没有第三方的系统评测;GIF 帧间连贯性和 SVG 的路径质量,建议拿自己的真实素材测一测再决定要不要接进生产流程。