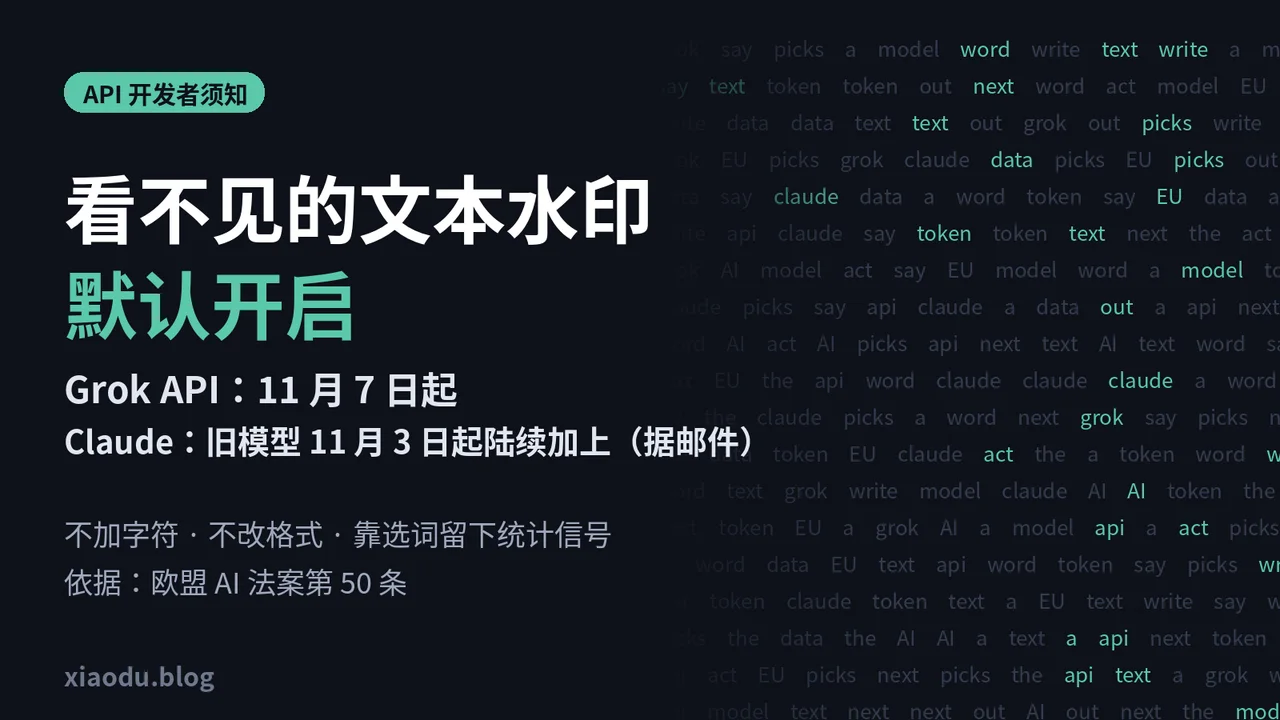
东京时间 11 月 1 日凌晨(美国时间 10 月 31 日),SpaceXSI 在 API 文档里新增了一页「Output Watermarking」:从 2026 年 11 月 7 日起,grok-4.7、grok-4.6、grok-4.5、grok-4.3 以及 grok-4.20 的三个版本,经 API 生成的文本会默认带上看不见的水印。差不多同一时间,Anthropic 也被曝出会在 11 月 3 日把同样的水印扩展到几款旧 Claude 模型。两家给的理由一样:欧盟 AI 法案要求 AI 生成的内容能被机器识别。对开发者来说,这不是一个要改代码的变化,但它会影响你产品里每一段由模型写出来的文字,值得花五分钟弄清楚。
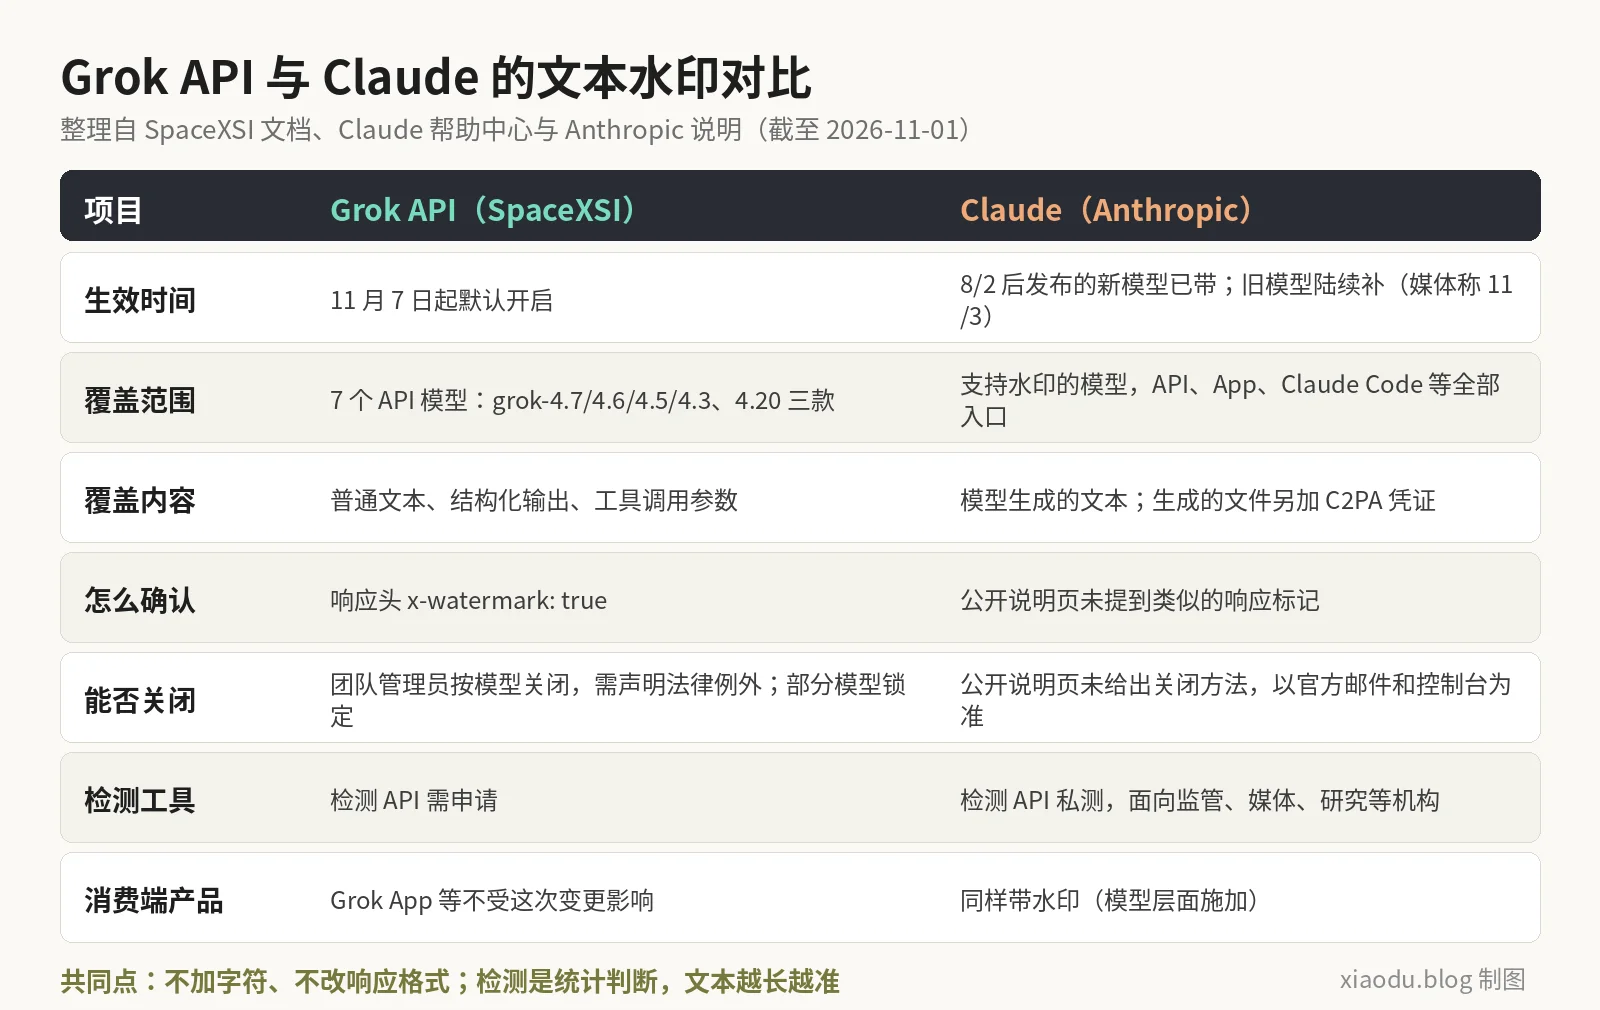
Grok API 这次改了什么
按 SpaceXSI 文档的说法,要点有这几条:
- 默认开启,按模型生效:11 月 7 日起,上面 7 个模型的输出默认带水印。全球端点
https://api.x.ai和各个区域端点都一样。 - 覆盖面比想象的大:不只是普通回复,结构化输出(structured outputs)和工具调用参数(tool call arguments)也算在内。Responses API 和 Chat Completions API 都适用。
- 不加任何字符:水印是在生成过程中"轻微影响模型选哪个 token",不插入隐藏字符、不加标记。文档写明不影响回答质量和速度,也不需要改请求参数。
- 能确认,但只能确认自己的请求:响应头里会有
x-watermark,值为true表示这次输出带了水印,其他值或没有这个头就是没带。 - 检测要申请:检测是统计判断,结果分"有水印、无水印、不确定"三种,文本越长越准。检测 API 需要提交申请。
文档给了 Python 示例,用 OpenAI SDK 的 with_raw_response 就能读到这个头:
raw = client.responses.with_raw_response.create(
    model="grok-4.7",
    input="Write a haiku about the ocean.",
)
print(raw.headers.get("x-watermark"))
能关吗?可以,但有门槛
团队管理员可以在 SpaceXSI Console 的 Team settings 里找到「Model output watermarking」,按模型逐个关闭,设置对团队下所有 API Key 生效,5 分钟内作用到新请求,每次开关都会记进审计日志。
但关闭时要确认你的用途适用法律上的例外,并自行承担标注、披露等合规责任;另外有些模型可能对你的团队是"锁定开启",控制台里关不掉。换句话说,这个开关是给确有合规依据的团队准备的,不是一个随手就能点掉的偏好设置。据 TokenPost 等媒体报道,这次变更只针对 API,Grok 的消费端产品不受影响。
Claude 那边是什么情况
Anthropic 在帮助中心和官方说明里写得比较清楚:2026 年 8 月 2 日及以后发布的 Claude 模型,生成的文本从发布当天就带水印;Claude 生成的 PNG、JPEG 等文件会附上 C2PA 内容凭证。水印在模型层面施加,所以 API、Claude App、Claude Code 等所有入口的输出都会带,并且是全球生效,不只在欧盟。Anthropic 解释说,目前还没有可靠的办法按地区区分。
更早的模型则在逐步补上。据 MACCUS、AB通信 等媒体对 Anthropic 发给 API 客户的邮件的报道,11 月 3 日起 Claude Platform 上的 Mythos 5、Opus 4.7、Opus 4.6、Sonnet 4.6 会加上和 Opus 5.5 相同的水印,Amazon Bedrock 可能晚几天。这个日期目前来自邮件截图和媒体报道,官方帮助中心页面还没写明。
Anthropic 自己也提醒了水印的局限:它只能回答"这段文字有多大可能由 Claude 参与写过",不能证明文字是人写的,也认不出其他 AI;短文本信息量少,判断不准。检测 API 目前是私测,主要开放给监管机构、媒体、事实核查和研究机构等。
为什么大家都在这个时间点做
根源是欧盟 AI 法案第 50 条:2026 年 8 月 2 日起,生成文本、图片、音视频的系统提供方,需要让输出能以机器可读的方式被识别为 AI 生成。Anthropic 说它和约 190 家机构一起签署了欧盟《AI 生成内容透明度行为准则》。据 MACCUS 梳理,8 月 2 日前就已上市的系统有过渡期,最晚到 2026 年 12 月 2 日。所以接下来一个月,各家旧模型陆续"补水印"是大概率事件。
对开发者意味着什么、该做点什么
- 先盘点你的产品里哪些文字直接来自模型:客服回复、营销文案、代码注释、写入数据库的摘要,甚至工具调用参数,都会带上统计信号。对绝大多数应用,这不会造成功能问题。
- 在日志里记下
x-watermark:用 Grok API 的团队,顺手把这个响应头记进调用日志,以后有人问"这段内容是不是 AI 写的、当时有没有标记",你能拿出记录。 - 别指望靠改写去水印:统计水印对轻度编辑有一定鲁棒性,靠同义词替换来"洗"文本既不可靠,也可能让你在合规上更被动。
- 需要关闭先找法务:如果你的业务真有理由关(比如内部测试数据),先确认是否符合法律例外,再让团队管理员操作,别让个人开发者自己点。
- 对外表述要准确:检测结果是概率,不是判决。如果你在做"AI 内容检测"相关产品,务必把"不确定"这一档如实展示给用户。
小杜点评
从算法角度看,这类水印本质上是在采样时给一部分 token 加一点偏置,用密钥做假设检验,跟学术界讨论多年的 green-list 方案是同一个思路,所以它天然只对"足够长、改动不大"的文本有效,也天然只能识别自家模型。它解决的是合规上的"可标记",不是"AI 内容鉴别"这个更难的问题。
我更在意两点。一是覆盖到工具调用参数和结构化输出,说明厂商是按"所有生成的 token"来理解义务的,做 Agent 的同学要知道你的 JSON 里也有统计信号,虽然通常无害。二是开关权在团队管理员手里,而且要声明法律例外,这会把"要不要水印"从工程问题变成合规问题。建议团队现在就把这件事写进模型接入的 checklist,而不是等到 11 月 7 日之后被客户问起再查。
参考来源
- SpaceXSI 文档:Output Watermarking
- Anthropic:How Claude's text watermarking works
- Claude 帮助中心:How Claude marks AI-generated content
- TeslaNorth:Grok's API Answers Will Carry a Hidden Watermark Starting in November(2026-10-31)
- TokenPost:xAI Will Add Invisible Watermarks to Grok API Text Nov. 7
- MACCUS:Claude's invisible watermark reaches Opus 4.7, Opus 4.6 and Sonnet 4.6 on November 3
- AB通信:Claude、見えない文章の透かしを旧モデルにも