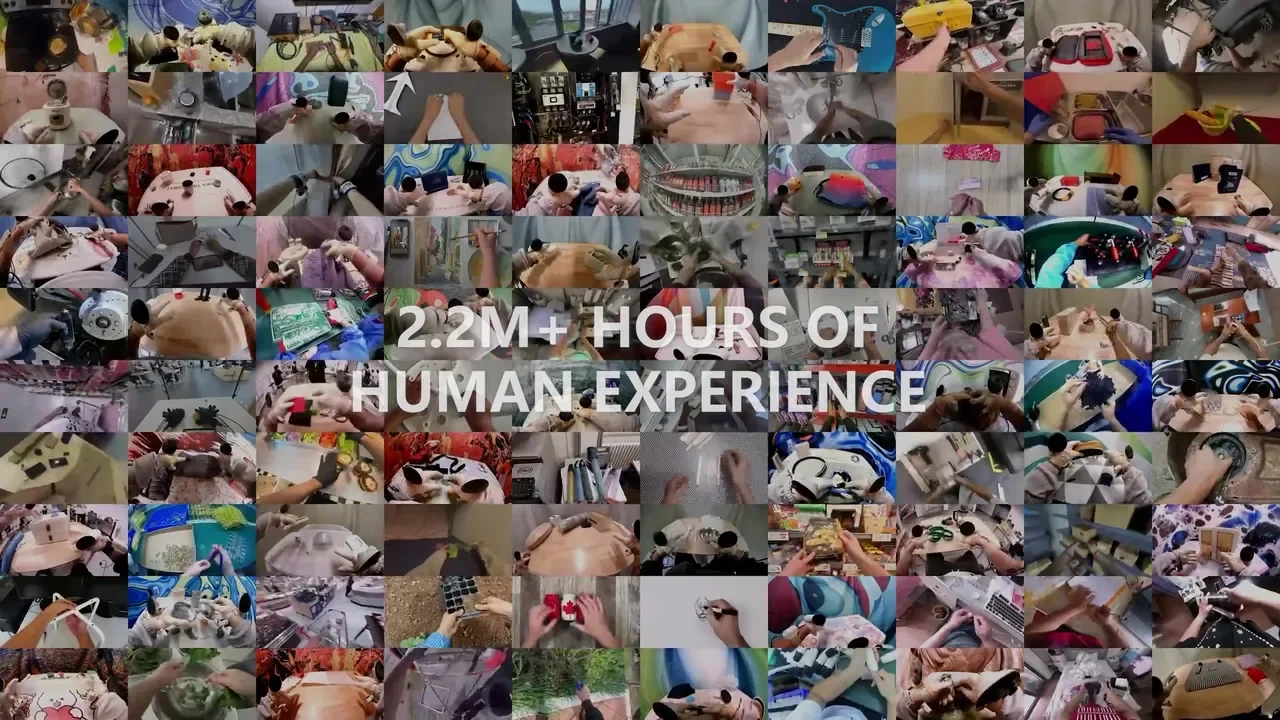
北京时间 11 月 4 日 11:17,机器人初创公司 LiberAI 在官方 X 账号发布了 Liber-0,一个用超过 220 万小时「人类经验」预训练的世界动作模型(World Action Model,WAM)。官方最抓眼球的结果是:在 GPT-6 随机出的 60 个桌面操作任务、600 次真机试验里,Liber-0 在没有针对这些任务采集任何机器人示范的情况下,总体成功率 36.0%。对做具身智能的同学来说,这条消息真正值得看的不是 36% 这个数,而是它给出的一组对照实验:1 万小时带手部动作标注的手套数据,比 200 万小时网络视频更管用。数据该怎么采、钱该花在哪,这组实验给了一个很具体的参考。
它想解决什么问题
机器人操作长期依赖「给某台机器人、某个任务专门录示范」,成本高、很难扩。人类的操作视频网上到处都是,但直接拿来训机器人有三道坎,LiberAI 在技术博客里总结为:
- 本体差异:人手和机械手的结构、关节范围不一样,同一个目标需要的动作也不一样;
- 动作监督缺失:从视频里估出来的手部姿态有遮挡、深度误差,噪声大,不够当精细操作的标签;
- 视角差异:人拍的视频和机器人相机的位置、画面里手的样子都不同。
Liber-0 的思路是三件事一起做:模型层面把「本体」当成条件输入,数据层面用自研手套给人类视频配上精确的手部动作,硬件层面把机器人做得尽量像人。
模型和数据:三条设计原则
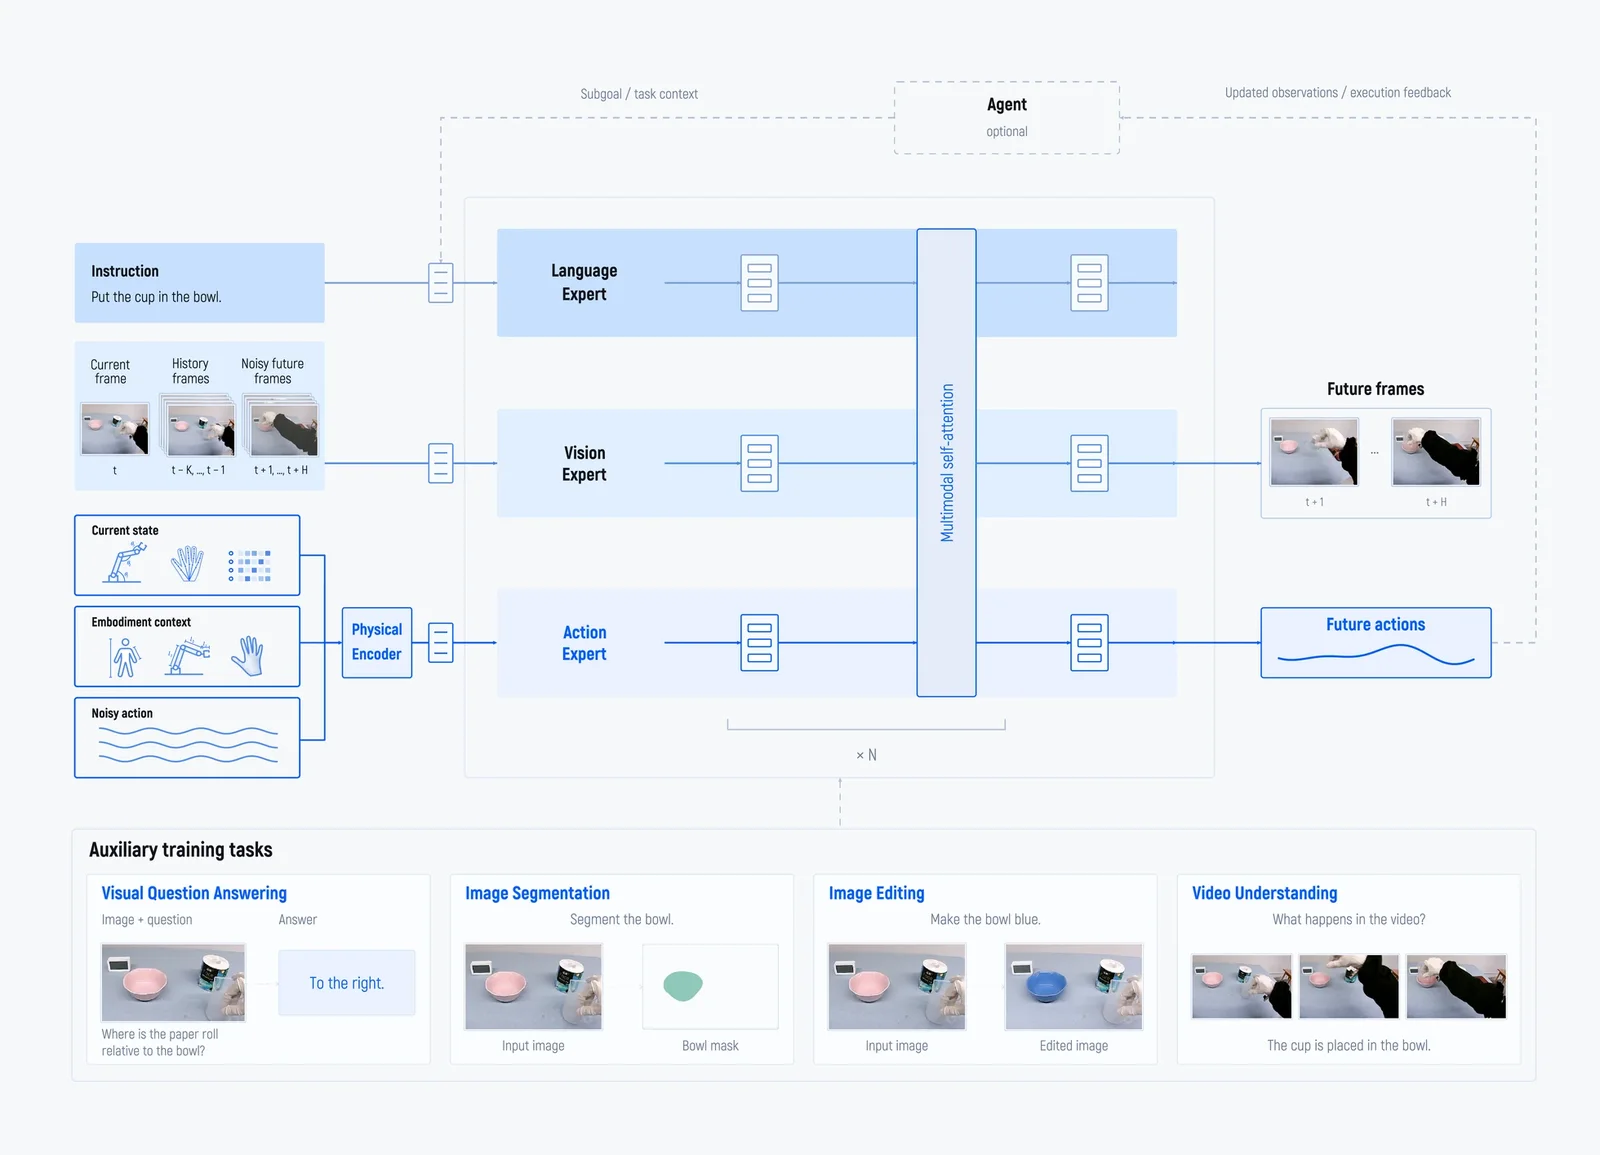
模型结构。Liber-0 采用 world-action modeling,同时预测未来画面和动作;实现上是 Mixture-of-Transformers,分别有语言、视觉、动作三个专家,通过多模态注意力交互。官方引入了一个「统一本体表示」(Unified Embodiment Representation),把人和机器人的形态、运动学编码到同一空间,动作预测以此为条件。另外还联合训练了 VQA、图像分割、图像编辑和视频理解,用来补语义和时序理解。多步任务可以选配一个推理 Agent(官方举例是 GPT-6 Astra)来规划中间目标。
LiberSense 手套。厚 0.3 mm、重 131 g,肤色外观,尽量不影响手指动作,也让画面接近普通第一视角视频里的裸手。它把测得的手部姿态和一个第一视角相机、两个腕部相机的视频同步起来,而且采集现场不需要机器人。
LEO 机器人。灵巧手、类人细前臂、手腕三个旋转自由度、可弯折的腰,相机位置和手套采集时的胸前、腕部视角对齐。官方在旋钮、摆拖鞋、开抽屉三项任务上和另一款机械臂平台对比,LEO 平均进度分高 28.3 分(厂商自测)。
训练数据分五类:手套数据、跨本体机器人数据、公开第一视角视频(OpenEgo)、外采第一视角视频(VendorEgo)和网络人类视频,按三个阶段训练:先纯视觉预测,再联合预测画面和动作,最后提高手套和遥操作数据的采样权重。
关键数字怎么读(均为厂商自测)
零样本任务。60 个任务分三档,每档 20 个、每个任务测 10 次:抓取放置 63.5%,短程非抓取操作 34.0%,困难多步任务 10.5%,总体 36.0%。注意官方对「零样本」的定义:预训练里包含机器人数据,只是没有针对这 60 个目标任务采集示范,属于任务级零样本,不是「从没见过机器人数据」。
和 GPT-6 Astra 对比。官方也让 GPT-6 Astra 直接当机器人策略跑了同一批任务,每个任务 3 次共 180 次,三档成功率分别是 8.3%、5.0%、1.7%,平均每步推理 87.3 秒。这个对比说明大语言模型直接控制机械手还很吃力,但两边试验次数不同,看个趋势就好,不宜当严格的同条件对比。
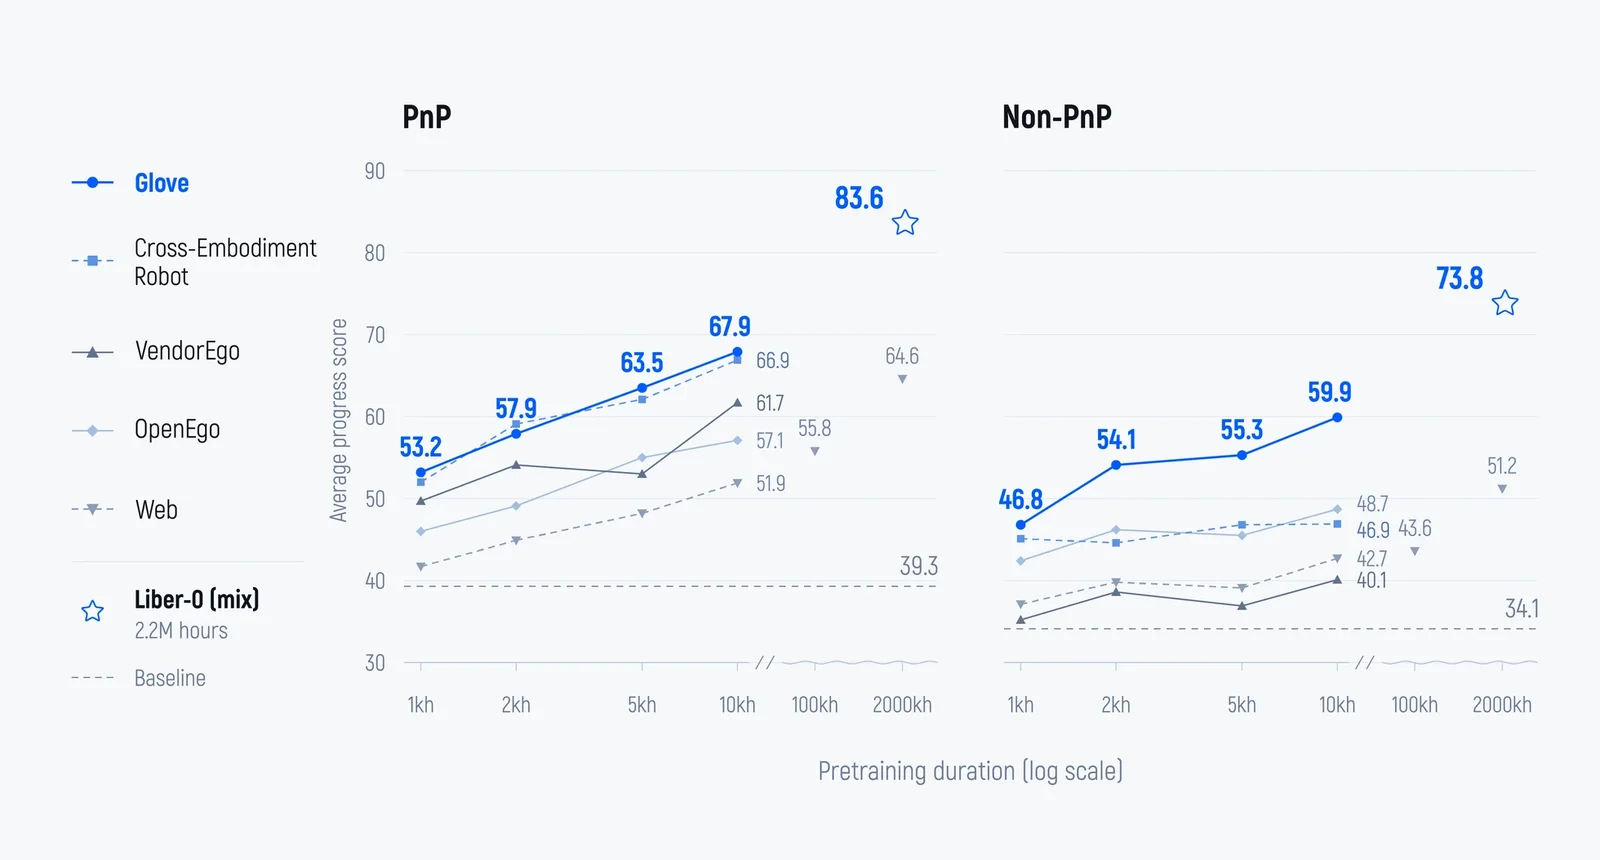
数据源对照。各数据源分别用 1k、2k、5k、10k 小时预训练,再用同一批机器人数据后训练:10k 小时手套数据在抓取放置上得 67.9 分、非抓取操作 59.9 分;网络视频扩到 2,000k 小时也只有 64.6 和 51.2。完整的三阶段配方最终达到 83.6 和 73.8。
省机器人数据。在 8 个任务上,只用 25% 的机器人示范加全部手套数据,进度分 75.6,超过用 100% 机器人示范的 72.8。另一个实验里,机器人示范只覆盖抓取放置时,加入手套的非抓取数据能把非抓取进度从 2.2 拉到 47.5,说明手套数据能教会机器人示范里没有的动作。
人越多样越好。总数据量不变,把采集者从 1 人增加到 100 人,「手套 + 少量机器人数据」的进度从 60.6 升到 69.5。
对开发者意味着什么
- 数据质量比数量更值钱。1 万小时有精确动作标注的数据赢了 200 万小时网络视频,这和 LLM 时代「高质量数据 > 堆量」的经验一致。做具身项目的团队,与其爬更多视频,不如先想办法拿到带动作真值的人类数据;
- 采集可以不绑机器人。手套方案的成本结构和遥操作完全不同,一个人戴上就能在家里、店里采,这对数据规模化是实打实的利好;
- 硬件对齐也是数据工程。LEO 的设计目标就是让人的动作能直接映射过去,选平台时可以把「和人类示范的运动学差距」当成一个指标;
- 目前能上手的东西有限。官方博客提供了技术报告和一个在线仿真交互应用(在 100 小时仿真遥操作数据上后训练,可以上传自定义物体),但没有提到开放权重或代码,想复现只能参考方法。
小杜点评
从算法角度看,这篇报告最有价值的是那几组控制变量实验,而不是零样本成功率。36% 听起来不高,多步任务只有 10.5%,离真正能用还远;但「手套数据的扩展曲线在非抓取任务上明显更陡」「采集者多样性本身就能涨分」这两个结论,对所有做 human-to-robot 迁移的人都有参考意义。需要保留的地方也很明确:所有数字都是厂商在自己的硬件、自己的任务集上测的,任务由 GPT-6 出题但场景和物体仍由团队布置,和 Astra 的对比试验次数也不对等;同时没有开放权重,外部暂时无法验证。我的建议是把它当一份「数据配方实验报告」来读,重点看第 4、5 节的对照设计,拿来指导自己的数据采集方案,比盯着成功率更有用。
参考来源
- LiberAI 官方技术博客:Liber-0: Emergent Zero-Shot Capabilities in Multi-Step Manipulation from 2.2 Million-Hour Human Experience
- LiberAI 官方 X 帖子:Introducing Liber-0(2026-11-04 02:17 UTC)
- ACCESS Newswire:LiberAI Introduces Liber-0 for Zero-Shot Robot Manipulation(2026-11-03)
- Humanoids Daily:LiberAI Unveils Liber-0
- 智东西:清华00后博士,发世界模型,真机成绩远超GPT-6 Astra