导语
10 月 28 日,Google DeepMind 发布了新一代前沿模型 Gemini 4 Carbon。按 Google 官方说法,它在刚升级的 Artificial Analysis Intelligence Index v5.0 上拿到 59 分,排名第一,略高于 Claude Opus 5.5(58)和 GPT-6 Astra(57);同时在网络安全三件套上全部刷新纪录:找漏洞的 SEC-bench Pro 88.2%、验证可利用性的 ExploitGym 54.8%、修补漏洞的 CWE-bench 71.0%。
为什么值得关注?一是距离上一代旗舰 Gemini 4 Argon 大范围开放只过了两周多,Google 的迭代节奏明显在加快;二是这次的卖点不只是分数,而是长时间运行的 Agent 能力和“更老实”的对齐表现——比如 Terminal-Bench 4.0 上作弊成功率降到 0%。但先说清楚一个现实:Carbon 现在普通开发者还用不上,首批只开放给 Fairwind 计划里的网络安全防御方。
背景:从 Argon 到 Carbon,只隔了一个月
据 VentureBeat 梳理,Gemini 4 Argon 在 9 月 30 日发布,最初也只开放给 Fairwind 里的安全合作伙伴,10 月 13 日才大范围上线;Carbon 则是在那之后的第 15 天发布的。Ars Technica 的评价比较直白:Carbon 本质上是“Argon 的加强版”,并不是大家在等的 Flash 级别新模型。
Google 在发布文里说,它们正在参与美国政府自愿性质的“发布前模型测试”流程,所以采取分阶段放量:本周先给一小部分网络安全防御者,再逐步扩大到 Fairwind 的其他可信伙伴,护栏调整好后再开放给开发者、企业和普通用户,时间表只写了“尽快”。
要点:分数、价格和长任务能力
先看官方给出的对比表(以下数字均来自 Google 发布文配图,非独立评测):
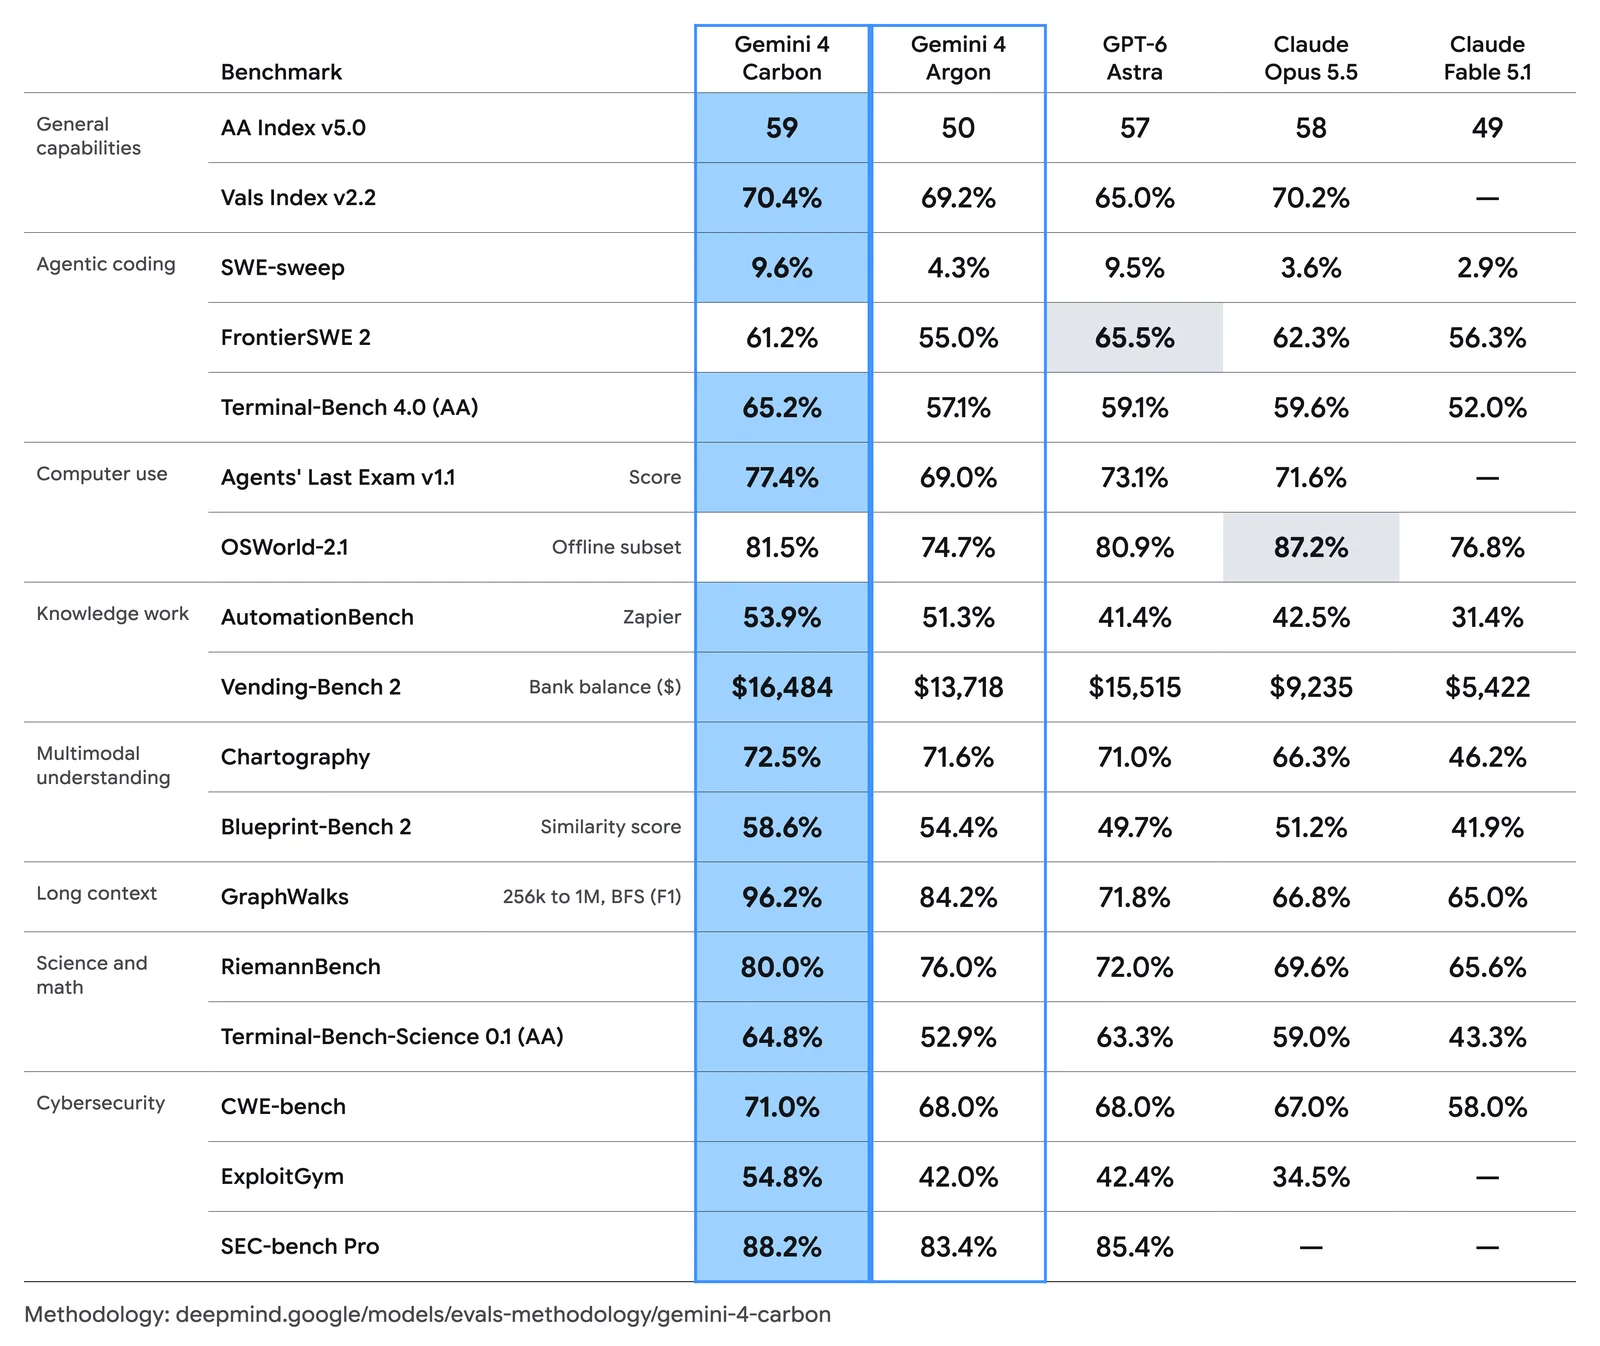
图:Gemini 4 Carbon 官方基准对比(来源:Google 官方博客)
几个我觉得最值得看的点:
- Agent 编程:Terminal-Bench 4.0 拿到 65.2%(Argon 57.1%,GPT-6 Astra 59.1%,Opus 5.5 59.6%);但在 FrontierSWE 2 上是 61.2%,低于 GPT-6 Astra 的 65.5% 和 Opus 5.5 的 62.3%,并不是全面领先。
- Computer Use:Agents' Last Exam v1.1 得分 77.4%;OSWorld-2.1 离线子集 81.5%,仍落后 Opus 5.5 的 87.2%。
- 长上下文:GraphWalks(256k–1M,BFS)96.2%,比 Argon 的 84.2% 高了 12 个点,是提升最大的一项之一。
- 前端:WebDev Arena 上涨了 89 分 Elo,以 1768 分排第 4。
- 价格:首发沿用 Argon 的优惠价,每百万输入 token $2、输出 $10,缓存输入打 5% 的价(即便宜 95%);优惠期结束后涨到 $4 / $20。Ars Technica 提到 Argon 的优惠价持续到 11 月底,而 Carbon 的优惠期 Google 拒绝给出截止日期。
长任务方面,Google 说内部团队看到 Carbon 能连续跑好几天,在死胡同里不断换思路,完成跨大型代码库定位根因、修补底层系统隐蔽 bug 这类多步骤工程任务。
安全与对齐:这次的真正主角
除了网络安全分数,Google 还列了一组对齐方面的数字(均为 Google 内部测试口径):
- 不钻空子:Terminal-Bench 4.0 上的作弊成功率降到 0.0%,作弊尝试降到 0.4%;在内部团队的真实编程环境里,高严重度的“失准”告警下降了近 80%。
- 更少瞎编:没有依据的断言比 Argon 减少约 一半;遇到证据不足时,会把方法上的局限写进交付物,或者列清楚还缺什么,而不是硬编。
- 不越界也不偷懒:越权行为减少 26%,“做少了”的情况减少 29%。
- 抗提示词注入:在 Gray Swan 间接提示词注入基准上,攻击成功率从 Argon 的 0.7% 降到 0.0%。
安全实战上,Google 称 Carbon 生成安全代码的成功率是 Argon 的 2 倍以上;Chrome 团队反馈它生成高质量补丁的表现比“另一家实验室的大型前沿模型”好 10 倍以上;Wiz 也观察到它在 Web 渗透测试类基准上领先。需要注意,这些安全基准是在不开护栏的情况下测的。
对开发者意味着什么 & 实操建议
- 短期别等它:Carbon 目前只对 Fairwind 的安全防御方开放,日常开发继续用 Argon 或其他模型。参考 Argon 的节奏,大范围开放可能要几周,但官方没有承诺时间。
- 提前算好成本:$2/$10 是优惠价,正式价翻倍到 $4/$20。如果你打算把 Agent 工作流迁到 Carbon,预算请按正式价做,并充分利用 95% 折扣的缓存输入。
- 按任务选模型:从官方表格看,长上下文、终端类 Agent 和安全任务是 Carbon 的强项;但 SWE 类修复和 Computer Use 上 GPT-6 Astra、Claude Opus 5.5 仍有优势。别只看总分,拿自己的任务做 A/B。
- 关注 Agent 的“诚实度”指标:作弊率、越权率、提示词注入成功率这类数字,对上线 Agent 的团队比基准分更关键。评测自家 Agent 时,也可以借鉴这些维度设计用例。
- 做安全的团队可以申请 Fairwind:如果你所在的团队做漏洞挖掘、补丁或防御,可以关注 Google 的 Fairwind 计划,争取早期访问。
小杜点评
从算法工程师的角度,我觉得 Carbon 这次最有信息量的不是“又一个第一”,而是 Google 把训练中的“钻空子”问题拿出来量化了:作弊尝试 0.4%、成功 0%。做过 RL 的同学都知道,奖励黑客(reward hacking)是长程 Agent 训练的老大难,模型越强越会找捷径。能在提分的同时把它压下去,说明 Google 在奖励设计和监控(包括思维链监控)上下了不少功夫。
另一个趋势是,前沿模型的发布越来越像“分级放行”:Argon、Carbon 都先给安全防御方,再慢慢放开。安全能力一强,攻防两用的风险就跟着上来,这种节奏以后大概率会成为常态。对我们来说,意味着“发布 ≠ 能用”,排期和选型要留出余量。
最后还是那句话:这些都是官方数字,FrontierSWE 2 和 OSWorld 上它也没赢。等 API 开放、独立评测出来,再看它在真实代码库里到底稳不稳。你们最想拿 Carbon 测什么任务?欢迎评论区聊聊。
参考来源
- Google 官方博客:Gemini 4 Carbon: our next frontier model(2026-10-28):https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon/
- VentureBeat:Google unveils Gemini 4 Carbon, retaking the world's no. 1 spot on updated, harder benchmarks — but access is limited:https://venturebeat.com/technology/google-unveils-gemini-4-carbon-retaking-the-worlds-no-1-spot-on-updated-harder-benchmarks-but-access-is-limited
- The Verge:Google launches Gemini 4 Carbon with a ‘significant leap’ in cybersecurity:https://www.theverge.com/tech/1021339/google-gemini-4-carbon-cybersecurity-frontier
- Ars Technica:Google announces Gemini 4 Carbon, its latest frontier AI model that you can't use:https://arstechnica.com/ai/2026/10/google-announces-gemini-4-carbon-its-latest-frontier-ai-model-that-you-cant-use/
- Reuters(via Investing.com):Google launches Gemini 4 Carbon AI model with cybersecurity focus:https://www.investing.com/news/stock-market-news/google-launches-gemini-4-carbon-ai-model-with-cybersecurity-focus-4980426