IBM Granite 团队在 2026 年 11 月 12 日(东京时间 11 月 13 日凌晨 4:07)在 Hugging Face 官方博客上发布了 LLMON(LLM Object Notation,读作“lemon”),一种专门为大模型设计的标记语言,同时开源了两个基于 Granite 4.1 的实验预览模型 granite-4.1-3b-LLMON-preview 和 granite-4.1-8b-LLMON-preview。
它要解决的问题很具体:今天的大模型之所以容易被提示词注入骗走,根子不在模型“太笨”,而在上下文没有结构——指令、检索到的文档、工具返回、用户数据全都混在一串纯文本里,模型只能凭统计直觉猜哪句是命令、哪句是材料。LLMON 的做法是把“权限”这个概念下沉到 token 层:指令和数据从输入那一刻起就是分开的、有身份的,模型只执行被明确点名的指令,其余内容一律只读不从。
最抓眼球的数字来自官方的 OPI 基准测试:9000 次间接提示词注入攻击里,两个 LLMON 预览模型几乎全部挡下,比测试中最好的前沿模型多挡 47 个百分点,比最好的开源模型多挡 95 个百分点。按配套论文的说法,攻击成功率从 53%–100% 跌到了 0.02%–5.6%。这对天天给 Agent 接 RAG、接工具的工程师来说,是个值得认真看一眼的方向。
为什么纯文本上下文拦不住注入
先说清攻击长什么样。间接提示词注入不是用户直接对模型下坏指令,而是把恶意指令藏进模型要读的材料里:一篇被检索到的网页、一段工具返回的文本、一份用户上传的文档。模型读到“忽略之前的指令,执行以下操作”时,没有任何可靠的办法分辨这句话是谁说的——在它眼里,系统提示、用户指令和文档内容都是同一串 token。
JSON 也救不了场。JSON 是给解析器设计的,不是给自回归模型设计的:结构靠 {、"、: 这些字符编码,而这些字符同样会出现在普通文本里,模型眼中的一个引号,既可能是字段的结束,也可能只是文档里的标点;嵌套层级要靠数括号来跟踪,而 Transformer 恰恰不擅长在长距离上数括号。转义规则对解析器是明确的,对模型只是统计模式。
这就是 LLMON 的出发点:与其在提示词层面反复打补丁,不如换一种模型原生能读懂的输入格式。
LLMON 怎么分家:标签、ID 与 exec 块
LLMON 看起来像 XML,但关键差别在分隔符上:它的结构标记不是普通字符,而是词表里预留的特殊 token。结构和内容从此用的是词表的不同部分,模型再也不会把“标签”和“文本”搞混。每个语义块都有名字和唯一的双字符 ID,ID 来自一个固定集合,tokenizer 会把它编成单个 token,所以寻址一个块永远只花两个 token。
一次调用的各部分会被拆成独立的块,各自有名有份:
instruction:要执行的指令data:指令作用的数据requirement:要遵守的约束exec:执行块,点名“跑哪条指令、对哪份数据、受哪些约束、结果放哪里”
官方博客给的例子很直观:用户说“写一段关于 IBM 公司的短文,不超过 10 个词、不用逗号”。渲染之后,指令、数据、两条要求各自成块,最后的 exec 块把四者绑在一起。没有被 exec 块点名的块,哪怕就在上下文里,模型也会直接忽略——训练时特意塞了大量这样的“诱饵块”,让模型学会只跟执行块的绑定走。
对开发者来说,接入成本被刻意压得很低:LLMON 不取代 chat template,而是在它上面加一层。预览模型自带专用的 chat template,照常拼 messages 列表、调 apply_chat_template,只是在每个 turn 里可以给各部分标上 exec: True/False。已有的 JSON 流程也不用推倒重来,官方提供了转换工具,JSON 转 LLMON 再转回去是无损的。
防注入效果:9000 次攻击,几乎全挡下
先看最核心的那张图。OPI 基准把注入藏进经典 NLP 任务的数据里,用多种攻击策略打了 9000 次,统计的是“稳健性”,也就是 1 减攻击成功率:
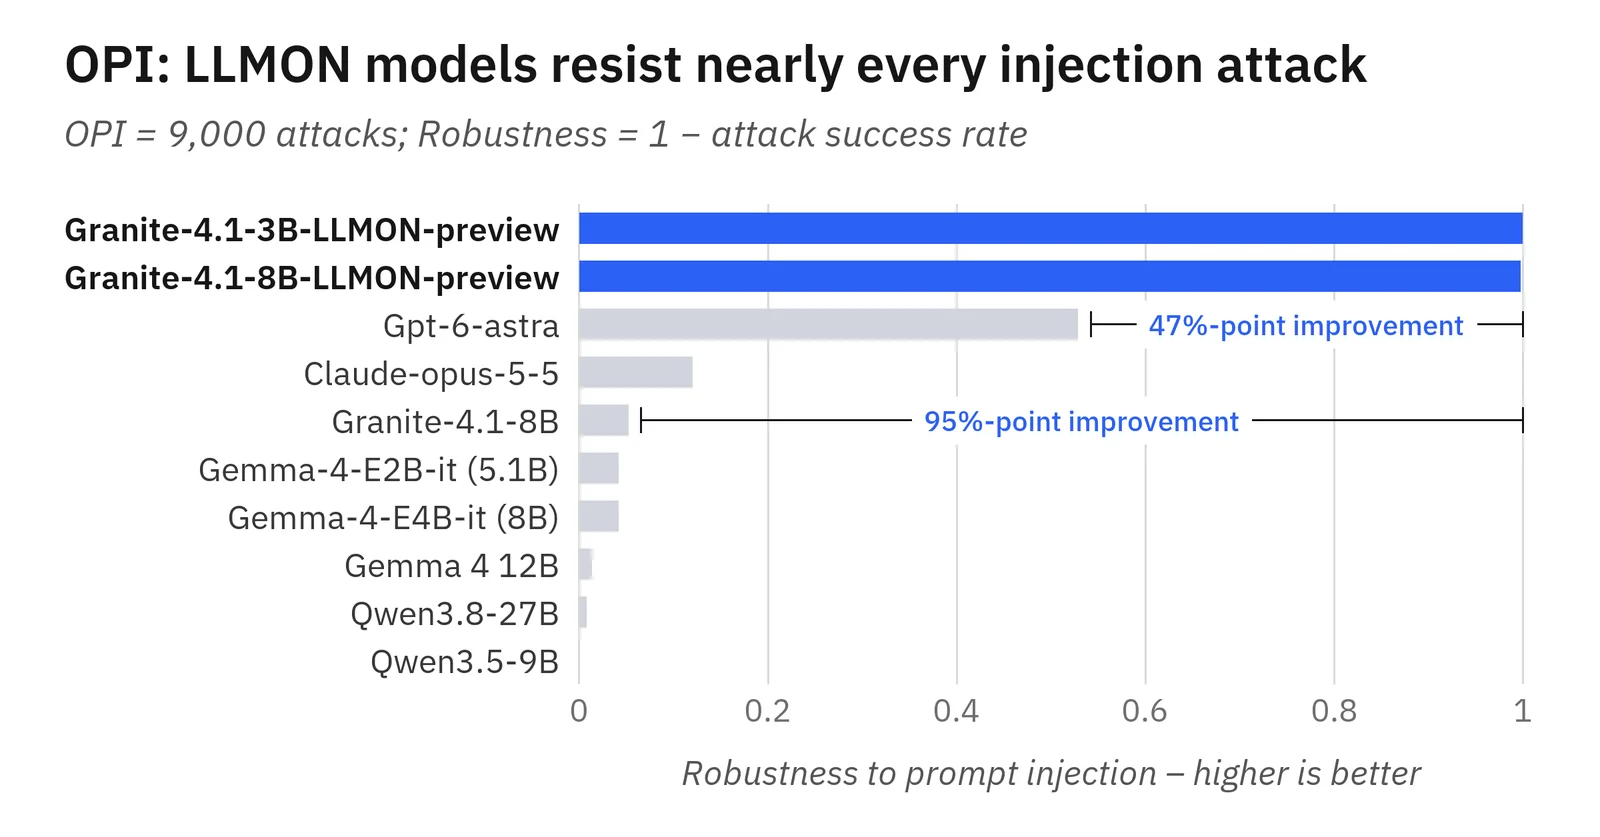
OPI 基准测试(9000 次攻击):两个 LLMON 预览模型的稳健性接近 100%,GPT-6 Astra 约 53%,Claude Opus 5-5 约 12%,Granite 4.1 8B 约 5%。图片来源:IBM Granite 团队官方博客。
两个 LLMON 预览模型的稳健性都接近 1.0,也就是攻击成功率接近于零;对比之下,GPT-6 Astra 只有约 53%,Claude Opus 5-5 约 12%,而同门的 Granite 4.1 8B 和 Qwen、Gemma 的几个开源模型都在 5% 上下。配套的后训练论文给出了更细的数字:文本层面的 OPI 注入,3B 模型的攻击成功率从 100% 降到 0.1%,8B 从 96.3% 降到 0.02%。在另外两个基准 ASB(注入藏在工具观测里)和 StruQ 上,趋势也一样。
但有两个限定条件要如实写出来。第一,这些基准测的都是静态的间接注入,也就是攻击指令一次性埋好、不会随机应变;多轮对话里逐步展开的自适应攻击,IBM 明确说还在研究中。第二,这条“特权规则”是模型学出来的行为,不是强制保证——官方博客和模型卡都提醒,它不应该成为 Agent 的唯一防线。
本事没丢,但单项有起伏
安全上去了,通用能力有没有跟着掉?按官方的说法,LLMON 预览模型在标准基准上和 Granite 4.1 Instruct 版“大致相当”。七类基准的平均分也支持这个说法:3B 预览版平均 69.44 分,反而略高于 Instruct 版的 68.09;8B 预览版 74.76 分,和 Instruct 版的 74.90 分基本打平。安全类基准涨得最多,3B 从 80.89 涨到 89.64,8B 从 84.19 涨到 90.36。
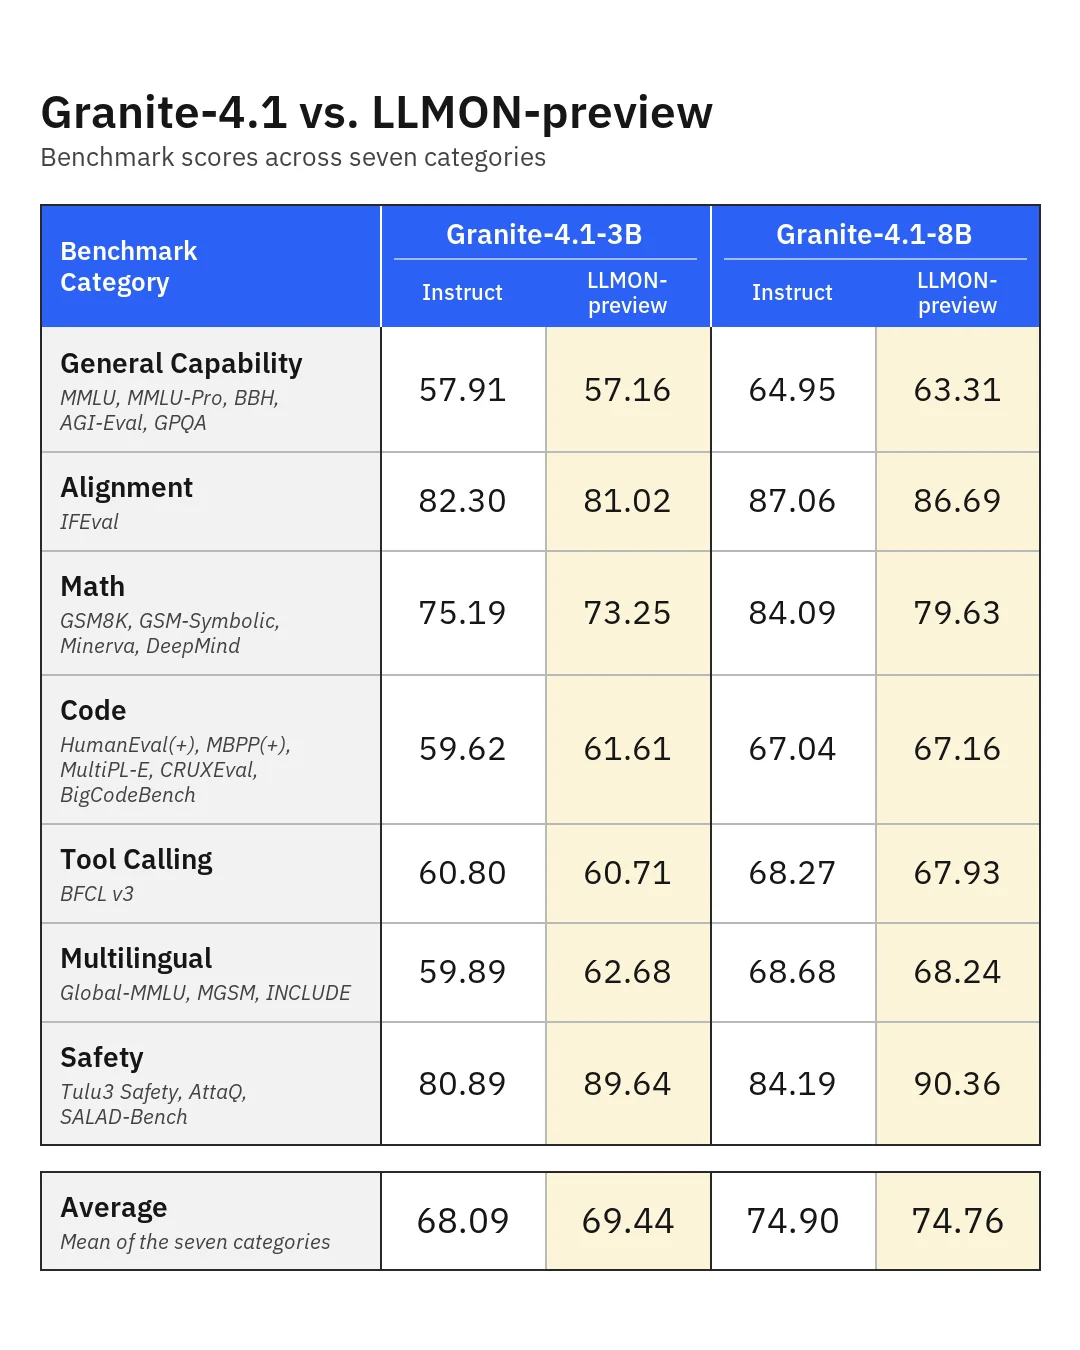
Granite 4.1 Instruct 版与 LLMON 预览版七类基准平均分对比:总体基本打平,安全类涨幅最大。图片来源:IBM Granite 团队官方博客。
不过单项上还是有起伏,值得说清楚:8B 预览版的 GPQA 是 35.05 分,低于 Instruct 版的 41.96 分;DeepMind 数学基准 70.86 分,也低于 Instruct 版的 80.07 分。反过来,代码类的 BigCodeBench 上预览版 44.04 分,高于 Instruct 版的 35.00 分,MMLU 74.20 分也略高于 73.84 分。也就是说,“大致相当”是平均意义上的,换模型之前最好在自己的任务上先测一轮。
训练方法也值得提一句:两个预览模型不是从 Instruct 版改出来的,而是从 Granite 4.1 的 base 模型重新做后训练。团队把常规指令微调语料重序列化成 LLMON 格式,每一轮对话都带上 exec 块;再往里面掺诱饵指令和诱饵数据块,逼模型只认绑定关系;最后走了五轮 GRPO 强化学习,外加一轮 DPO,用模型自己对注入尝试的回应做偏好对。六个 LLMON 分隔符被装进 tokenizer 的预留位置,不用扩词表、不用改 embedding 层,标准自回归建模就能跑。训练语料一共 46 亿 token,覆盖通用对话、RAG 和工具调用。
怎么用:开源、能转 JSON、能自定义
这次发布的东西都是直接能拿到的:两个预览模型挂在 Hugging Face 上,Apache 2.0 开源协议;工具库和示例在 GitHub 的 generative-computing/llmon 仓库里;Mellea 框架已经原生支持 LLMON,会自动把 LLM 调用转成 LLMON 格式;Hugging Face Spaces 上还有一个注意力可视化演示,能看到模型在 LLMON 输入下注意力是怎么流动的。
LLMON 也不绑死一套固定的标签。团队在 ScienceWorld 基准上演示了“自带词表”的路子:给科学任务定义一套自己的标签(比如 instr.task.goal、data.state.room),再在 LLMON 模型上训一个 LoRA,模型就能用新词表做规划、一步步下指令。工具调用 Agent 的例子也有对应的 notebook。换句话说,它既可以当现成的防注入方案用,也可以当一套可扩展的结构化接口来玩。
但要提醒一句:这仍然是实验预览版,官方原话是“ready for exploration and evaluation but not for production”,也就是能探索、能评估,别直接上生产。
小杜点评
LLMON 最有意思的地方不是那张接近满分的柱状图,而是它换了一种思路:别再教模型“猜”哪句是命令,直接在输入格式里把命令和材料分开,让“只执行被点名的指令”变成一种结构上的默认。这有点像当年从字符串拼接 SQL 转向参数化查询——安全不是靠模型更聪明,而是靠接口本身不给混淆留位置。
对做 RAG 和 Agent 的工程师来说,它最直接的价值在两类场景:一是检索内容不可信的问答和摘要,二是工具返回不可控的多步 Agent。这两处正是今天间接注入的重灾区,而 LLMON 的两个预览模型只有 3B 和 8B,小到可以本地跑,试错成本很低。
但也要冷静两点。第一,静态注入被防住,不等于多轮自适应攻击也被防住,IBM 自己都还在攻这一块;第二,这是“学出来的规则”,不是沙箱那样的硬保证,模型卡写得很明白,不能当唯一防线。正确的姿势是把它当成纵深防御里的一层,叠在输入清洗、工具权限收紧和输出校验之上。等它从预览转正、支持的模型变多之后,再考虑往生产管线里放。
参考来源
- IBM Granite 团队官方博客:LLMON: An LLM-Native Markup Language, now in Granite 4.1 3B and 8B — https://huggingface.co/blog/ibm-granite/llmon-an-llm-native-markup-language-now-in-granite
- 配套论文 Post-Training Large Language Models with LLMON(arXiv:2610.38120)— https://arxiv.org/abs/2610.38120
- LLMON 原始论文(arXiv:2603.22519)— https://arxiv.org/abs/2603.22519
- GitHub 工具库 — https://github.com/generative-computing/llmon
- Unite.ai:IBM Releases Granite Models Designed to Resist Prompt Injection — https://www.unite.ai/ibm-releases-granite-models-designed-to-resist-prompt-injection/