GitHub 工程博客在 2026 年 11 月 5 日(UTC 20:23,东京时间 11 月 6 日 05:23)发了一篇长文,讲清楚了上周 GitHub Universe 上宣布的新 Git 存储架构,代号 Project Rubicon。官方给出的内部测试数字是:单个仓库同时有 5,000 个 Agent 在干活、每秒 7,200 次 push,读请求延迟依然很低。这个目标是冲着「Agent 把一个仓库变得又大又忙」来的,对做 Agent 编程平台或 Git 基础设施的人,里面的设计取舍很值得看。
为什么要重做:Agent 让单仓库变成高并发写入
GitHub 把规模拆成两个方向:横向是仓库很多,纵向是一个仓库里人和 Agent 很多。文章说,今天 GitHub.com 最忙的仓库,写入也就是一秒钟几十次、而且集中在短时间爆发;但随着更多工作交给全天候并行的 Agent,他们预计一年内这种爆发会变成持续速率。每次 push 还会带来 CI、部署和其它 Agent 拉取的读流量,读放大跟着写入一起涨。文中还提到,某个仓库从 3 月到 5 月每日请求量涨了约 4 倍,之后仍是指数增长。
所以团队没有只规划下一档,而是把目标定在「至少再高两个数量级」:单仓库要能接受每秒数千次写入、支持多个写入节点、尽量压低提交延迟,同时保持读取廉价。
核心思路:只有引用更新需要共识
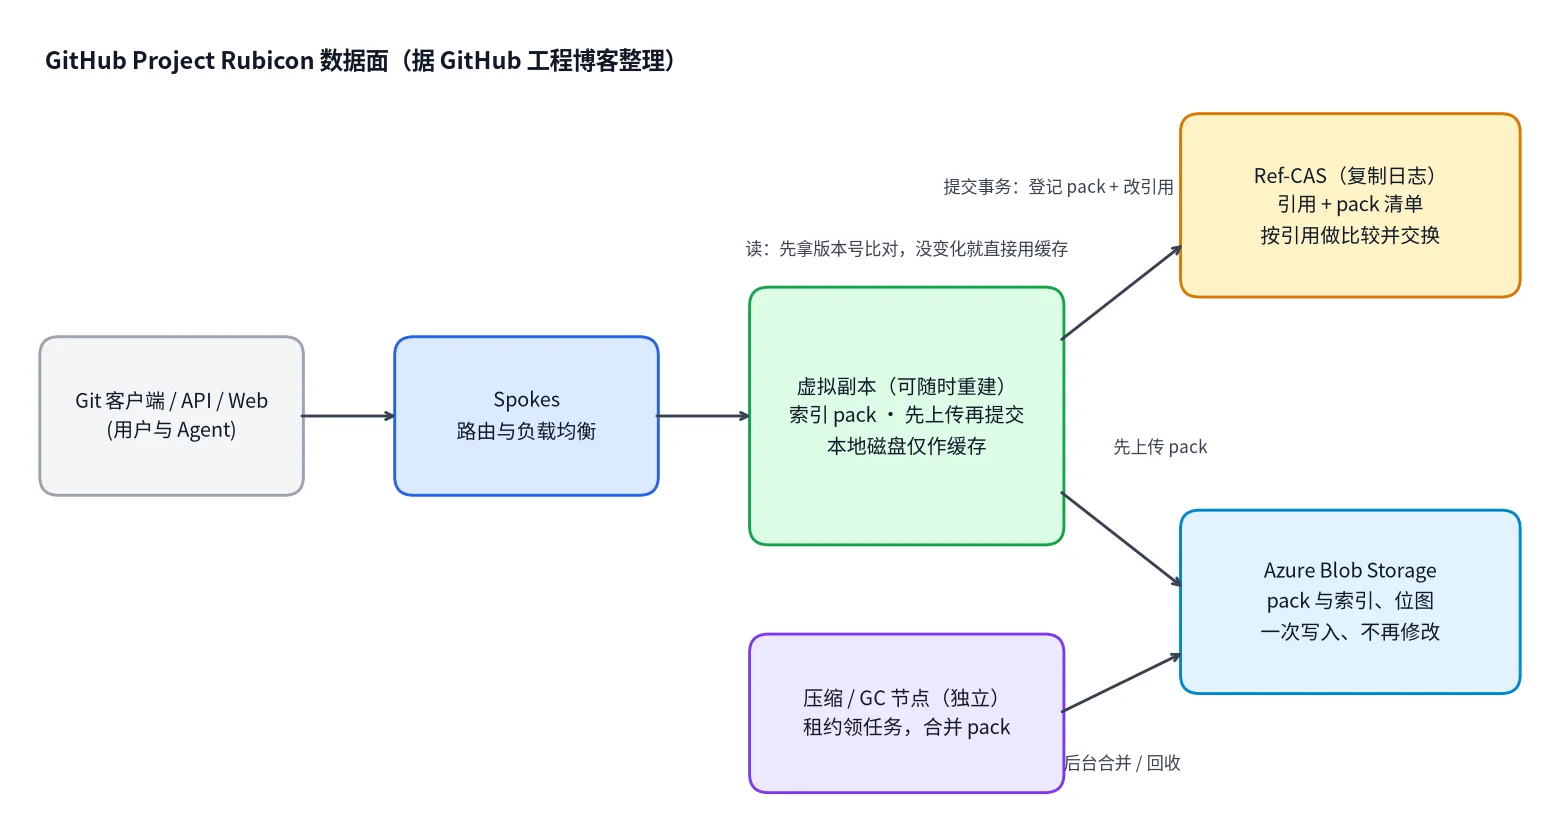
整个设计建立在一个观察上:Git 对象是不可变、按内容命名的,两个写入者可以同时存同一份数据而不需要协商;真正需要达成一致的只有引用(分支指向哪个提交)更新,而且这部分数据很小。基于此,Rubicon 把原本紧耦合的几件事拆开:
- Git 对象放 Azure Blob Storage:pack 和索引、位图等读加速数据都在这里,基本是一次写入、不再修改,很适合对象存储。
- 引用和 pack 清单放 Ref-CAS:这是一个专门做引用的复制日志服务,每次引用更新是一次由多数派提交的比较并交换(CAS),事务只锁它碰到的引用。Agent 多数推自己的分支,大多数更新并不冲突,可以并行复制;两次 push 改同一个引用时,只有一个会成功。
- 虚拟副本(virtual replica):一组可随时丢弃的计算节点,本地磁盘只是缓存,可以随时重建;仓库变忙就加副本。
写入路径是:虚拟副本先给 push 的 pack 建索引并上传到 Blob,再向 Ref-CAS 提交一个事务,把 pack 登记进清单并更新引用。读取路径是:副本带着自己已知的引用版本号去问 Ref-CAS,没变化就什么引用都不用返回,一次比较就结束;落后了才拿回最新引用和 pack 指针,再从 Blob 拉需要的 pack 进缓存。
一个值得抄的细节:先试了两种「全放对象存储」
文章坦诚写了两个被放弃的方案。第一种是用一个 blob 做全部引用的预写日志,每次更新都是对这个 blob 的条件写,读很便宜,但同一时刻只能有一个条件写在途,写吞吐大约只有每秒几百次。第二种把引用按哈希分到多个分段 blob,写可以并行了,但读要检查所有分段、取决于最慢的那个,而读比写多几个数量级,等于拿读延迟换了写延迟。两种都不满足需求,才有了专用的 Ref-CAS。官方称 Ref-CAS 单独处理引用状态可以做到每秒数万次操作。
另外,Ref-CAS 不存对象数据,只存指针;副本一定是先把 pack 传上 Blob 再提交引用事务,所以引用永远只会指向已经持久化的对象。
压缩和垃圾回收:从服务节点里搬出去
每次 push 都会往 Blob 里加一个 pack,pack 越多查询越慢。旧架构里压缩跑在提供服务的副本上、每个副本都要跑一遍;新架构把它挪到独立的压缩节点,直接对着 Blob 和 Ref-CAS 干活,副本的 CPU 和内存几乎都留给请求。每个节点通过租约认领一个分片,按 pack 数量、大小或时间封存一个「开放段」,合并成更少更大的 pack,发布前先校验新旧 pack 对象集合完全一致,再分两步更新清单、之后清理旧 pack。官方称这样在写入量上升时能保持 pack 数量基本持平、延迟曲线保持平坦;垃圾回收用类似的专用 worker,细节留到后续文章。
对开发者意味着什么
先说清边界:这是 GitHub 的内部存储架构,文章没有给出可以自己部署的代码、API 或迁移步骤,目前也只是有限私有预览,计划明年初更大范围铺开;那组 5,000 Agent、7,200 push/秒的数字是 GitHub 内部测试,不是第三方评测。对普通用户来说,push、fetch、建分支的方式不变,保护规则也保持不变。
文章还预告了几个面向 Agent 的后续方向:不用 clone 直接从服务端读几个文件、一次原子提交多个文件的 commit API、面向变更的事件流,以及部分副本、物化视图等。如果你在做 Agent 并行改代码的平台,这些接口值得提前留意。
小杜点评
我觉得这篇的价值不在那两个大数字,而在设计思路:把「必须有序」的那一点点状态(引用)单独拎出来,用小型共识组处理,其余全部做成不可变对象加无状态计算,再把压缩、GC 这类后台重活挪出请求路径。这个套路对我们做 Agent 平台的人是通用的:高并发的 Agent 任务,先问哪一部分状态真的需要强一致,其它交给对象存储和可重建的缓存。建议如果你的团队也在让多个 Agent 往同一个仓库推代码,可以先观察自己的瓶颈是写入、读放大还是后台维护,再决定要不要做类似拆分;同时对厂商自测数字保持一点距离,等私有预览放开后再看真实表现。