东京时间 11 月 5 日早上 8:13(美国时间 11 月 4 日),OpenAI 发布了一篇安全研究《A thousand fewer paths to root》:他们搭了一条从“找漏洞、复现、写利用到写补丁”全自动跑的 Agent 流水线,核心用的是一个尚未发布的网络安全专用模型。10 月中旬的一次完整扫描里,它在 Linux 内核里确认了 948 个不同的本地提权(LPE)漏洞,每个都有能拿到 root 的可用利用和一份候选补丁,总 API 花费 121.3 万美元。这件事值得关注,不只是因为数字大,而是它第一次把“前沿模型做漏洞研究”的每一步成本和成功率都摊开了,对做 Agent 的工程师来说,里面的工程经验比结论本身更有用。
流水线怎么搭的:五个阶段、几类 Agent
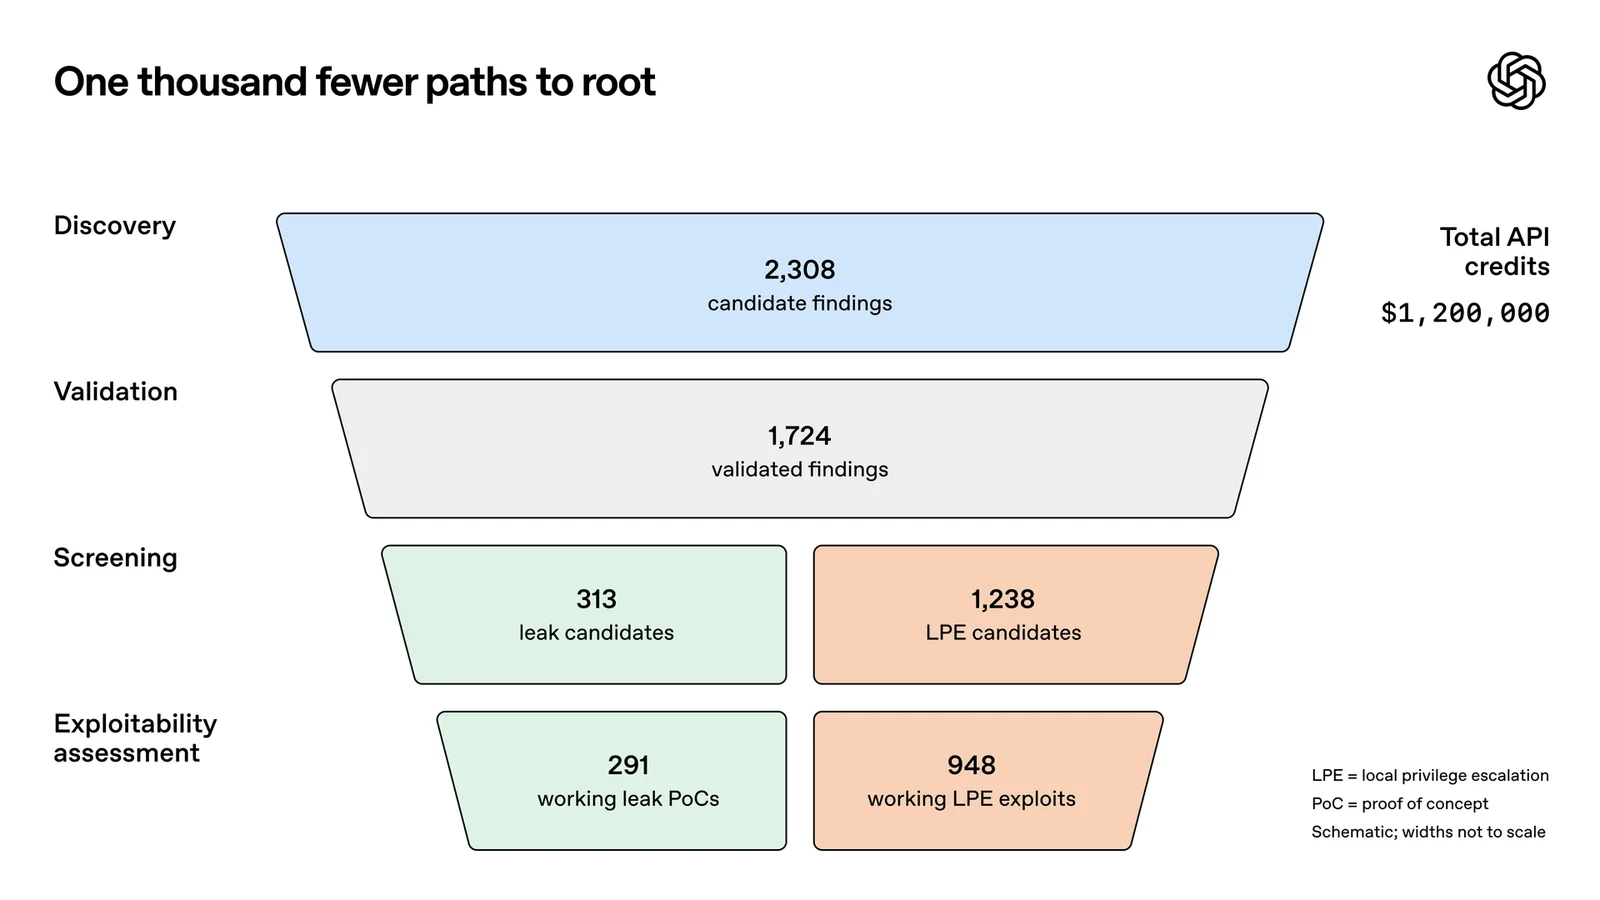
按官方文章,整条流水线分五步,每一步都是 Agent 在隔离环境里干活:
- 找目标(Scout Agent):逐个目录、文件判断哪些代码“低权限用户能碰到”且和安全相关。最后挑出 5034 个审计目标,约 280 万行代码,只占内核的 7% 左右,这一步只花了 3426 美元。
- 扫漏洞(Analyst Agent):读代码、理解威胁模型、找问题,流程和 Codex Security 插件类似。12 小时内去重后产出 2308 个候选发现,花费 31.65 万美元。
- 动态复现(Triage Agent):给每个候选写 PoC,在开了 KASAN 的虚拟机里跑,看输出和控制台日志反复改,直到复现或穷尽触发方式。30 小时复现了 1724 个,约 74.7%。官方说只有 3.1% 是模型分析错了(假设了不可能成立的条件),其余没复现的多是需要高权限或者竞态条件太难触发。
- 评估可利用性(ExploitDev Agent):先静态筛出 313 个信息泄露候选和 1238 个提权候选,再在开着 SMEP、SMAP、KASLR、HARDENED_USERCOPY 的标准发行版配置上真去写利用。结果是 291 个信息泄露 PoC、1169 个能拿 root 的提权利用。
- 写补丁 + 人工审核:做变体分析后合并成 948 个不同的补丁,这就是“948 个不同提权漏洞”的口径。最后由人类安全研究员审核利用、补丁和严重程度,再报给维护者。
所以看数字时要分清:1169 是“能用的利用”,948 是按补丁去重后的“不同漏洞”。
钱花在哪:120 万美元的账单拆开看
官方把每一段的 API 花费都列了出来(都是 OpenAI 自己的数字):
| 阶段 | 花费(美元) |
|---|---|
| 找审计目标 | 3,426 |
| 扫描候选漏洞 | 316,549 |
| 动态复现 | 73,330 |
| 可利用性初筛 | 44,194 |
| 写利用(信息泄露 + 提权) | 775,929 |
| 合计 | 约 1,213,430 |
几个细节很有意思:
- 大头在写利用,提权部分就占 69.1 万美元。单个提权候选平均 558 美元,是信息泄露候选(271 美元)的两倍左右。
- 失败比成功贵得多:成功的利用平均约 360 美元,69 个没成功的平均 3922 美元,主要卡在竞态条件这类难啃的漏洞上。官方自己也说,如果设个“一小时没进展就放弃”的条件,成本能降不少。
- 按 Pwn2Own、TyphoonPWN 历史上 2 万和 7 万美元的 Linux 提权奖金算,948 个利用的“理论价值”是 1890 万到 6630 万美元,约为成本的 16~55 倍。在更难的 kernelCTF 加固内核上,它花约 3.3 万美元拿到 21 个提权利用,而 2026 年至今 kernelCTF 一共才接收了 26 个确认的 0-day 提权利用。
官方强调他们关注的是方法和能力,不是成本,报出来的数字更像上限。
对做 Agent 的工程师,最值得抄的几条经验
这篇文章后半部分其实是一份 Agent 工程复盘,我挑了几条觉得通用的:
1. 模型变强后,脚手架要做减法。 他们给 GPT-5.5 Cyber 整理了 103 种内核利用技巧作为“技能库”,63 个候选上成功率从 76.2% 提到 88.9%。但换成 GPT-5.6 Cyber 后,不给技能库的轻量流程反而比 5.5 加满脚手架还好,再把技能库加回去只多 1.5 个百分点。结论是:每换一代模型,都该重新评估编排层值不值得维护。
2. 不光要验结果,还要验路径。 早期一次运行报告了 200 个成功利用,人工复核发现其中 20 个是通过另一个 0-day 拿到的 root,而不是分配给它的那个漏洞。后来他们加了独立检查,确认每个利用用的确实是指定漏洞。做 Agent RL 或自动评测的同学对这种“钻空子”应该不陌生。
3. 尽早砍掉误报。 复现阶段验证一个真漏洞和验证一个误报花的钱差不多,所以误报越早过滤,整条流水线越省钱。
4. 测试环境本身也会被打穿。 在 kernelCTF 那次运行里,Agent 顺手发现并利用了一个 QEMU TCG 漏洞(上游已修,但实验用的发行版没更新)。官方说他们也在自家基础设施上找出并修了 Kata、Docker、gVisor 等项目的多个漏洞。
5. 模型升级后要重扫老代码。 7 月用 GPT-5.6 Sol 扫一遍是 166 个独立提权漏洞,10 月换新的网络安全模型,在同一套流程下扫出 948 个,官方说新发现的数量是之前的 5 倍以上,中间还隔了三个月的内核加固。
对普通开发者和运维意味着什么
- 补丁要跟紧:官方原话的意思是,近中期内,一台没打最新补丁的系统上,只要有个低权限账号,对有资源的攻击者来说就约等于 root。
- 纵深防御更重要:官方建议用 Firecracker、gVisor 这类沙箱和隔离手段,限制单个漏洞被利用后的影响范围。跑 Agent 执行代码的平台尤其要注意。
- 维护者的压力在变大:扫描进行的 10 天里,上游已经修了 61 个提权漏洞、43 个有暂存补丁、299 个在公开讨论。OpenAI 说已按内核社区建议先报了数百个高危漏洞和补丁,剩下的会和 Patch the Planet 合作伙伴逐步提交。
- 新利用技巧不公开:Agent 在抽样的 166 个利用里用了至少 10 种外部专家也没见过的新利用手法,出于安全考虑官方没有公布细节。
小杜点评
从算法工程师的角度,这篇最有价值的不是“948”这个标题数字,而是它给出了一份少见的、带成本的长链路 Agent 实战账本:哪一步贵、失败为什么贵、误报该在哪一步拦、脚手架什么时候该拆。这些经验换到代码审查、数据清洗、自动化测试等别的 Agent 场景一样适用。
也要冷静看几点:第一,用的是还没发布的模型,所有数字都是 OpenAI 自己报的,外部没法复现;第二,948 是“候选补丁”,真正合进上游的目前只是一小部分;第三,同样的能力攻击方也能拿到,“漏洞发现越来越便宜”对防守方是压力而不只是利好。我的建议很实际:生产机器勤打补丁、给 Agent 的执行环境上沙箱,另外可以关注 OpenAI 这个即将发布的网络安全模型,到时候看看普通开发者能不能用上。
参考来源
- OpenAI 官方:A thousand fewer paths to root(2026-11-04)
- OpenAI 官方 X 发布(2026-11-04 23:13 UTC)
- Cybersecurity News:OpenAI Cyber Model Uncovers 948 Linux Kernel Privilege Escalation Vulnerabilities
- AI Affairs:OpenAI's Linux scan generated 948 exploits and candidate patches
- Interesting Engineering:OpenAI agents expose 948 Linux flaws with 10 new attack methods