微软 365 断了约 18 小时后大面积恢复:Outlook、Teams、Copilot 陆续回来,微软道歉并认了原因——早前一次网络容量升级埋下的缺陷,被最近一次网络变更触发,跟黑客和 AI 都无关。底层问题已修好,但仍有部分用户收信延迟、全面恢复还没给时间表。
从美洲的邮箱开始,到全球服务降级
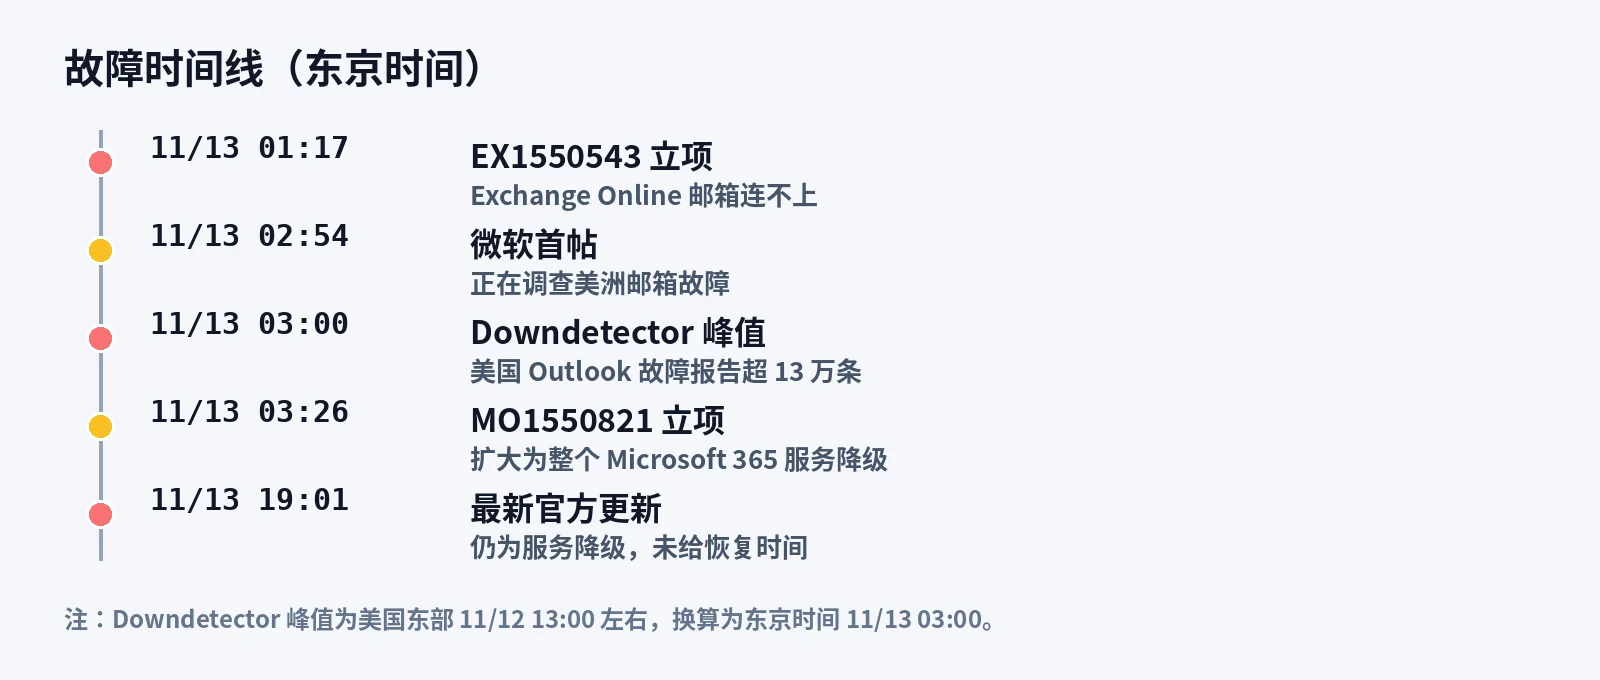
事情是从一小撮邮箱开始的。按微软服务健康记录,Exchange Online 的故障编号 EX1550543,官方开始时间是 11 月 12 日 16:17 UTC(东京时间 11 月 13 日 1:17)。微软 365 状态账号在 X 上的第一条帖子是 17:54 UTC(东京时间 2:54),说正在调查「美洲用户无法通过多种方式访问 Exchange Online 邮箱」的问题。
但范围扩得很快。13 分钟后微软就改口:可能影响「任何地区」的 Microsoft 365 连接。18:26 UTC(东京时间 3:26),更广的 Microsoft 365 故障 MO1550821 也立了项。美国东部时间 12 日下午 1 点左右,故障报告网站 Downdetector 上美国 Outlook 的故障报告峰值超过 13 万条,Microsoft 365 相关报告超过 3.8 万条,Teams 约 4500 条。
微软的修复从一开始就不顺利。12 日晚些时候,微软说已把一部分服务器恢复上线,「目前保持稳定」,部分地区出现有限恢复。但到 13 日 0:06 UTC(东京时间 9:06)的更新,画风变了:恢复上线的服务器一接到流量又会再次无响应。微软只好一边限流、一边用旧配置重建一部分服务器做测试。13 日 4:10 UTC(东京时间 13:10)的更新说,做了流量协议调整、流量重分配和「策略性流量拦截」之后,部分地区出现局部恢复,但「没有带来持续的恢复」。
到笔者核查的 13 日 19:59 JST,微软状态页的最新更新停在 10:01 UTC(19:01 JST),原文是:恢复工作分阶段推进,全球遥测和用户报告显示多个工作负载有增量改善,「但服务健康状况仍然不稳定,容量尚未完全恢复到基线」。下一次更新预定在 11:00 UTC(20:00 JST)。也就是说,写这篇文章的时候,故障仍在持续。
到底坏了什么:不只是 Outlook
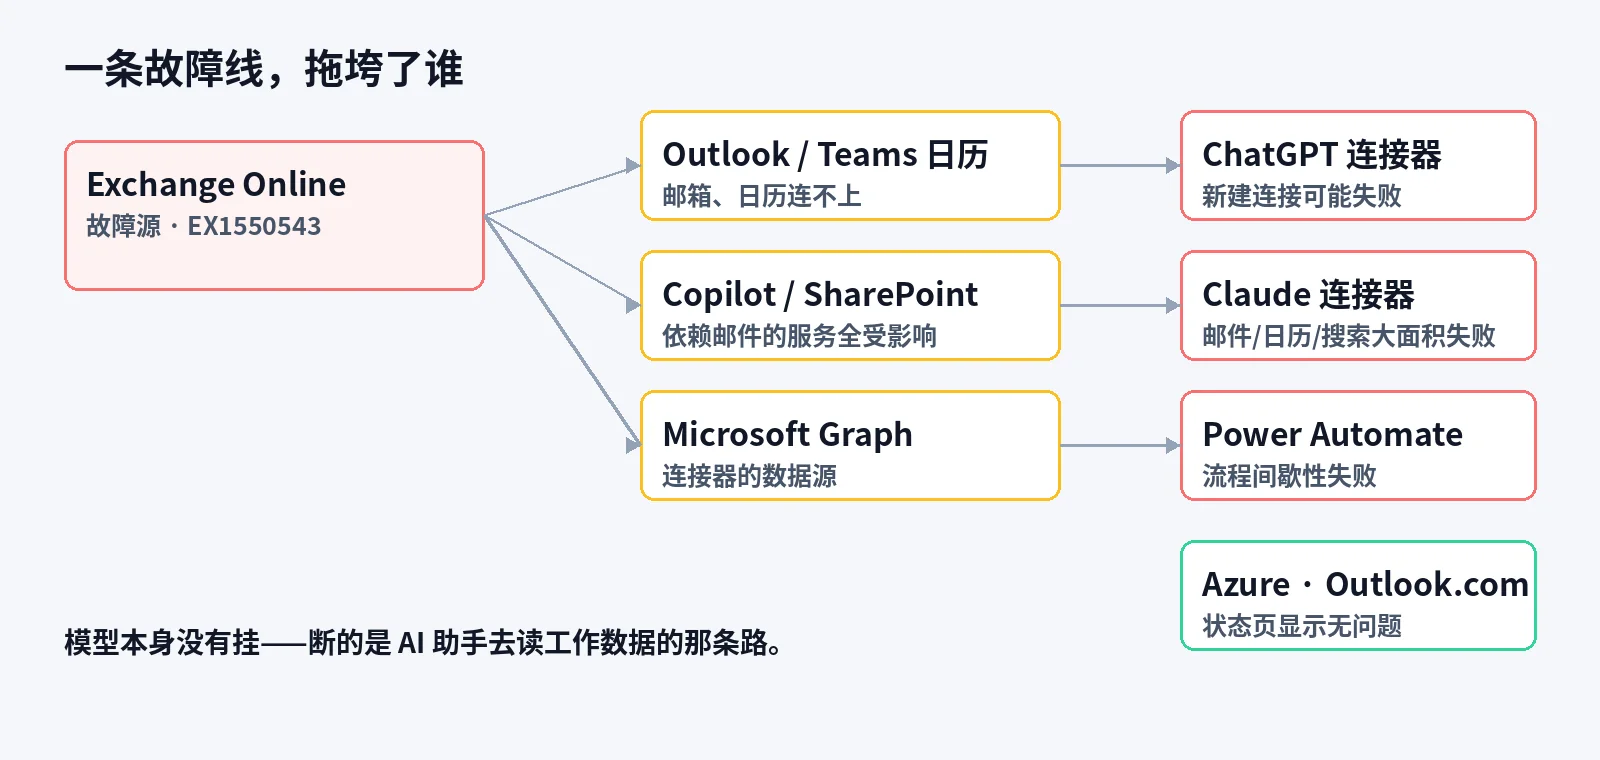
这次故障的范围比「Outlook 打不开」要宽得多。根据微软状态页,仍在受影响之列的有:Exchange Online(Outlook 网页版、桌面版 MAPI、Exchange ActiveSync、REST 连接都可能连不上邮箱,邮件投递可能延迟)、Microsoft 365 管理中心、Microsoft 365 应用、Microsoft Copilot 365、Defender for Office 365 与 Defender XDR、Microsoft Fabric、Microsoft Graph、Intune、Planner、Power Apps、Purview、Teams、To Do、Power BI、SharePoint Online、Universal Print、Windows 365。
有意思的是「没坏」的部分同样值得注意。Azure 的状态页全程显示「未检测到问题」,个人版 Outlook.com 和消费级 Copilot 应用也被列为正常。这次倒的,准确说是企业版 Microsoft 365 里依赖 Exchange Online 的那一层——邮件和日历是地基,地基一晃,上面一整排服务都跟着晃。
另外还有一个容易被忽略的编号:PP1550869。依赖 Microsoft Graph 的 Power Automate 流程和 Copilot Studio 连接器也出现间歇性失败。也就是说,不只是人在用的应用,连自动化流程和企业里跑的 Agent 也受了影响。
微软查到了什么:服务器莫名其妙掉线,不是流量洪峰
关于原因,微软目前的说法有这么几层。第一,这不是外部流量冲击。微软明确表示,负载升高「不是由流量增加驱动的,而是一些服务器意外不可用」,剩下的服务器被迫扛下更多负载后跟着出问题。第二,微软提到,受影响服务器上一个处理安全连接的进程会被压垮,随后服务器停止响应。第三,微软正在调查一次近期的网络配置变更是否与故障有关——这次变更的时间点与故障开始时间重合。
但到截稿时,微软仍然没有公布根本原因,也没有给出完全恢复的预计时间。它同时声明「目前没有证据表明存在与此事件相关的恶意活动」,并承诺在完全缓解后发布一份事后报告,包含根本原因和纵深防御措施。微软还冻结了整个云基础设施的软件部署,并开始回滚配置做测试。
为保护邮件,微软采取了一个少见的措施:把邮件超时窗口延长到 48 小时,并优先处理队列和积压邮件。意思是故障期间发出的邮件是延迟了,不是丢了——微软在用 48 小时这个缓冲期给自己争取恢复时间。
AI 也被波及:ChatGPT 和 Claude 的连接器断了
这次故障最值得 AI 从业者留意的部分,是它顺带暴露了 AI 助手对办公套件的依赖有多深。
OpenAI 的状态页报告,ChatGPT 的 Microsoft 365 连接器出现错误升高:新建连接可能失败,部分工具无法正常工作。Anthropic 的状态页说得更具体:通过 Microsoft 365 连接器发起的邮件、日历和搜索请求,大部分都在失败,Outlook 里的 Claude 也受了影响。Anthropic 还把原因归为「外部服务提供商的问题」。
这里要澄清一个很容易被误读的点:ChatGPT 和 Claude 本身没有挂。聊天、生成、推理都正常,断掉的是它们去读你工作数据的那条路——连接器。连接器的工作方式是:经你授权后,AI 助手通过 Microsoft Graph 去 Outlook 邮箱、Teams 聊天、日历和 SharePoint 文档里找信息。Exchange Online 一倒,Graph 后面的数据源就断了,连接器自然跟着报错。
这件事的讽刺意味在于时间点:就在前一天,Anthropic 刚发布了 Claude 的办公套件,Meta 的 Muse 也刚向付费用户开放了代打电话。AI 助手正在加速钻进企业的工作流——读邮件、排日程、接电话。结果第二天,底层办公套件一出故障,这些刚长出来的能力立刻就被证明是「有条件的」:它们的好用程度,取决于你根本不拥有的那层基础设施。
微软在怎么抢修
从微软的更新里,能拼出一套典型的「救火组合拳」:加虚拟机容量、调整流量协议、重分配流量、策略性限流、用旧配置重建部分服务器、冻结全网软件部署、回滚可疑的网络变更。恢复是分阶段、按地区推进的,部分地区先好转,但整体上「好了又坏」,始终没有进入持续恢复。
这套打法本身没有新鲜事,真正值得注意的是它暴露的现实:对 Exchange Online 这种量级的服务来说,「加容量」不是一键就能解决的事。微软自己也承认,恢复上线的服务器一接到真实流量就可能再次失活——这说明问题不在容量数字本身,而在服务器回到服务状态后仍然过不了健康检查,或者一过健康检查就被流量压垮。在找到并消除那个触发点之前,加多少机器都只是续命。
给工程师的启示:你的 Agent 也要会「断网」
这次故障对做 AI 应用的人有三点直接的启示。
第一,连接器是单点依赖,要当成会断的东西来设计。ChatGPT 和 Claude 的 Microsoft 365 连接器没有本地缓存、没有降级路径,数据源一断就直接报错。对企业里正在落地的 Agent 来说,连接器断掉时的行为——是明确报错、还是静默编造、还是用缓存顶上——应该在设计文档里写清楚,而不是等故障来教训你。
第二,区分「模型挂了」和「数据源挂了」。这次很多媒体标题写成「Claude 宕机」,实际是连接器故障。做监控的人应该把模型可用性、连接器可用性和数据源可用性拆成三条独立的健康指标,否则一次 Exchange 故障会让你误判成模型故障,修错方向。
第三,关键路径上的超时和重试策略值得重新算一遍。微软把邮件超时窗口延长到 48 小时,这个数字本身就是一种表态:它预计恢复可能要以「天」为单位。你的系统里如果有依赖外部办公套件的任务队列,超时、重试间隔和积压上限是不是也按「天」这个量级设计过?如果没有,这次就是一次免费的压力测试。
小杜点评
微软 365 这次的故障,技术上并不「高级」:服务器掉线、健康检查失败、流量压垮剩下的节点,最后演变成全球服务降级。高级的是它的波及面——从 Outlook 到 Copilot,从 Power Automate 到 ChatGPT 和 Claude 的连接器,一条 Exchange Online 的故障线,能把半个企业数字化栈和一整排 AI 助手同时拉下水。
AI 助手正在越长越深地扎进企业工作流,这本来是好事。但这次故障提醒我们:助手的能力边界,不只是模型说了算,更是它脚下的基础设施说了算。做 Agent 的人,下一份架构图里,除了模型、工具和提示词,最好再画一条「当 Microsoft 365 挂掉时,我的系统会发生什么」。如果答不上来,那这条依赖就是你系统里的一颗定时炸弹——而今天,它刚好炸了。
参考来源
- 微软官方服务状态页 status.cloud.microsoft(2026-11-13 19:59 JST 核查:Microsoft 365 仍为 Service degradation,Azure 无问题;最新更新 10:01 UTC)
- Microsoft 365 Status(@MSFT365Status)官方 X 账号,2026-11-12 至 11-13 更新(EX1550543、MO1550821)
- OpenAI 状态页:Microsoft 365 连接器错误升高
- Anthropic 状态页:Microsoft 365 连接器邮件、日历、搜索请求大面积失败,Claude for Outlook 受影响
- 路透社 / 美联社经 Chosun Biz 转引:Downdetector 美国 Outlook 故障报告峰值超 13 万条
- StatusStack:Microsoft 365 与 Exchange Online 故障时间线(EX1550543 始于 11:17 ET,MO1550821 始于 13:26 ET)
更正说明
2026 年 11 月 14 日更正:本文初版写于 2026 年 11 月 13 日 20:00(JST),当时故障仍在持续,标题称「断了 19 小时还没修好」,正文开头称「没有恢复时间,也没有根本原因」。随后微软更新了情况:故障在持续约 18 小时后大面积恢复,底层问题已修好,原因是早前一次网络容量升级埋下的缺陷被最近一次网络变更触发,与黑客和 AI 无关;但仍有部分用户收信延迟,EX1550543 / MO1550821 仍列为未关闭的降级事件,全面恢复暂无时间表。现已按最新情况修正标题、正文开头及 SEO;正文其余部分为 11 月 13 日当晚的经过记录,未作改动。