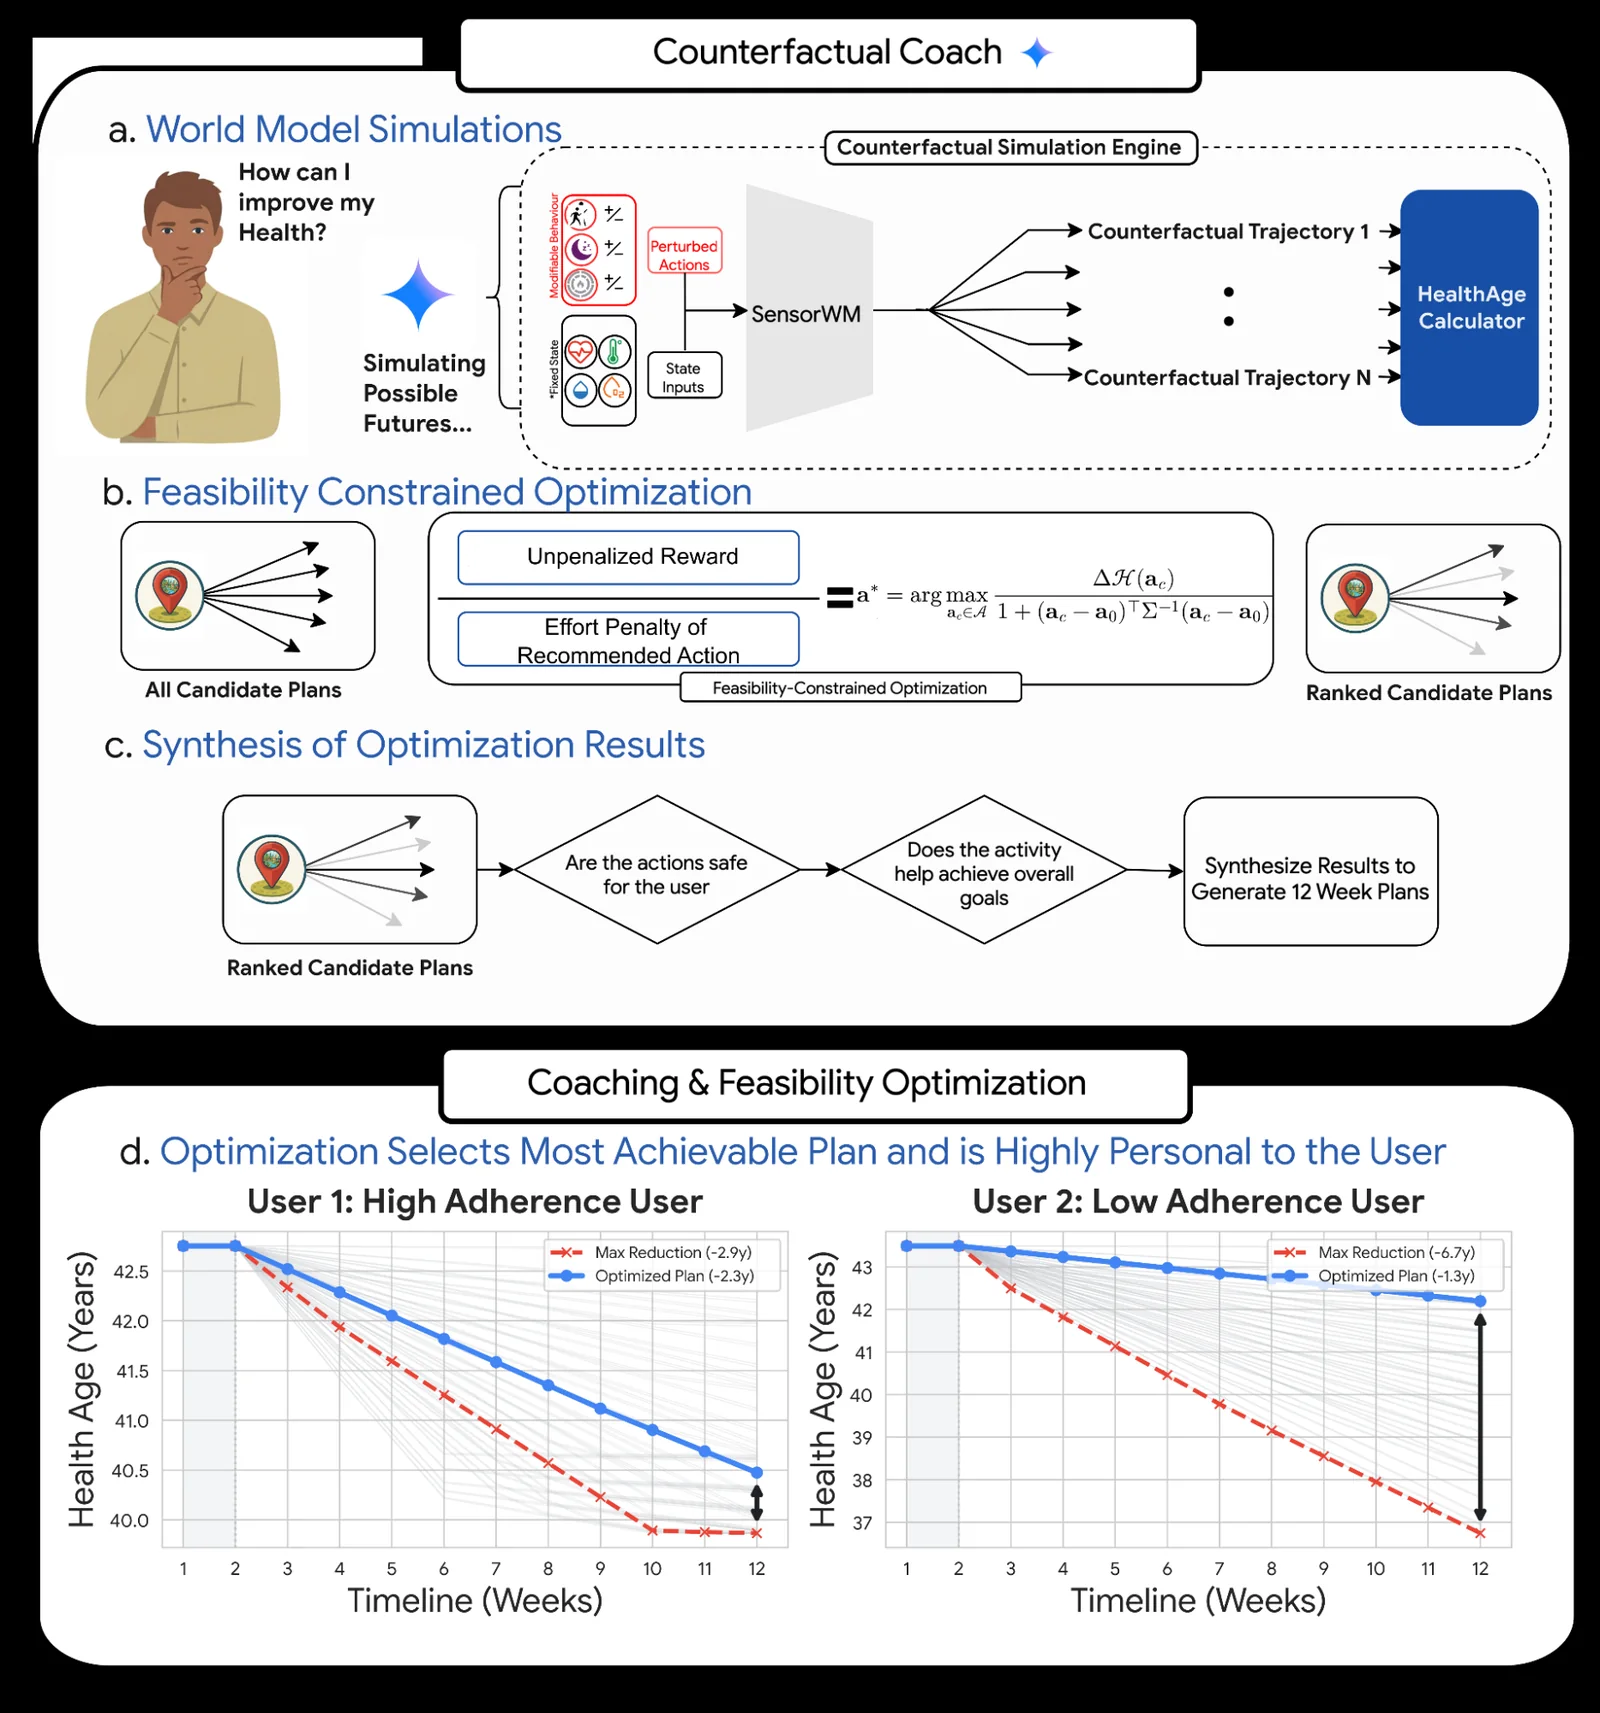
Google Research 在 11 月 12 日凌晨(东京时间)发布了一组新研究,讲的是怎么让手表从「记账本」变成「教练」:先根据你每天的步数、睡眠、静息心率算出一个「健康年龄」,再用一个叫 SensorWM 的世界模型模拟「如果接下来 12 周多走路、早睡觉,你的身体会变成什么样」,最后由一个语言模型把模拟结果翻译成一份 12 周的运动和作息计划。
这事值得算法工程师注意,不是因为它能让你「年轻几岁」,而是它把三件平时各干各的事拼在了一起:可解释的健康指标、动作条件世界模型、以及被模拟结果锚住的 LLM 智能体。而且验证做得相当扎实:两篇论文、228 万人周的训练数据、All of Us 项目 2.2 万人的 8 年随访、5 位生活方式教练加 5 位医生的双盲评审。
「健康年龄」:不猜你几岁,只算你能改什么
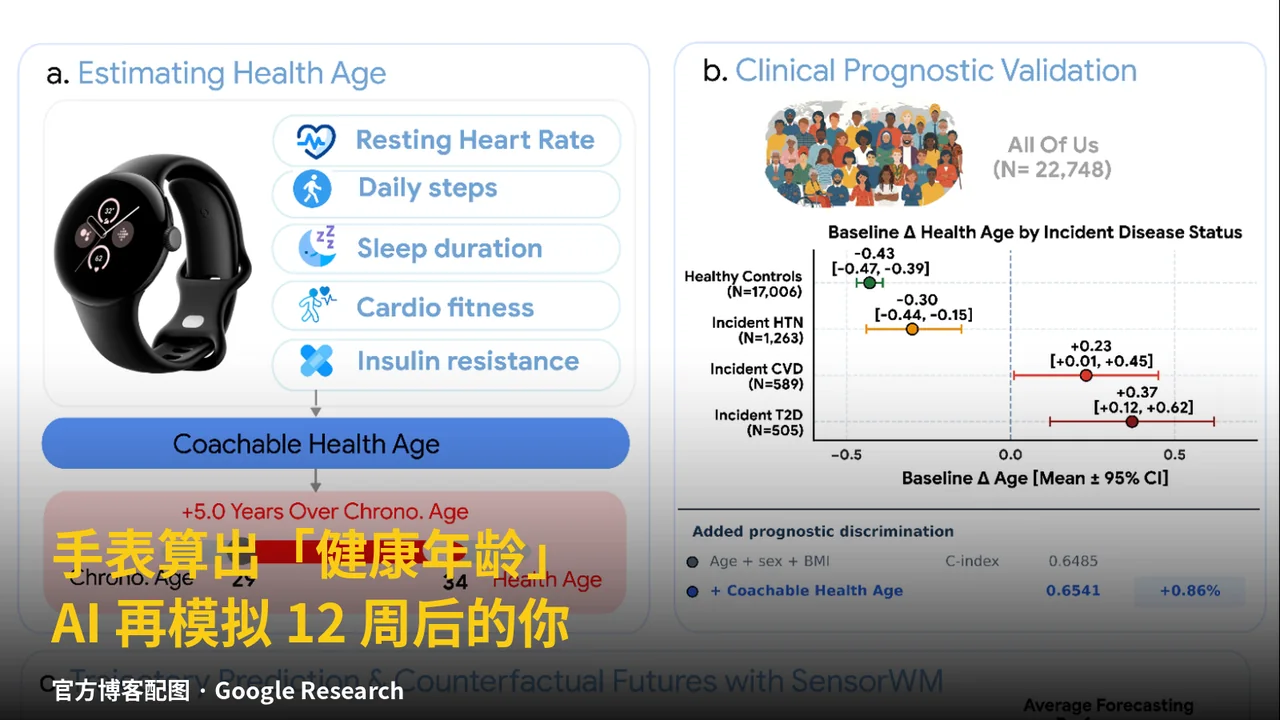
很多「生物年龄」模型有个毛病:它们训练的目标是猜你的出生年份,于是模型会盯住那些你改不了的特征,最后给出的数字除了焦虑没什么用。Google 这次反其道而行之,提出了一个「可教练健康年龄」(Coachable Health Age,CHA):只用你能通过日常行为改变的信号来算。
核心输入是手表本来就能被动采集的四项:静息心率、每日步数、睡眠时长、每周 Active Zone Minutes(中高强度活动分钟数);有条件时再加上最大摄氧量、睡眠规律性、胰岛素抵抗等指标。模型先按流行病学研究把这些信号和心肺代谢疾病风险挂钩,再用数学方法消除信号之间的重叠——比如爱运动的人往往静息心率更低、睡得更好——让每个习惯贡献自己独立的那份影响。
最后输出的是一个「健康年龄差」:CHA 减去你的实际年龄。负 3 岁,意思是你的生理画像看起来比同龄人年轻 3 岁;正数则表示加速老化。这个数字的好处是它只由可改变的行为驱动,动起来、睡好觉,数字真的会动。
验证分了三条线。第一条是预测未来疾病:在 All of Us 研究项目里,22748 名佩戴 Fitbit 并贡献了电子健康记录的参与者、累计超过 6.8 万人年的随访中,基线健康年龄比实际年龄大的人,未来 8 年里得高血压、心血管疾病或 2 型糖尿病的概率显著更高;把 CHA 加进年龄、性别、BMI 这些标准临床指标之后,疾病风险预测能力进一步提升,在 50 岁以下人群里提升最明显。第二条是纵向追踪:1464 人的 Fitbit 队列,连续两年、每 3 个月一个窗口,能持续改变习惯的人,健康年龄真的降下来了。第三条是和临床对齐:在 WEAR-ME 研究中,CHA 与美国心脏协会的 Life's Essential 8 心血管健康评分、代谢综合征严重程度评分的相关性,都好于那些只会猜出生年份的「年龄时钟」。
SensorWM:一个会回答「如果……会怎样」的世界模型
知道自己的健康年龄只是起点。真正难的问题是反事实的:「如果我每天多走 3000 步、早睡半小时,12 周后身体会怎样?哪种方案我最可能坚持?」静态公式答不了这个,因为身体是个连锁反应的系统——持续运动几周后,静息心率和心率变异性会慢慢变好,进而带来更多好处。
Google 的答案是 SensorWM,一个动作条件世界模型。它在约 10 万名 Fitbit 用户的 228 万人周去标识化数据上自回归预训练:输入某人前两周的可穿戴数据,就能预测接下来 12 周里 20 项生理指标在不同日常步数、睡眠和有氧安排下的演变。论文里给出的平均 R² 是 0.664,超过了通用时间序列基础模型 TimesFM(0.513),也超过了「用最近值外推」(LOCF,0.503)和「取 4 周均值」(0.413)这些基线;更重要的是,它保留了与糖尿病、高血压、胰岛素抵抗相关的临床模式,没有为了拟合数字把医学规律拟合丢。
有了会模拟的模型,剩下的就是规划。系统先让 SensorWM 对每个人滚出 125 种候选的 12 周习惯组合,再用一个「可行性约束优化器」筛掉那些看着很美、但你根本坚持不下来的方案:优化目标是健康年龄的预期降幅除以「偏离你现有习惯的代价」,习惯弹性高的人会拿到更激进的目标(比如降 2.3 岁),日常安排紧张的人则拿到温和的版本(比如降 1.3 岁)。最后,一个语言模型教练把排名靠前的路径写成一份循序渐进的 12 周计划。
医生和教练的双盲评审:有模拟打底的计划,赢了
这套流程最值得学的地方是评估方式。团队没有只报离线指标,而是做了一场双盲对照:5 位认证生活方式教练和 5 位执业医生,对 49 个不同行为画像、总计 490 组配对评审,把「有反事实模拟打底的计划」和「同一个语言模型只看可穿戴历史、直接生成的通用计划」放在一起比;另外还在整个 WEAR-ME 队列(2780 人)上做了自动化评估。
结果是:教练在 71.4% 的评审中把模拟打底的计划评为最佳整体方案(p < 0.001),在 71.0% 的评审中认为它更可能带来长期坚持;医生评审认为 99.2% 的反事实计划处在安全的运动强度范围内,97.6% 的生理表述准确。教练和医生都提到一个关键点:把「保持现状会怎样」和「能达到的更好结果」并排摆出来,最能给人行动的理由——临床医生里 92% 认同这种对比有激励作用,而通用计划只有 8%;「更有掌控感」这一项的认同度是 97% 对 59%。
再进一步:心、肾、代谢三系统一起看
同一天发布的还有一篇姊妹论文,把这套框架从单一健康年龄扩展到了心肾代谢(CKM)综合征——心脏病、肾病、2 型糖尿病往往不是孤立出现的,而是一张互相牵连的网,早期衰退常常悄无声息。
扩展版在可穿戴数据之外加入了三项常规抽血指标:胆固醇/HDL 比值(心血管)、eGFR 肾小球滤过率(肾脏)、HOMA-IR 胰岛素抵抗指数(代谢),在 819 名 WEAR-ME 参与者身上验证。结果发现多器官老化没有统一模板:代谢和心血管的压力经常一起出现,但早期肾功能下降常常是独立发生的——这正是只看单项指标容易漏掉的信号。模型算出的 CKM 健康年龄差,与 Life's Essential 8 评分的相关系数为 -0.58,与代谢综合征严重程度评分为 0.65,也和参与者自己的主观健康感受对得上。
小杜点评
从工程角度看,这个工作的亮点不在某个单点指标,而在 pipeline 的组织方式:LLM 不直接给健康建议,而是先由世界模型跑模拟、优化器按可行性筛,最后 LLM 只负责把「算出来的最优路径」翻译成人话。建议被锚定在模拟结果上,幻觉的空间就被压缩了——医生评审里 99.2% 安全、97.6% 表述准确,部分原因就在这里。
评估设计也值得抄作业:不是只报 R² 和 C-index,而是让真人教练和医生双盲对比「有模拟打底」和「无模拟打底」的计划,71.4% 的胜率才有说服力。做 Agent 的同学可以想想:自己的系统有没有一个类似的「对照组」,证明多出来的那个模块真的在起作用。
局限也要说清:全部验证都是回顾性离线评估,这套模型目前是研究原型、不是临床诊断工具;SensorWM 的 R² 0.664 放在 12 周、20 个指标上还不错,但离「精准预测个体」还远;数据来自 Fitbit 用户,本身就是偏健康、偏年轻的人群,泛化到老年人和慢性病人群要打问号。Google 自己也说,下一步是做前瞻性试验。
不过思路是通的,而且可以搬家:当 Agent 的任务涉及真实世界后果、需要长期规划时,「先模拟、再行动」比「直接让 LLM 拍板」更靠谱。「世界模型 + 约束优化 + LLM 表达」这套三段式,完全可以搬到健康之外的场景——比如训练计划、学习规划、任何需要「先推演、再建议」的地方。
参考来源
- Google Research 博客:Using wearables to enable cardiovascular-kidney-metabolic (CKM) risk profiling for personalized coaching
- 论文:Personalized health coaching via coachable health age and counterfactual wearable trajectories
- 姊妹论文:Cardiovascular-Kidney-Metabolic Health Age Using Wearables and Blood Biomarkers