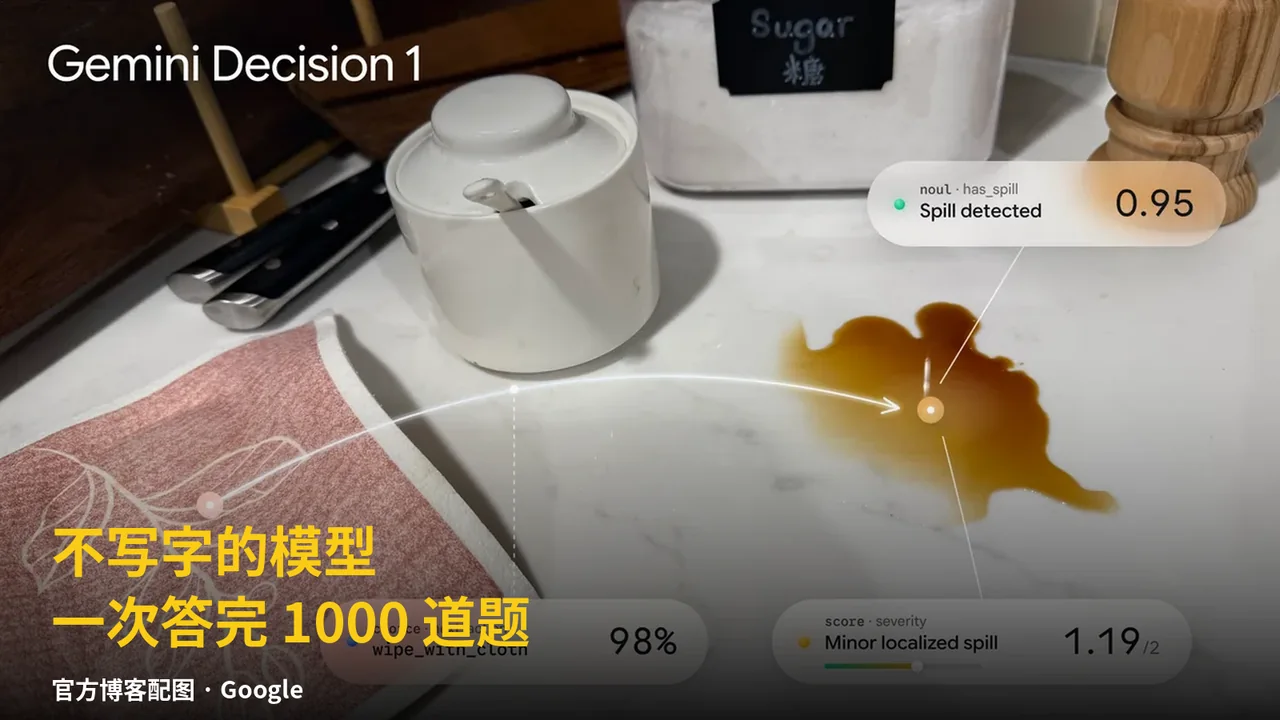
Google 在 11 月 11 日的官方博客上发布了 Gemini Decisions API,搭载一个新模型 Gemini Decision 1(gemini-decision-1)。这个模型有个很反直觉的特点:它一个字都不写。不生成文本,只做判断——一次请求里,对同一份输入回答最多 1000 道是非题、选择题或打分题,返回每个答案的概率和置信度,端到端延迟 150 到 250 毫秒。
这件事值得算法工程师关注,因为「做判断」正在从生成式调用的副产品,变成一等公民的 API。以前要做判断,要么等大模型逐字吐出一句「是/否」,要么自己训一个分类器;现在判断变成了一次前向传播的调用。而且 Google 不是第一家:OpenAI 在 9 月底的 DevDay 上发布了 Decisions API(搭载 GPT-6 Luna),微软随后跟进了 Microsoft-Decision-1,9 月 TypeSafe 也发布了 Jev。决策模型正在变成一个品类——我们之前写过的 Artificial Analysis 决策模型评测榜单(Decision Index v2)正是这个赛道的风向标。
它怎么工作:不生成,只打分
传统生成式调用是逐 token 解码:模型一个词一个词往外吐,答案藏在文本里,还得再解析。Gemini Decision 1 换了一条路:对候选选项直接打分,一次前向传播就出结果。
一次请求可以带一份共享的多模态输入——文本、图片、音频、视频、PDF,最多 25.6 万 token——再加上最多 1000 个相互独立的问题。三种题型可以混在一个请求里:
- noul(是非题):估计某个条件成立的概率,可以附上「真/假」的描述标准;
- choice(选择题):2 到 255 个候选中选一个,返回胜出者以及每个候选的归一化概率;
- score(打分题):按从 0 开始的有序量表打分,返回连续加权分数和每个等级的概率。
每个答案都带一个 0 到 1 的置信度,代码可以根据阈值把模棱两可的情况转给兜底逻辑或人工复核。官方博客给的例子很直观:一张茶水间台面的照片加一句文字说明,一次请求同时问「台面上有没有没清理的液体洒漏」「下一步该做什么」「严重程度打几分」,模型返回洒漏概率 0.95、建议「用布擦拭」置信度 98%、严重程度 1.19/2。
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})
result = client.decisions.create(
    model="gemini-decision-1",
    input=[{"type": "image", "uri": ".../spill.jpg", "mime_type": "image/jpeg"},
           {"type": "text", "text": "Breakroom counter check before the 9 AM client meeting."}],
    questions={
        "has_spill": {"type": "noul",
                      "instructions": "Is there an uncleaned liquid spill on the counter?"},
        "next_action": {"type": "choice",
                        "instructions": "Which cleanup action fits the scene?",
                        "criteria": {"wipe_with_cloth": "Small counter spill with a cloth or towel already nearby.",
                                     "dispatch_janitorial": "Large floor hazard, broken glass, or active leak.",
                                     "ready_for_meeting": "Counter is clean and ready."}},
        "severity": {"type": "score",
                     "instructions": "Rate the severity of the counter mess.",
                     "criteria": ["Clean and ready.", "Minor localized spill.", "Major spill or safety hazard."]},
    },
)
快和便宜:数字
Google 给出的数字是这样的:模型计算中位数 50 到 100 毫秒,端到端 150 到 250 毫秒;输入在 1.6 万 token 以内、问题数从 1 增加到 100,延迟几乎不变。定价是输入每百万 token 0.10 美元,输出 token 免费——共享输入按一次计费,不管问多少个问题,每个问题只加自己的指令和标准所占的 token。没有思考 token 的账单,也没有单独的音频转录和 OCR 费用。按 Google 的说法,在同一评测套件上,它比 Gemini 3.5 Flash-Lite 加 Interactions API 的组合便宜近 5 倍。
目前通过 Gemini API(Google AI Studio)提供,有免费层可供原型开发;Gemini in Google Cloud 的支持即将推出。生态集成正在陆续接入 OpenRouter、LangChain、Vercel、LiteLLM、Pydantic AI、Pipecat、LiveKit 和 OpenCode。
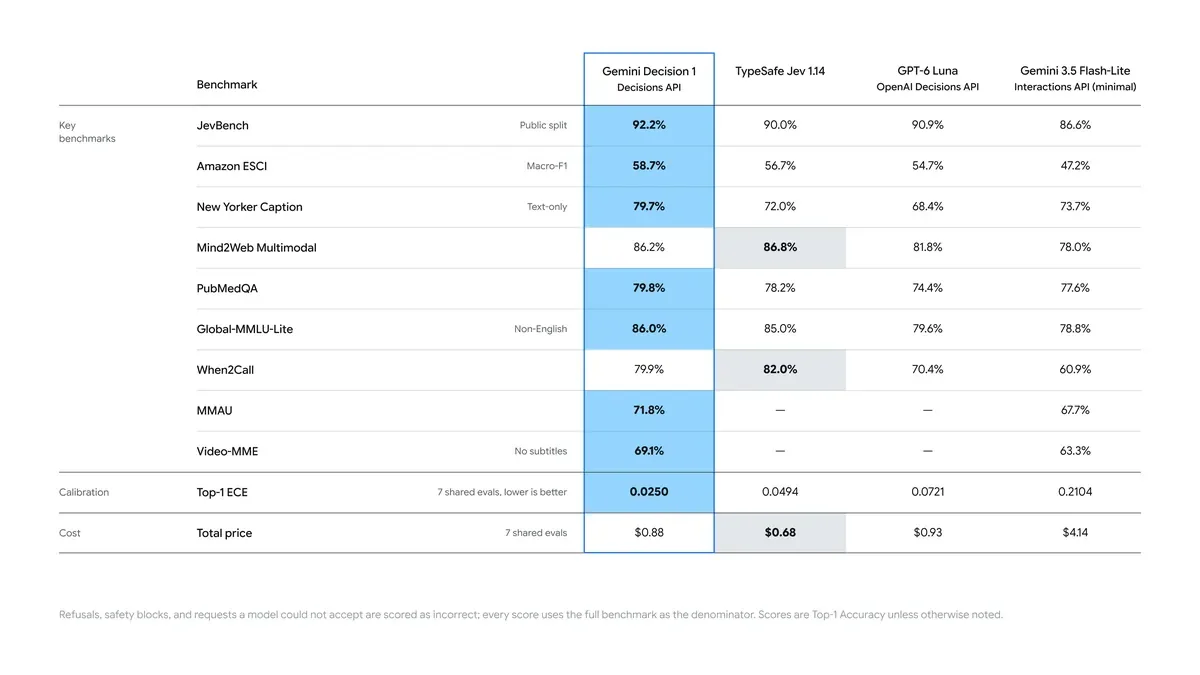
Google 官方评测表:Gemini Decision 1 对比 TypeSafe Jev 1.14、OpenAI GPT-6 Luna 和 Gemini 3.5 Flash-Lite。图片来源:Google 官方博客
跑分:赢了 7 项,但有两项输了
跑分是 Google 自测的数据,先说清楚这一点,没有经过独立验证。
在 9 项基准测试里,Gemini Decision 1 赢了 7 项。JevBench 上 92.2%,高于 Jev 1.14 的 90.0%、GPT-6 Luna 的 90.9% 和 Flash-Lite 的 86.6%;Amazon ESCI、New Yorker Caption、PubMedQA、Global-MMLU Lite、MMAU、Video-MME 也都领先。校准误差(Top-1 ECE,越低越好)是 0.0250,是四个模型里最低的——对「敢不敢按概率自动走下去」的场景来说,这个数字比准确率本身更重要。
但表里也有不体面的两行:Mind2Web Multimodal 上 86.2% 对 Jev 的 86.8%,When2Call 上 79.9% 对 Jev 的 82.0%,这两项输给了 Jev。成本那一行也值得多看一眼:7 项共享评测的总价,Gemini Decision 1 是 0.88 美元,Jev 是 0.68 美元——Jev 更便宜,Flash-Lite 则要 4.14 美元。也就是说,「便宜近 5 倍」是对 Flash-Lite 说的,不是全场最便宜。
Google 自己已经在用了
Google 内部已经有四个落地场景,都是把 Decisions API 当「低延迟控制层」用:
- Gemini Notebook 的动态路由:实时把用户查询分流到合适的模型档位和思考深度,日常查询延迟最多降低 40%,复杂查询才留给深度推理模型;
- Stitch 的快速画布实验:几秒生成可玩的产品流程线框,语音或点击的编辑几乎即时生效,满意了一键交给完整版 Stitch 做精修;
- Google Labs 的 CC:从 200 多个表情里挑反应,零点几秒出结果,不增加延迟;
- Google Search 的安全层:检测针对 MCP 工具的对抗行为和内容,在延迟预算内完成。
共同点很明显:这些场景都不需要模型「写点什么」,只需要它「立刻选一个」。定义好选项就能上线,不用训自定义分类器,也不用等生成式调用。
对工程师意味着什么
最直接的替代关系是各种小分类器:工具选择、策略检查、模型路由、上下文打分、内容分级。以前这类需求要么接生成式 API 再解析(慢、贵、格式不稳),要么自己训一个专用模型(数据、部署、维护都是成本)。决策模型把这件事压成了一次调用:定义选项就是部署。
置信度是这个 API 真正的设计重点。返回的不是一个干巴巴的标签,而是一组概率——低于阈值走人工复核,高于阈值自动执行,中间档可以换更强的模型再判一次。Agent 每一步都要做选择:该调哪个工具、这段上下文值不值得保留、这一步输出合不合规。150 毫秒的判断,比 2 秒的生成便宜得多,也更适合放在循环里。
成本模型也变了:共享输入只算一次,问题越多越划算。批量评估、内容审核、Agent 每一步的检查点,都是天然适合的场景。反过来,只给概率不给理由也是它的边界:需要可解释性的时候,还得配一个生成式模型复核,或者把决策日志留下来备查。
另外两个提醒:目前还是 v1beta,据第三方上手文章,暂不支持 prompt caching 和 batch 调用;以及跑分终究是厂商自测,选型之前先在自己的数据上测一遍,别只看表。
小杜点评
决策模型这个品类来得比想象中快:9 月 TypeSafe 的 Jev、9 月底 OpenAI 的 Decisions API、微软的 Microsoft-Decision-1,现在是 Google 的 Gemini Decision 1。不到两个月,四家大厂把「判断」单独做成了一个 API,说明 Agent 基础设施正在分层——生成归生成,判断归判断,各自按自己的成本和延迟优化。
对做 Agent 的工程师来说,最值得看的其实不是 JevBench 的 92.2%,而是 Top-1 ECE 的 0.0250。Agent 敢不敢按概率自动走下去,取决于概率准不准;校准做得好,阈值策略才站得住。这也是决策模型和传统分类器的真正区别:它不只给答案,还给一个能用的置信度。
但也别急着把所有分类器都换掉。两项输给 Jev、Jev 总价更便宜、跑分是厂商自测、v1beta 功能还不全——这些都是选型时要算进去的账。正确的姿势是:先拿一个现成的判断场景(比如路由、审核、打分)做个对照实验,测准了自己的延迟和成本,再决定换不换。
参考来源
- Google 官方博客:《Gemini Decisions API: Fast, calibrated multimodal decisions》,2026 年 11 月 11 日:https://blog.google/innovation-and-ai/technology/developers-tools/gemini-decisions-api/
- MLQ.ai:《Google launches Gemini Decision 1, a model that scores up to 1,000 questions in one pass》:https://mlq.ai/news/google-launches-gemini-decision-1-a-model-that-scores-up-to-1000-questions-in-one-pass/
- Unite.AI:《Google Launches Gemini Decisions API for Multimodal AI Workflows》:https://www.unite.ai/google-launches-gemini-decisions-api-for-multimodal-ai-workflows/
- MadRobot:《Gemini Decision 1: Google's AI that answers without writing》:https://madrobot.blog/2026/11/11/google-gemini-decisions-api-1000-questions/
- 小杜博客:《Artificial Analysis 发布决策模型榜 Decision Index v2》:https://xiaodu.blog/articles/422