东京时间 2026 年 11 月 7 日 04:08(官方博客标注日期 2026-11-06;OpenAI 官方 X 帖 时间为 UTC 2026-11-06 19:08),OpenAI 发布工程博文 Measuring how AI agents handle everyday wet-lab science,正式介绍与酶设计公司 Ligo 合作的评测集 BioBasicsBench。它面向「日常湿实验」里的原始证据解读:凝胶、菌落平板、显微与仪器读数,而不是论文里挑过的漂亮图。对做多模态 Agent、科学 Agent 评测的人来说,这更像把「看图说话」换成「看实验记录并敢于说证据不够」。
评测在测什么:100 题、五类日常湿实验
BioBasicsBench 共 100 道任务,覆盖五块日常湿实验工作:蛋白方法、成像与流式、定量与 assay、核酸方法、分子克隆。任务由科学家用自己实验里的数据写成,并配专家撰写的评分细则;每题经过 Ligo 内部未参与出题的科学家审核、外部在职湿实验 PhD 审核,再加一轮内部终审。
Agent 需要返回结构化答案(结论 / 测量 / 建议,以及必要时的理由)。分数按细则里的单项给分,因此「结论对但推理半对」和「完全蒙对」可以被拆开。官方强调多数题会同时考生物知识、图像与表格解读、错误检测与协议理解。
输入刻意保留实验室原始形态:凝胶与 blot、平板照片、显微 z-stack / 延时、测序 FASTQ、读板机导出、甚至操作视频。官方表格还给出了各类数据出现次数(类别可重叠),例如 gels & blots 31、protocols/notes 27、tables/exports 20、显微 14、测序文件 12 等——说明这不是「单图单问」的玩具集。
厂商自测结果:Astra 在 xhigh 上到 66.7%
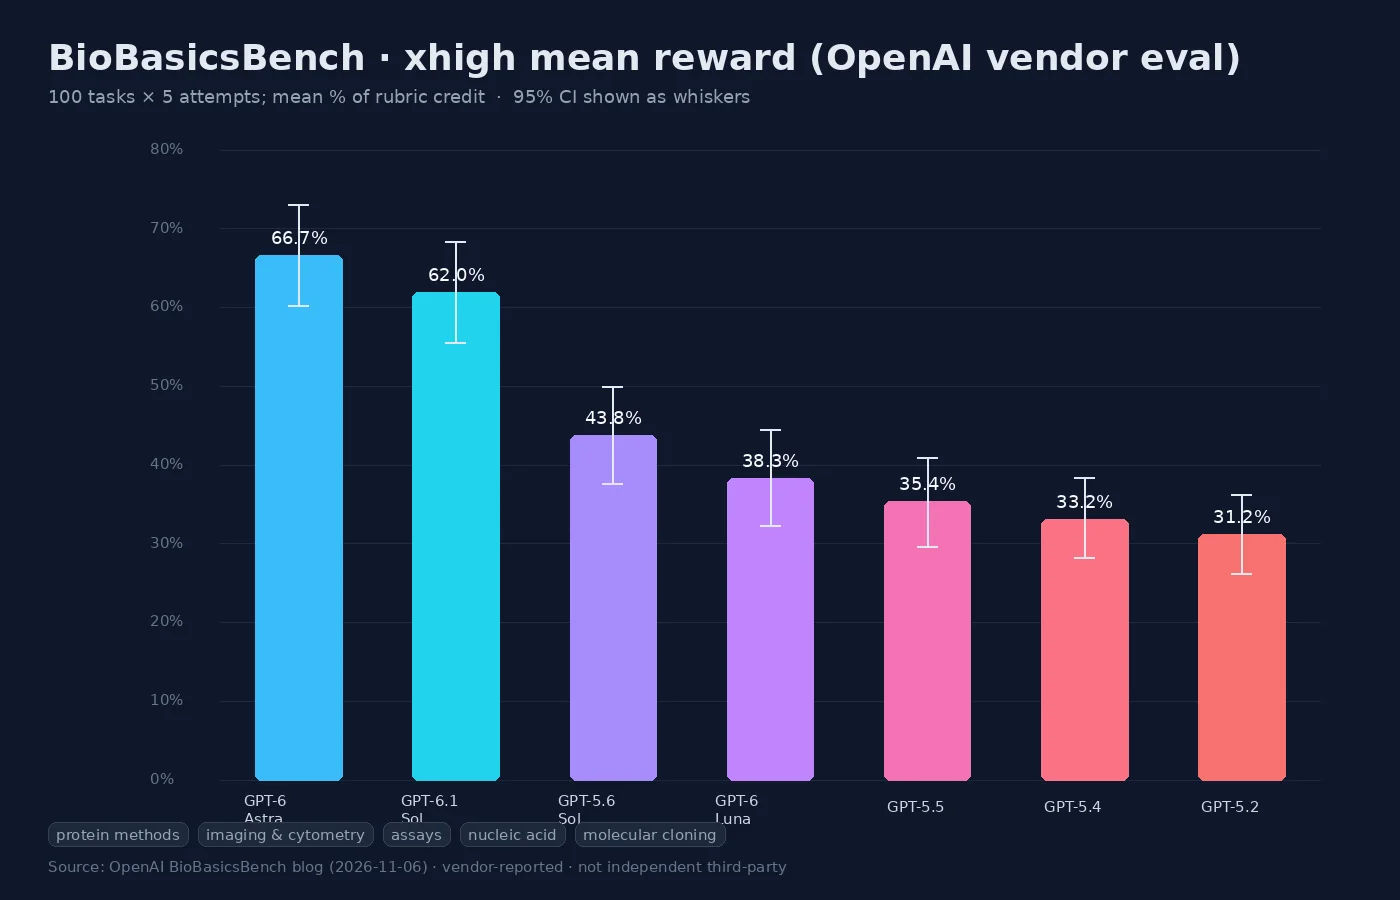
OpenAI 报告评了七个模型:GPT-5.2、GPT-5.4、GPT-5.5、GPT-5.6 Sol、GPT-6.1 Sol、GPT-6 Luna、GPT-6 Astra;共 37 组「模型 × 推理力度」设置,每题 5 次尝试,合计 18,500 条结果。指标是 mean reward(占可得细则分数的百分比),误差条为按整题重采样的 95% CI。
在所有模型都报告的 xhigh 力度下,官方表格给出(厂商自测):
| 模型 | Mean reward | 95% CI | 每题输出 token |
|---|---|---|---|
| GPT-6 Astra | 66.7% | 60.3–73.1% | 4,704 |
| GPT-6.1 Sol | 62.0% | 55.6–68.4% | 5,238 |
| GPT-5.6 Sol | 43.8% | 37.6–50.0% | 9,099 |
| GPT-6 Luna | 38.3% | 32.3–44.5% | 13,120 |
| GPT-5.5 | 35.4% | 29.7–41.0% | 11,135 |
| GPT-5.4 | 33.2% | 28.3–38.4% | 13,717 |
| GPT-5.2 | 31.2% | 26.2–36.3% | 27,620 |
文中还写:即使在较低推理力度,Astra 相对 GPT-5.6 Sol 仍有明显提升,并把它归因到更强的原生多模态能力。这些数字全部来自 OpenAI 自己的评测设置,不是独立第三方复现。
案例里真正有用的点:拒答、看标签、保住实验上下文
博文用几组对比说明「分数涨了」对应什么行为变化(仍属厂商叙述):
- 染料通道重叠:仅凭死细胞染料亮度不能判死;Astra 指出检测窗与另一染料重叠,要求更好对照,而不是硬下结论。
- 阴性对照平板标签写错抗生素:Sol 看到无菌落就采信;Astra 读到边缘标签是 Kan 而非实验用的 Amp,从而否定该对照。
- z-stack 误当成「细胞消失」:Sol 找生物学解释;Astra 识别为不同焦深的扫描。
反过来,官方也老实写了 Astra 仍会翻车:被「更大 PCR 产物=成功克隆」的先验带偏而选错菌落;只强调更暗的液泡而忽略同视野更亮的反例;菌落计数对邻接菌落分辨率不够,示例板上相对参考约 多计 12%。这对做评测的人很重要——高分不等于能直接当实验室助手。
对算法与 Agent 工程的含义
BioBasicsBench 的设计偏好很清楚:奖励「证据边界意识」和「多模态细读」,而不是堆论文图上的标准问答。若你在做科学 Agent,可以对照三件事:输入是否允许视频 / 原始仪器文件;评分是否按细则拆分;失败案例是否公开到「选错对照 / 过度概括」这一级。OpenAI 在文末也把它和 biosafety / biosecurity 能力跟踪绑在一起——评测动机不只是刷榜。
目前公开材料以博客与结果表为主;是否另有可下载任务包、license 与提交入口,以官方后续页面为准(本稿未在原文见到可复现的公开数据集下载说明)。
小杜点评
从评测工程看,BioBasicsBench 比「科学 QA 再加几张图」更贴近真实工作流:原始证据脏、对照会标错、模型还必须学会说「证据不够」。Astra 在厂商自测里相对 Sol 的跳变,更像多模态底座升级,而不是单纯把 thinking token 烧上去——注意 xhigh 下 Astra 的每题输出 token(4,704)反而低于 Sol(9,099)。落地时我会把它当 诊断型基准:盯拒答率、对照有效性检查、计数误差,而不是只报一个 66.7%。独立复现和任务泄露防护还没在这篇里讲透,工程同学若要跟进,优先等可下载协议或外部复现报告。