东京时间 11 月 5 日凌晨(对应 UTC 2026-11-04 18:46 前后),NVIDIA 开发者博客放出 CUDA Toolkit 13.5。按官方说法,对 NVIDIA Vera Rubin 架构的支持从早期开发者访问转到 GA(general availability),可以进入企业生产环境;Windows on Arm 也进一步覆盖到 NVIDIA DGX Station for Windows。今天站内已经写了不少模型开源与 API 更新,这篇换个角度:只抽和训练、推理、多卡通信、工具链相关的改动,方便算法工程师做升级判断。

Vera Rubin 进入 GA,Windows 驱动假设要改
CUDA 13.5 的头条是平台落地:Vera Rubin 支持正式可用。同文写明,从 Rubin 架构起,Windows 侧支持 WDDM 与 MCDM(Microsoft Compute Driver Model,偏计算专用),TCC 模式在 Rubin 及之后不再支持。如果你的镜像、装机脚本或内部文档默认假设「Tesla 卡开 TCC」,需要改成 WDDM/MCDM,并在目标机上重新验证驱动模式。
对还在等 Rubin 机器的团队,意义很直接:Toolkit 与驱动叙事已经对齐到「可上生产」,而不是只能做早期适配。不过这篇博客几乎没有给出端到端性能数字,升级前后仍要用自己的 kernel、训练作业和推理服务做回归,别把 GA 四个字当成吞吐保证。另外,CUDA Graph 现在可直接捕获已有的 cudaMemcpyBatchAsync 批量一维拷贝,也能显式加批量拷贝节点并在结构不变时更新地址与长度,适合把固定流水线做成可回放图。
调度侧:Locality Domain 与 MPS v3
多租户推理、训练和推理混部时,最烦的是「一张卡怎么切、怎么抢」。13.5 给了两组更细的旋钮:
- Locality domain:默认各域保证相同的 SM 数量,多出来的 SM 可能落在分区外;新标志
cudaDevSmResourceGroupLocalityDomainSupplementalSms(配合cudaDevSmResourceGroupLocalityDomainId)可以把补充 SM 并进选定域。可用cudaDevSmResourceSplit()的 discovery 模式读出每个分区实际 SM 数,再在「均匀可预期」和「尽量吃满硬件」之间做取舍。 - MPS v3:加权分时(weighted timeslicing)可为不同 MPS server 拉长计算时间片,并单独调节切换激进程度;SM 分区支持借还(
--max-chunks借、--shareable=true借出空闲分区),二者可独立开关;cgroup v2 子树可映射到 MPS namespace,客户端连主 socket 时自动路由;还可按 namespace 预置设备 SM 分区,减少到处设CUDA_MPS_SM_PARTITION。内存记账提供 polling 回退:nvidia-cuda-mps-control memacct set force_polling=true,在 cgroup 通知不可靠时改读实时用量。
这些都是运行时能力,不替代 NCCL / NVLink 拓扑规划,但能减少混部时的拍脑袋配置。若你已经用 MPS 做多模型同卡,值得对照现有参数表逐项试;先在非关键命名空间里验证借还是否会拖慢高优先级服务。
CUDA Tile、Python 与 CCCL:贴近训练推理的几处
和模型侧更贴的更新包括:
- CUDA Tile 多卡通信:Tile kernel 内可直接用 unicast / multicast 指针,在 NVLink、NVSwitch(含 NVLink SHARP)上做跨卡访问与规约,适合把通信塞进融合算子,而不是只能在 kernel 边界走全局内存。应用需先准备好共享内存映射再启动。
- Tile ↔ SIMT 互操作(公开预览):Tile 代码可调用 NVSHMEM、CCCL Coop、Warp、MathDx(含 cuFFTDx、cuBLASDx、cuSolverDx、nvCOMPDx)的 device 函数;C++ 需
nvcc --tile-preview simt,Python 走cuda.tile_preview.foreign_call。当前预览只覆盖库函数,自写__device__仍要等后续版本。 - cuda.core 1.2:
copy_batch()一次提交多段拷贝;LaunchConfig增加 PDL(compute capability 9.0+),让后续 kernel 在同一 stream 上提前做无关工作;CUDA Graph 可用graph[node].update(...)改参数而不整图重建。 - CCCL 3.5:公开 CUB tuning API(
cuda::execution::tune(...)),可按算力版本定制 threads per block、items per thread 等;新增cub::DeviceBatchedTopK,可按段选 Top-K,K 还可逐段变化——官方写明已接入 FlashInfer,面向 LLM decode 与 sparse attention;另有可复现浮点 scan,以及用cuda::args::deferred从设备内存读元素个数的 reduction,方便图捕获里长度随数据变化。
数学库部分,博客强调 Vera Rubin 上的启发式与 kernel 调优(含 NVFP4、MXFP8 的 MoE 训练形状),BF16 非 8 对齐形状可走与 FP16 同款优化核,Ozaki-II 方案扩展到 FP64 对称 rank-k 更新,以及 cuSPARSE / nvJPEG 等加速。文中「最高约 1.5×」「CSR SpMM ALG3 约 1.65×–2.27×」「SpSV ALG2 几何均值约 2.7×」「分析阶段几何均值约 2.79×」等均属厂商自测,跨卡型、跨形状不能直接外推。
工具链与打包:Nsight、CompileIQ、预编译
调试与发布路径也有几处值得记:
- Nsight Perf SDK for AI 进入公开预览,面向长跑训练/推理的常开采集,把关键 GPU/CPU 指标和执行上下文留下来,结果可放到 Perfetto 回看偶发抖动。
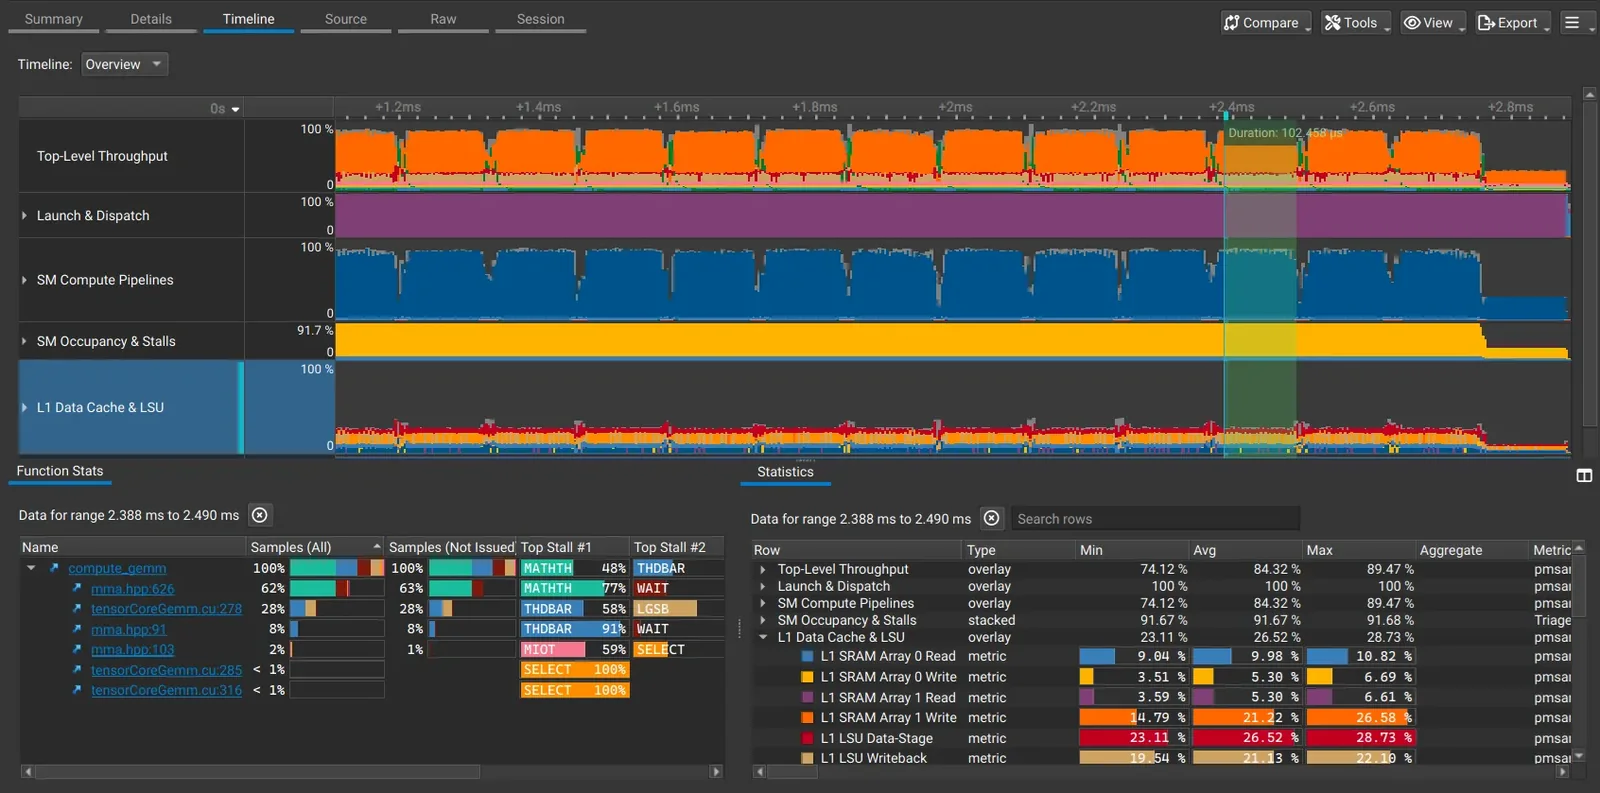
- Nsight Compute 2026.4 增加独立 Timeline 页(见上图),方便对照阶段性 stall 与利用率变化,并可从 Details 页跳到对应时间线。
nvprune --precompile可在裁剪 fatbin 时把 PTX/TileIR 预编译成目标架构 SASS,减少下游 JIT;CompileIQ 控制文件也延伸到 PTX Compiler 与 NVVM。cuobjdump的 ELF 符号表输出改成更接近readelf -s的可读列,方便区分 kernel 入口与各类内存属性。- CUDA-GDB 可按线程/级别/消息模式在 Driver log 事件处停住;Compute Sanitizer 还提供给 AI coding agent 用的 skill 说明;Nsight Cloud 则加强了 Dynamo 部署上的 OpenTelemetry 与 profiling 配置。PTX 侧还增加了 kernel 内更新 TMA out-of-bounds 寻址模式,以及
__sin2pif/__cos2pif/__sincos2pif等按周期输入的近似三角函数。
下载入口仍是官方 CUDA Toolkit 13.5 页面,完整兼容矩阵以 release notes 为准。建议先在一台非关键机装 Toolkit,跑你最常用的 matmul / attention / Top-K 路径,再决定默认镜像是否升到 13.5。
升级前可以先核对的清单
动手之前,我建议至少过这几项:
- 驱动与架构:目标机是否已经是 Rubin,或仍停留在 Hopper/Blackwell;Windows 部署是否还依赖 TCC。
- 混部策略:若在用 MPS,记下当前 timeslice、SM 分区和环境变量,再在实验 namespace试加权分时与借还,观察高优先级作业的尾延迟。
- 依赖库:推理栈是否已经间接用到 FlashInfer / CUB Top-K;若有,关注 CCCL 3.5 升级后的符号与默认策略变化。
- 图与拷贝:服务里若大量使用 CUDA Graph,可评估把分散的 1D 拷贝收成
cudaMemcpyBatchAsync或copy_batch(),减少 launch 开销。 - 发布产物:云镜像或 wheel 若内嵌 fatbin,可评估
nvprune --precompile,让终端用户少做一层 JIT,但务必按实际部署架构做验证。
把这五步写进内部 runbook,比只看博客标题更不容易漏。
小杜点评
从算法工程师视角,13.5 更像「把 Rubin 生产化,并把共享 GPU、Tile 通信和 CCCL 原语补齐」,而不是再发一版耀眼的单算子榜单。对我这种经常在多进程推理、MoE 训练和 FlashInfer 一类路径上踩坑的人,真正有用的是三件事:Rubin/Windows 的驱动假设要不要改;MPS v3 与 locality domain 能不能把混部变稳;batched Top-K 和 Tile 多卡通信会不会迟早进你依赖的推理栈。建议是:有 Rubin 或准备混部的团队先读 release notes 做一份兼容清单;还在 Hopper/Blackwell 上的人,可以优先试用 DeviceBatchedTopK、Graph 批量拷贝和 Nsight Timeline,用自己的 decode / attention 形状量一版,再决定要不要把 13.5 写进默认镜像。厂商加速数字只作方向参考,最终仍以你机台上的回归曲线为准。