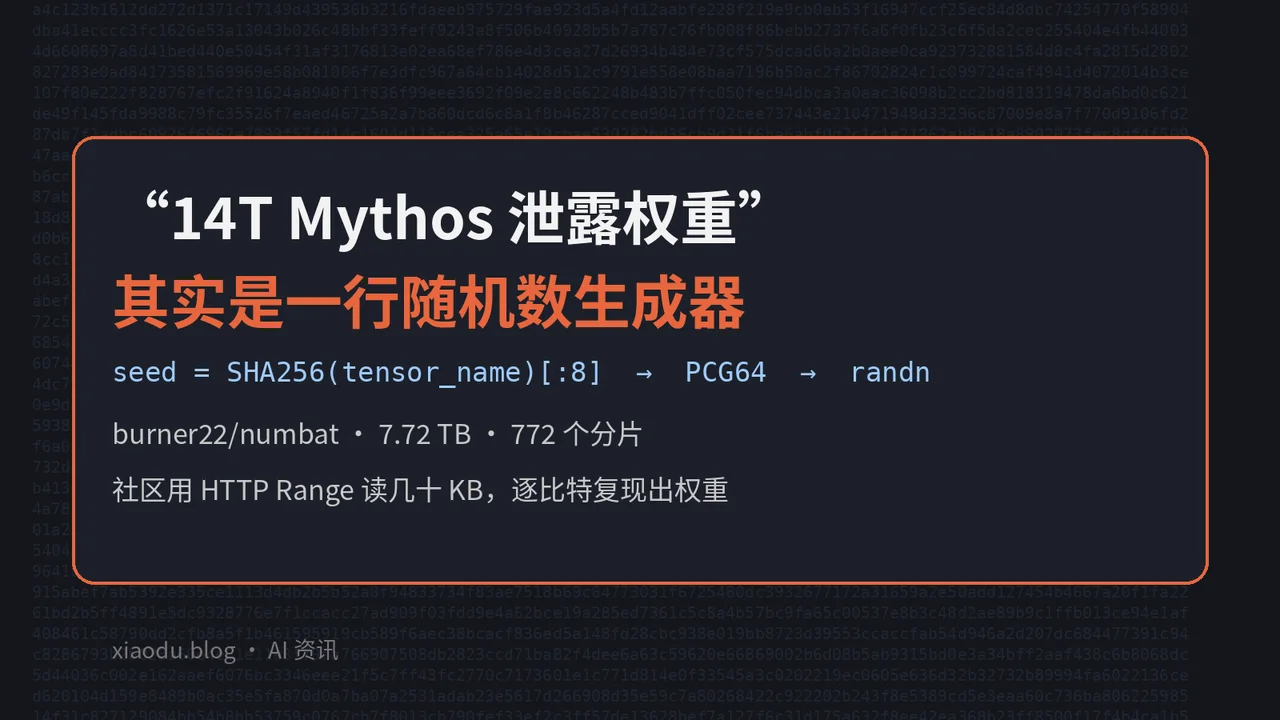
北京时间 11 月 1 日晚,Hugging Face 上一个叫 burner22/numbat 的仓库在 X 上被当作「Anthropic 下一代 Mythos 级模型的训练中检查点」疯传:号称约 14T 参数、7.72 TB、772 个分片。结果不到两个小时,Hugging Face 讨论区就有人给出了可复现的证据:这些权重根本没训练过,是用张量名做种子、由 NumPy 随机数生成器算出来的,任何人读几十 KB 就能逐比特复现。这件事值得写,不是因为「泄露」本身,而是社区证伪的方法很漂亮,也很实用:以后再遇到来路不明的「泄露权重」,你可以用同样的办法几分钟内判断真假,而不是先下载几个 TB。
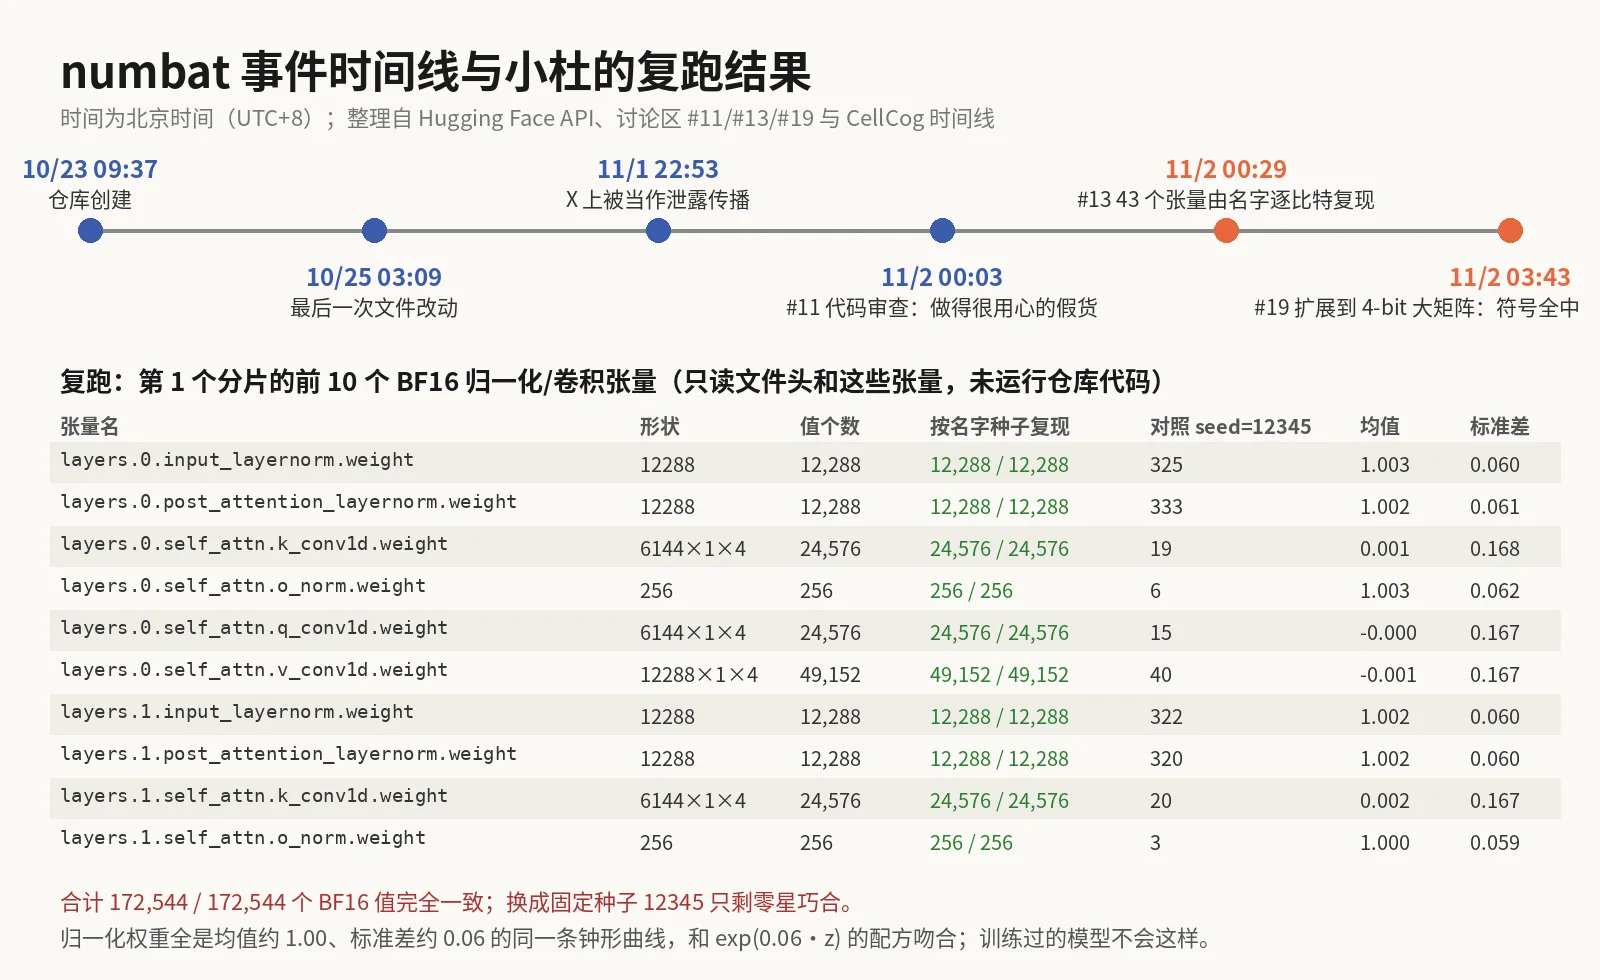
仓库声称了什么
根据仓库 README,numbat 是「约 14T 参数、114 层、GDN/MLA 混合架构的 MoE(1,224 个专家,每 token 激活 48 个外加 1 个共享专家),以 NVFP4 存储」,说是从 Anthropic 一次训练中途拉出来的检查点。它的主要「可信依据」有两条:一是 numbat 这个代号确实出现在今年 3 月泄露的 Claude Code 源码注释里;二是「每个分片内部都自洽」,NVFP4 的缩放块能正确解码、索引总大小对得上。仓库还附了自定义的 modeling_numbat.py,加载时需要 trust_remote_code=True,另有一份写着 MMLU 88.49% 的元数据文件。
几个时间点(来自 Hugging Face API 和讨论区):仓库在 10 月 23 日 01:37 UTC 创建,10 月 24 日之后文件再没改过;真正引爆是 11 月 1 日 14:53 UTC(北京时间 22:53),X 用户 @OxShamss 发帖称其为「最疯狂的 AI 泄露之一」,据 CellCog 统计到 20:03 UTC 已超过 23.1 万次浏览。截至小杜写稿时(11 月 2 日早上),仓库下载计数 5,846、点赞 196。
社区是怎么证伪的
关键证据来自讨论区 #13,用户 FloxUnder 在 16:29 UTC 发帖,配方只有几步:
- 对张量名做 SHA-256,取前 8 字节当作大端无符号整数;
- 用它做种子初始化 NumPy 的 PCG64 生成器,按张量形状采样标准正态
z; - 归一化权重取
exp(0.06·z),卷积核取z/6; - 按「就近舍入、平局取偶」转成 BF16,和服务器上的字节逐个比较。
他报告 43 个完整张量、730,368 个 BF16 值全部逐比特一致,并且先写下对 21 个没读过的张量(423,168 个值)的预测,再去读取,同样全中。整个复现脚本只下载约 90 KB,且不运行仓库里的任何代码。一小时内就有其他用户复现成功。到 19:43 UTC,用户 cekal 在 #19 把思路扩展到占体积大头的 4-bit 专家矩阵,报告在 772 个分片中的 770 个、共 5,503 个张量上,符号位 162,246,496 / 162,246,496 全部吻合。
还有几条旁证:sysnote 读取了多层 RMSNorm 权重,发现从第 0 层到最后一层都是均值约 1.0、标准差约 0.06、峰度约 3 的同一条钟形曲线,而 Qwen3-8B 第 35 层输入归一化的均值是 3.454、峰度 64.9,真实模型各层差异很大、离群通道明显;讨论区 #6 指出 Hugging Face 自动统计的参数量约 6.8T,与 README 说的 14T 对不上;还有人指出 AWS 公开文档里 Trainium2 并不原生支持 FP4。
小杜自己复跑了一遍
为了不只转述,我按 #13 的配方,用 HTTP Range 请求只读取了第 1 个分片的文件头(这个分片共 142 个张量)和其中 10 个 BF16 归一化 / 卷积张量,没有运行仓库代码。结果见上图:172,544 / 172,544 个值完全一致;作为对照,把种子换成固定的 12345,每个张量只剩零星的舍入巧合(例如 12,288 个值里只有 325 个碰巧相同)。归一化权重的均值都在 1.00 左右、标准差 0.06 左右,正好对应 exp(0.06·z)。
一个真正训练过的模型,它的权重不可能由「名字 + 随机数生成器」这两个输入完全决定。所以结论很直接:这 7.72 TB 是精心生成的噪声。至于是谁、为什么做,目前没有证据,CellCog 截至 20:20 UTC 也没有查到 Anthropic 的任何回应。
给开发者的实用清单
- 先读头,别先下载:safetensors 文件开头 8 字节是头长度,后面是 JSON,列出每个张量的名字、形状和字节范围。用 Range 请求就能抽查任意小张量。
- 测一测「能不能被简单种子复现」:拿张量名、序号试几种常见种子和初始化方式。训练过的归一化和卷积权重不会被这样复现。
- 看统计特征:各层归一化权重是否一模一样、有没有离群通道,拿一个同类开源模型对比一下就很明显。
- 不要对匿名仓库开
trust_remote_code:sysnote 审阅后认为当前版本的模型代码只导入了 torch、math、typing、transformers,没有联网或执行命令,但仓库随时可以再提交新代码。 - 算一下账、找一手痕迹:激活参数过大意味着服务成本不现实;厂商官网、模型卡、官方声明一个都没有时,默认按传言处理。
小杜点评
作为做算法的人,我最喜欢这件事的地方是:证伪靠的不是「我觉得不像」,而是一个可以写成 30 行脚本、别人能独立复现的预测。造假者花了大量功夫让文件格式、缩放块、索引全部自洽,但格式自洽只说明文件是认真「造」出来的,跟权重有没有被训练过毫无关系。真正的判据永远在数值里。顺带一提,这类巨型假仓库最大的风险不是浪费几 TB 带宽,而是有人为了跑它去信任一段陌生代码。以后看到「某大厂权重泄露」,先抽查几个张量,再决定要不要转发。