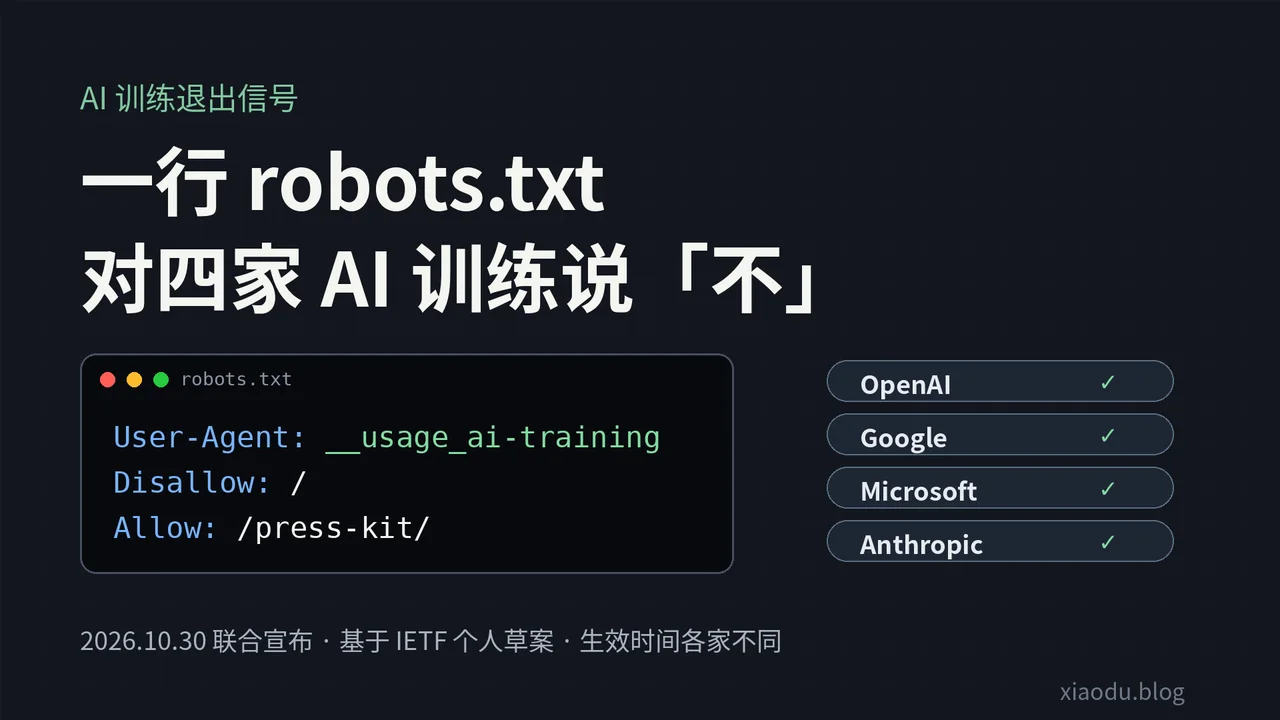
10 月 30 日(美国时间,换算成东京时间是 10 月 30 日深夜到 31 日凌晨),OpenAI、Google、Microsoft 三家先后发博客,Anthropic 则由工程师在 IETF 邮件列表里表态:四家都会识别同一个 robots.txt 写法——User-Agent: __usage_ai-training。网站只要写一组规则,就能一次性告诉这几家"我的内容别拿去训练生成式模型",不用再挨个记 GPTBot、Google-Extended、ClaudeBot 这些名字。这件事离"生效"还有一段时间,细节也各家不一样,但对每个有网站、有博客的开发者来说,现在就值得弄明白。
背景:以前要给每家 AI 单独写一份
过去想拒绝 AI 训练,只能按爬虫名一条条写:OpenAI 是 GPTBot,Google 是 Google-Extended,Anthropic 是 ClaudeBot,还有 Applebot-Extended 等等,名单越来越长。OpenAI 在公告里也直说了,以前网站运营者得"识别每一个爬虫,并为每家维护单独的规则"。
这次的方案来自 IETF 的 AI Preferences(AIPREF)工作组讨论。具体文档是 draft-kelley-aipref-training-preference-signal-00,作者是 Anthropic 的标准技术负责人 Kevin Kelley,日期 2026 年 10 月 30 日,2027 年 5 月 3 日到期。要注意:IETF datatracker 页面写得很清楚,这是一份个人提交的草案,"未经 IETF 背书,在标准流程里没有正式地位"。也就是说,四家是先承诺了,标准还没定。
要点:一组规则怎么写、怎么理解
草案里的示例长这样:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
意思是:除了 /press-kit/ 目录允许用于训练,其它路径都表达"不同意训练"。几个关键规则:
- 不加新语法:沿用 RFC 9309(robots.txt 协议)原有的路径匹配和"最长匹配优先",老的解析器遇到它,就当成一个不认识的 User-Agent 直接忽略,不会误伤。
- 通配符不算数:草案明确规定
User-Agent: *的规则不能被解释成对这个 token 的表态。换句话说,你现在全站Disallow: /,对训练这件事也等于"什么都没说"。 - 管的是用途,不是抓取:它只表达"能不能拿去训练",不是爬虫指令。想让某个爬虫别来抓,还得按它的名字单独写。
- 以抓取时为准:偏好按内容被抓取时生效的 robots.txt 来算,草案没说已经抓过的旧数据怎么办。
- "训练"的定义:引用 AIPREF 词汇草案,指"用内容去修改生成式 AI 模型的参数"。只做分类、排序、打分的模型不算;回答时实时检索引用(grounding)也不改参数,所以同样不在范围内。
四家的落地节奏并不一样
- Microsoft:日期最明确,2027 年 2 月 1 日开始在抓取时识别。它还把"训练"和"引用"(grounding)拆成两个设置,页面级可以用 meta 标签或
X-Robots-Tag单独控制;2027 年 3 月 1 日之后,旧的 NoArchive / NoCache 不再被当作 AI 偏好(据 PPC Land 对 Bing 博客的整理)。 - Google:博客说 2027 年支持,爬虫文档里写的是 2027 年初。规则是:如果你用这个 token 拒绝训练、又没单独写 Google-Extended,Google 就按"禁用了 Google-Extended"处理。按 Google-Extended 现有文档,它同时管 Gemini 的训练和联网引用,所以这样做可能连 Gemini 回答里的引用也一起退出了。Google 博客也提到,明确允许 Google-Extended 的网站才有资格通过 grounding 出现在 Gemini Apps 的回答里。它不影响 Google 搜索收录。
- OpenAI:"未来几个月"实现,现有的 GPTBot 等规则继续有效,实现细节之后另发公告。值得留意的是,OpenAI 的措辞是"foundational generative AI training","foundational"是否会把范围收窄,目前还不清楚。
- Anthropic:Kelley 在邮件里说公司"已经开始实现",但没给上线时间,并提醒随着标准演进,解读方式可能会变。
另外,Meta、Amazon、Apple 都没有出现在这次的承诺名单里。
对开发者意味着什么
- 省事,但不是万能开关。以后一条规则能覆盖多家,维护成本确实降了;但它是自愿遵守的偏好信号,草案本身没有强制机制。
- 训练和曝光要权衡。尤其是 Google 这边,拒绝训练可能连带影响 Gemini 引用,想"不让训练、但希望被引用"的站点,需要额外写 Google-Extended 的 Allow 规则来覆盖。
- 现在加不会出错。老解析器会忽略这组规则,现有爬虫规则也照旧,所以提前写上没有副作用,只是暂时还没人真正读它。
实操建议
- 先看看自己站点的 robots.txt。如果只有
User-agent: *一组规则,那你对 AI 训练目前是"未表态"状态。 - 想拒绝训练:加一组
User-Agent: __usage_ai-training+Disallow: /,需要开放的目录再用Allow单独放行。 - 想拒绝训练但保留 Gemini 引用:在上面基础上,再单独写一组
User-agent: Google-Extended+Allow: /(Google 把专属 token 视为更具体的规则)。 - 别删旧规则:GPTBot、ClaudeBot、Google-Extended 等现有写法各家都说会继续认。
- 用 Bing 且依赖 NoArchive / NoCache 做 AI 限制的站点,记得在 2027 年 3 月 1 日前换成新的页面级设置。
小杜点评
从做模型的人的角度看,这件事的意义不在技术——这组规则简单到几乎没有技术含量——而在于四家第一次对"训练数据的退出信号"用了同一种写法,而且把"能不能抓"和"能不能训练"正式分开了。数据团队以后做语料清洗,大概率要把这个 token 纳入数据来源合规检查,并记录抓取时的 robots.txt 快照,因为草案就是按抓取时刻来认定偏好的。
但也别高估它:标准还只是个人草案,最早的生效日期在 2027 年,Google 又把训练和引用绑在一起,站长要自己算清楚曝光和数据授权的账。我的建议是,有自己博客的朋友现在就可以把这组规则加上,成本几乎为零;至于要不要拒绝训练,看你更在意内容被学走,还是更在意在 AI 回答里被看见。
参考来源
- OpenAI:Making it easier for websites to express AI training preferences(2026-10-30)
- Google Search Central Blog:Supporting a shared AI training control for websites(2026-10-30)
- IETF Datatracker:draft-kelley-aipref-training-preference-signal-00
- The Verge:The biggest names in AI are backing a new way to opt out of scraping
- PPC Land:Google, Microsoft, OpenAI and Anthropic back one AI training opt-out(2026-10-31,含 Microsoft 时间表整理)