Google DeepMind 发布了 Gemini 3.1 Flash Live,并将其定位为公司当前质量最高的音频与语音模型。该模型强调更低延迟、更自然的节奏和更稳定的实时对话能力,目标是让语音优先的 AI 交互更接近自然交流。
Google 表示,开发者可通过 Google AI Studio 中的 Gemini Live API 使用这款模型,企业则可以把它用于客户服务等语音场景。普通用户也会在 Search Live 和 Gemini Live 中接触到这项能力,覆盖范围已扩展至 200 多个国家和地区。
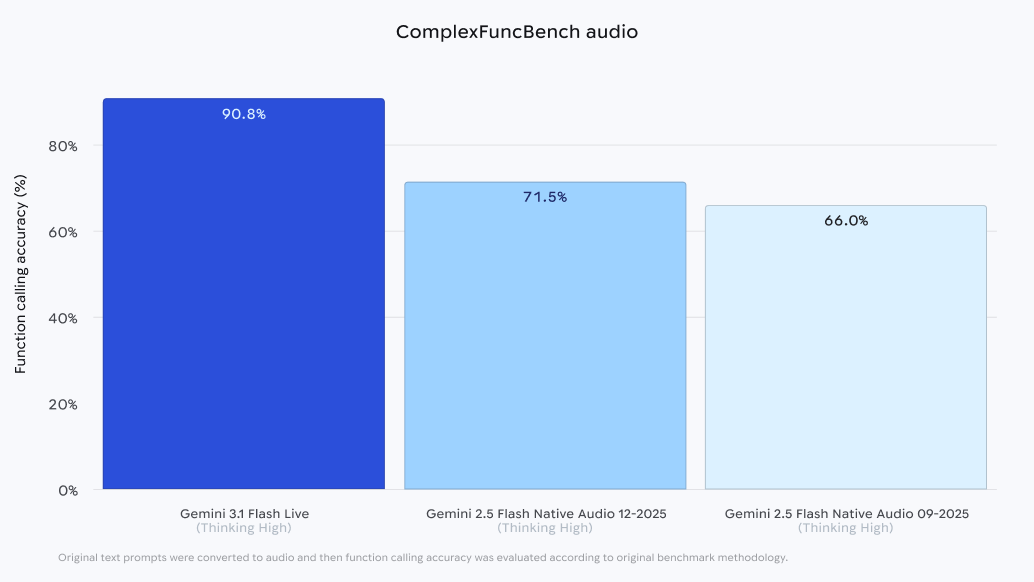
从官方披露的指标看,Gemini 3.1 Flash Live 重点提升了复杂任务处理能力。Google 称其在 ComplexFuncBench Audio 这类多步骤函数调用语音基准上表现更强,也在 Scale AI 的 Audio MultiChallenge 上拿到 36.1% 的成绩,且测试重点包括复杂指令遵循、长链路推理以及现实对话中的打断与停顿处理。
Google 将这次更新描述为推进实时对话能力的重要一步。对于希望构建语音代理、客服系统和多轮语音应用的团队来说,模型的稳定性、自然度和指令执行可靠性,通常比单纯的演示效果更关键,而这正是 3.1 Flash Live 这次主打的方向。
随着语音交互重新成为 AI 产品竞争焦点,Google 也在把这类能力更快推向开发者和终端产品。Gemini 3.1 Flash Live 的意义,不只是把回答说出来,而是试图让模型在真实交流中更懂语气、更少延迟、也更能完成复杂任务。